

تجزیهٔ مقادیر تکین یا همان SVD احتمالاً پرکاربردترین ایدهٔ جبر خطی عددی است. فشردهسازی، حذف نویز، سیستمهای پیشنهاددهنده، PCA؛ پشت خیلی از اینها یک SVD نشسته است. پس وقتی از ماتریس به تانسور میرسیم، سؤال طبیعی این است: آیا تانسورها هم SVD دارند؟
چند نسخه دارند و هیچکدام بینقص نیست. تجزیهٔ تاکر، وقتی با HOSVD محاسبه شود، ماتریسهای عامل متعامد میدهد، اما تانسور هستهاش پُر است، نه قطری. تجزیهٔ CP جمعی تمیز از جملههای رتبهیک میدهد، اما محاسبهاش سخت است و عاملهایش متعامد نیستند. من در پایاننامه روی گزینهٔ سومی کار کردم که کیلمر و مارتین (۲۰۱۱) معرفی کردند: ضرب t و تجزیهٔ t-SVD که از دل آن بیرون میآید. جذابیتش این است که تقریباً عین همان SVD ماتریسی آشنا رفتار میکند و سریع هم هست.
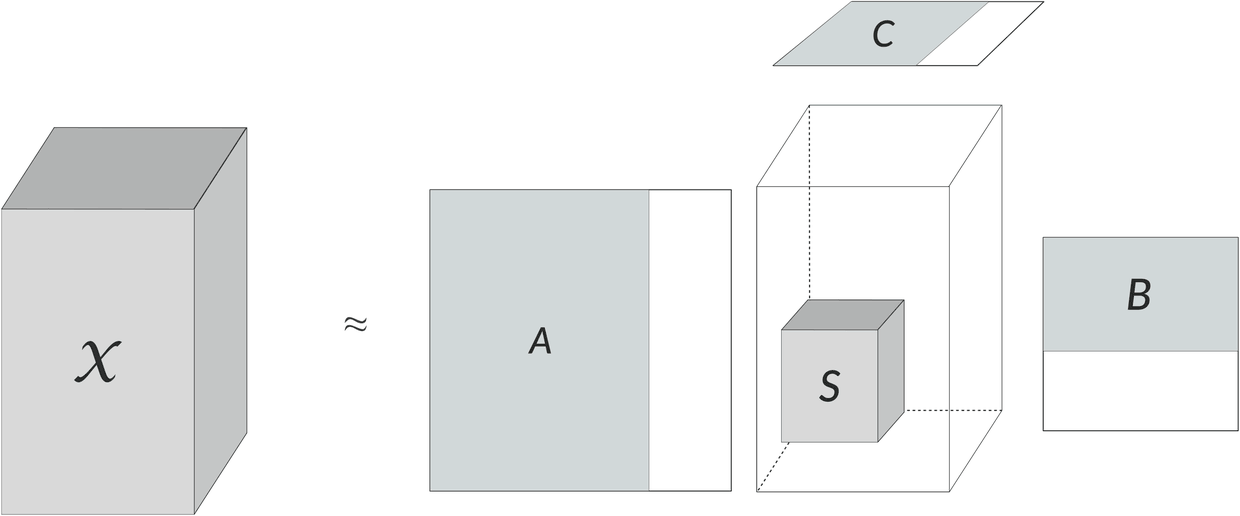
تجزیهٔ تاکر: عاملهای متعامد، اما هستهٔ پُر.
ضرب t در یک نگاه
یک تانسور مرتبهٔ سه را مثل دستهای از ماتریسها ببینید؛ همان اسلایسهای روبهرو. برای ضرب دو دسته از این ماتریسها، ضرب t از اسلایسهای تانسور اول یک ماتریس بلوکی چرخشی (block-circulant) میسازد. ستون بلوکی اولش اسلایسها را به ترتیب زیر هم دارد و هر ستون بعدی همان ستون قبلی است که یک بلوک پایین رفته و بلوک آخرش به بالا برگشته است.
این ماتریس بلوکی در تانسور دوم ضرب میشود، که اسلایسهایش را زیر هم چیدهایم، و حاصل دوباره به شکل دستهای از ماتریسها تا میخورد. به زبان نماد: A ∗ B = fold(bcirc(A) · unfold(B)).
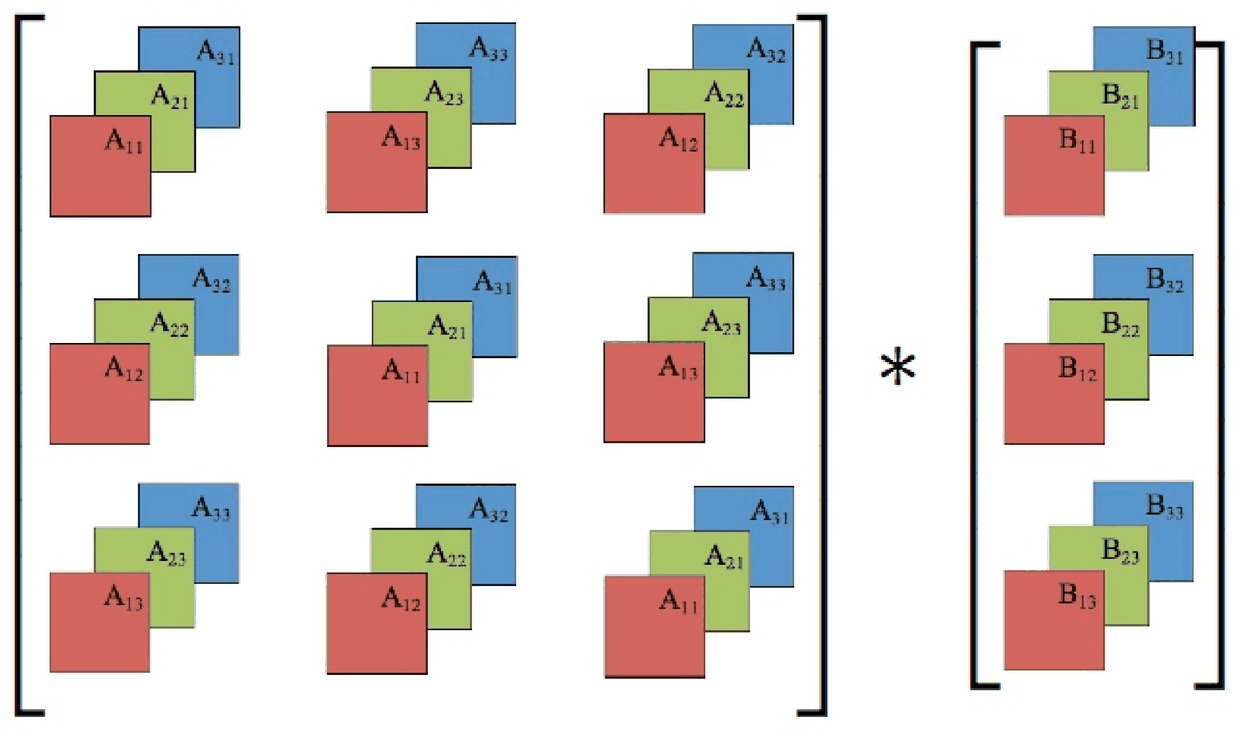
ماتریس بلوکی چرخشی پشت ضرب t.
به این شکل، ضرب پرهزینه به نظر میرسد. ماتریس بلوکی چرخشی n3 برابر خود تانسور درایه دارد و اگر تانسور دوم n2×l×n3 باشد، ضرب مستقیم O(n1n2l n3²) هزینه دارد.
چرا در عمل ارزان است؟
ماتریسهای چرخشی ویژگی خوبی دارند: تبدیل فوریهٔ گسسته قطریشان میکند. ماتریس بلوکی چرخشی هم با همین تبدیل بلوکقطری میشود. پس اگر از هر دو تانسور در راستای مُد سوم FFT بگیریم، ضرب t به n3 ضرب ماتریسی معمولی و مستقل تبدیل میشود، یکی برای هر اسلایس روبهرو. یک FFT معکوس هم ما را برمیگرداند.
هزینهٔ تبدیلها O((n1n2 + n2l + n1l) n3 log n3) است، n3 ضرب اسلایسی روی هم O(n1n2l n3) هزینه دارند و میشود آنها را موازی انجام داد. برای دادههای حقیقی یک صرفهجویی دیگر هم هست: ضرایب فوریه بهصورت جفتهای مزدوج مختلط میآیند، پس کافی است تقریباً نیمی از اسلایسها را حساب کنیم و بقیه را با مزدوج گرفتن پر کنیم.
t-SVD؛ یک SVD برای هر اسلایس
با داشتن ضرب t، تجزیهٔ t-SVD یک تانسور را به شکل A = U ∗ S ∗ VT مینویسد که در آن U و V تانسورهای متعامدند و S f-قطری است؛ یعنی همهٔ اسلایسهای روبهروی S ماتریس قطریاند. دستورش کوتاه است:
- از A در راستای مُد سوم FFT بگیرید.
- برای هر اسلایس روبهرو یک SVD معمولی حساب کنید.
- از عاملها FFT معکوس بگیرید.
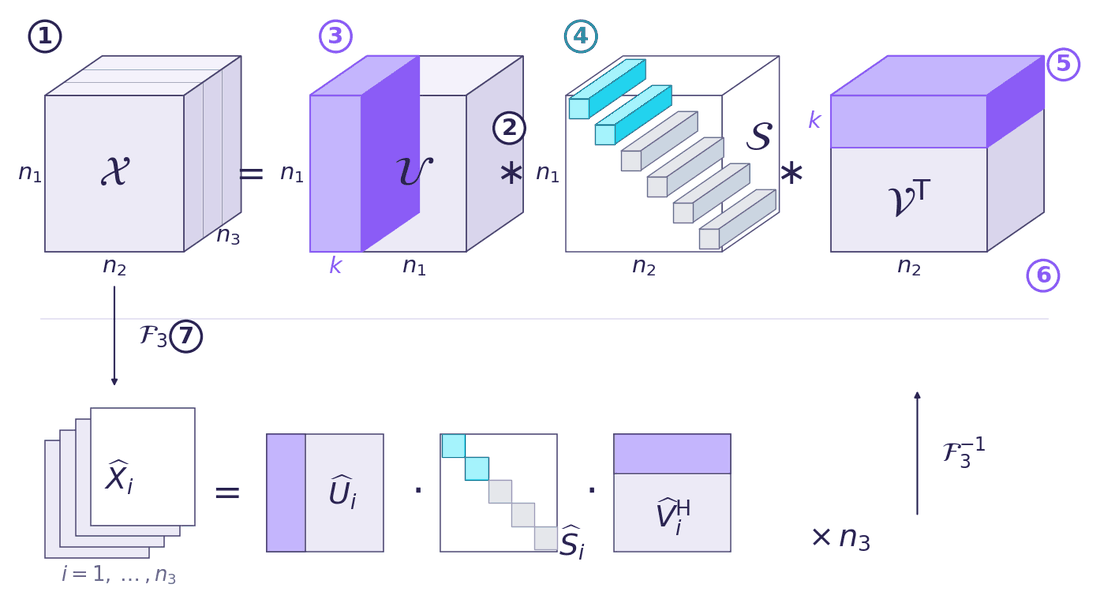
شمای t-SVD. رنگهای بنفش و فیروزهای بخشهایی را نشان میدهند که در برش با رتبهٔ k نگه داشته میشوند؛ شمارهها پایینتر توضیح داده شدهاند.
هر شکل در این تصویر معنای مشخصی دارد:
- X تانسور داده است، با ابعاد n1×n2×n3. وجه جلویی اسلایس روبهروی اول است و خطهای کمرنگ پشت آن، بقیهٔ اسلایسها در راستای مُد سوماند. وقتی در قسمت چهارم تصویرها را طبقهبندی میکنم، هر تصویر یک اسلایس جانبی (n1×1×n3) است و n2 تعداد نمونههاست.
- ∗ همان ضرب t است که بالاتر توضیح دادم، نه ضرب معمولی ماتریسها. همهٔ نمادهای این شکل تانسورند و هر ضرب در راستای مُد سوم انجام میشود.
- U (n1×n1×n3) متعامد است، یعنی UT ∗ U تانسور همانی است. اسلایسهای جانبیاش نقش بردارهای تکین چپ را دارند و بلوک بنفش k تای اول آنهاست؛ پایهای که در تجزیهٔ بریدهشده نگه داشته میشود.
- S (n1×n2×n3) f-قطری است. هر اسلایس روبهرویش یک ماتریس قطری است، پس تنها درایههای غیرصفر تیوبهاییاند که روی قطر از جلو به عقب میروند. این تیوبهای تکین جای مقادیر تکین را میگیرند. k تای اول (فیروزهای) نگه داشته و خاکستریها کنار گذاشته میشوند.
- VT (n2×n2×n3) ترانهادهٔ t یک تانسور متعامد V است: هر اسلایس روبهرو ترانهاده میشود و ترتیب اسلایسهای ۲ تا n3 برعکس. k اسلایس افقی اولش (بنفش) ترانهادهٔ t همان k اسلایس جانبی اول V است. اگر این بخش را ستونبهستون بخوانیم و در تیوبهای تکین ضرب کنیم، مختصات هر نمونه در پایهٔ نگهداشتهشده به دست میآید.
- k رتبهٔ برش است. اگر فقط بخشهای رنگی را نگه داریم، X ≈ Uk ∗ Sk ∗ VkT به دست میآید؛ بهترین تقریب در نرم فروبنیوس در میان تانسورهایی با رتبهٔ تیوبی حداکثر k.
- F3 تبدیلی در راستای مُد سوم است: FFT برای t-SVD و DCT برای tc-SVD. بعد از آن هر اسلایس روبهرو جداگانه با یک SVD معمولی تجزیه میشود، X̂i = Ûi Ŝi V̂iH برای i از ۱ تا n3، و در همهٔ اسلایسها همان برش اعمال میشود. تبدیل معکوس عاملها را دوباره به U، S و V برمیگرداند.
این هم نسخهٔ کامل و آزمودهشده با NumPy. تنها بخش ظریف، حلقهٔ دوم است: برای ورودی حقیقی، اسلایسهای نیمهٔ دوم باید مزدوج مختلط نیمهٔ اول باشند، وگرنه خروجی FFT معکوس حقیقی نمیشود.
import numpy as np

def t_product(A, B):
    Af, Bf = np.fft.fft(A, axis=2), np.fft.fft(B, axis=2)
    return np.real(np.fft.ifft(np.einsum("ijk,jlk->ilk", Af, Bf), axis=2))

def t_transpose(A):
    At = np.transpose(A, (1, 0, 2))
    return np.concatenate([At[:, :, :1], At[:, :, :0:-1]], axis=2)

def t_svd(A):
    n1, n2, n3 = A.shape
    Af = np.fft.fft(A, axis=2)
    Uf = np.zeros((n1, n1, n3), complex)
    Sf = np.zeros((n1, n2, n3), complex)
    Vf = np.zeros((n2, n2, n3), complex)
    half = n3 // 2 + 1
    for k in range(half):                      # only half the slices are needed...
        u, s, vh = np.linalg.svd(Af[:, :, k])
        Uf[:, :, k], Vf[:, :, k] = u, vh.conj().T
        Sf[:len(s), :len(s), k] = np.diag(s)
    for k in range(half, n3):                  # ...the rest are complex conjugates
        Uf[:, :, k] = Uf[:, :, n3 - k].conj()
        Sf[:, :, k] = Sf[:, :, n3 - k].conj()
        Vf[:, :, k] = Vf[:, :, n3 - k].conj()
    back = lambda T: np.real(np.fft.ifft(T, axis=2))
    return back(Uf), back(Sf), back(Vf)

A = np.random.rand(6, 5, 4)
U, S, V = t_svd(A)
print(np.allclose(A, t_product(t_product(U, S), t_transpose(V))))   # True
برش؛ بخشی که برای یادگیری مهم است
درست مثل ماتریسها، میشود فقط k اسلایس جانبی اول U و V و k تیوب قطری اول S را نگه داشت. کیلمر و مارتین نشان دادند که نتیجه، بهترین تقریب در نرم فروبنیوس در میان تانسورهایی با رتبهٔ تیوبی حداکثر k است؛ همتای تانسوری قضیهٔ اکارت-یانگ. همین ویژگی t-SVD را برای فشردهسازی مفید میکند و همانطور که در قسمت چهارم خواهیم دید، برای طبقهبندی هم: چند اسلایس جانبی از U همان فضای ویژگیای میشود که در آن یاد میگیریم.
فرضی که پنهان مانده
یک نکتهٔ ظریف هست که درکش برای خودم هم زمان برد. ساختار چرخشی یک فرض در خودش دارد: بُعد سوم دور خودش میچرخد، یعنی اسلایس آخر همسایهٔ اسلایس اول حساب میشود. برای بعضی دادهها این بیضرر است. اما برای تصویر و سیگنال، کمی شبیه این است که فرض کنیم لبهٔ راست یک عکس ادامهٔ لبهٔ چپش است.
همین مشاهده نقطهٔ شروع سهم خودم در این پژوهش بود: tc-SVD، که بهجای این چرخش از یک آینه استفاده میکند. موضوع قسمت بعد همین است.
بخشی از مجموعهای بر اساس پایاننامهٔ کارشناسی ارشد من، «یادگیری کلانداده با نمایش تانسوری»، به راهنمایی دکتر منصور رزقی در دانشگاه تربیت مدرس.
این یادداشت به انگلیسی هم منتشر شده است: نسخهٔ انگلیسی.