
 مهدی مولوی
تجزیهٔ CP تانسور را جمع چند تانسور رتبهیک مینویسد؛ تجزیهٔ تاکر آن را به یک تانسور هستهٔ کوچک و یک ماتریس عامل برای هر مُد میشکند و معمولاً با HOSVD محاسبه میشود؛ t-SVD هم یک تانسور مرتبهٔ سه را با ضرب t به دو تانسور متعامد و یک تانسور افقطری تجزیه میکند. CP فشردهترین و تفسیرپذیرترینِ این سه است اما برازشش سخت است، تاکر عاملهای متعامد میدهد اما هستهاش پُر است، و t-SVD برش بهینهٔ SVD ماتریسی را حفظ میکند، به این قیمت که با مُد سوم رفتار ویژهای دارد.
هر سه میخواهند برای تانسور همان کاری را بکنند که SVD برای ماتریس میکند و هیچکدام همهٔ ویژگیهایش را نگه نمیدارند. در ادامه X تانسوری با ابعاد I×J×K است. اگر مُد، ماتریسیسازی و ضرب مُد n برایتان تازه است، از تانسور چیست؟ شروع کنید.
CP: جمع تانسورهای رتبهیک
تجزیهٔ CP، که با نامهای CANDECOMP و PARAFAC هم شناخته میشود، تانسور را با R جملهٔ رتبهیک تقریب میزند که هرکدام ضرب بیرونی سه بردار است:
X ≈ ∑r=1..R ar ∘ br ∘ cr
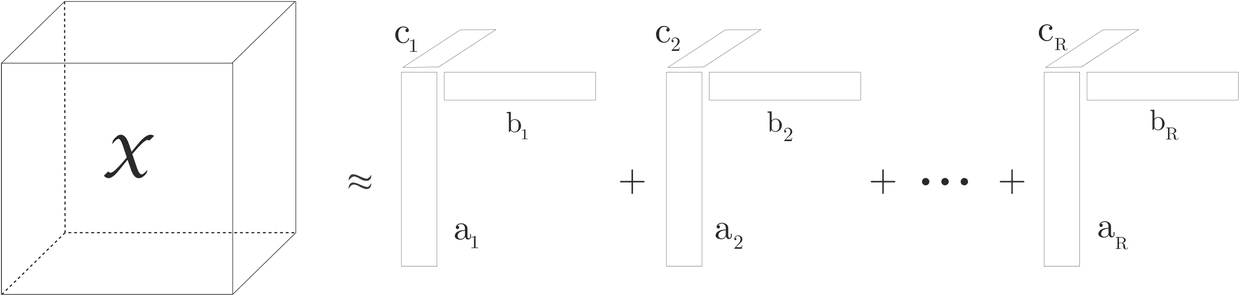
تجزیهٔ CP: جمع R تانسور رتبهیک.
حاصل سه ماتریس عامل است که هرکدام R ستون دارد؛ روی هم R(I + J + K) عدد، که آن را فشردهترین مدل از این سه میکند. با شرایطی نهچندان سختگیرانه، این تجزیه صرفنظر از مقیاس و ترتیب جملهها یکتاست؛ برای همین مؤلفههایش را اغلب میشود بهعنوان بخشهای معنادار داده تفسیر کرد. در عوض، عاملها متعامد نیستند؛ راهحل بستهای مثل SVD برایش وجود ندارد و معمولاً با روشهای تکراری مثل کمترین مربعات متناوب (ALS) برازش میشود؛ انتخاب R خودش مسئلهٔ سختی است؛ و بهترین تقریب با رتبهٔ R همیشه وجود ندارد، که برازش را از نظر عددی حساس میکند.
تاکر و HOSVD: یک هسته و یک پایه برای هر مُد
تجزیهٔ تاکر از یک تانسور هستهٔ کوچک G با ابعاد R1×R2×R3 و یک ماتریس عامل برای هر مُد استفاده میکند که با ضرب مُد n کنار هم قرار میگیرند:
X ≈ G ×1 A ×2 B ×3 C
روش استاندارد محاسبهاش HOSVD یا SVD مرتبهبالاست. ستونهای A همان R1 بردار تکین چپ اولِ ماتریسیشدهٔ مُد اولاند، B و C هم به همین ترتیب از دو ماتریسیشدهٔ دیگر میآیند و هسته از این رابطه به دست میآید:
G = X ×1 AT ×2 BT ×3 CT
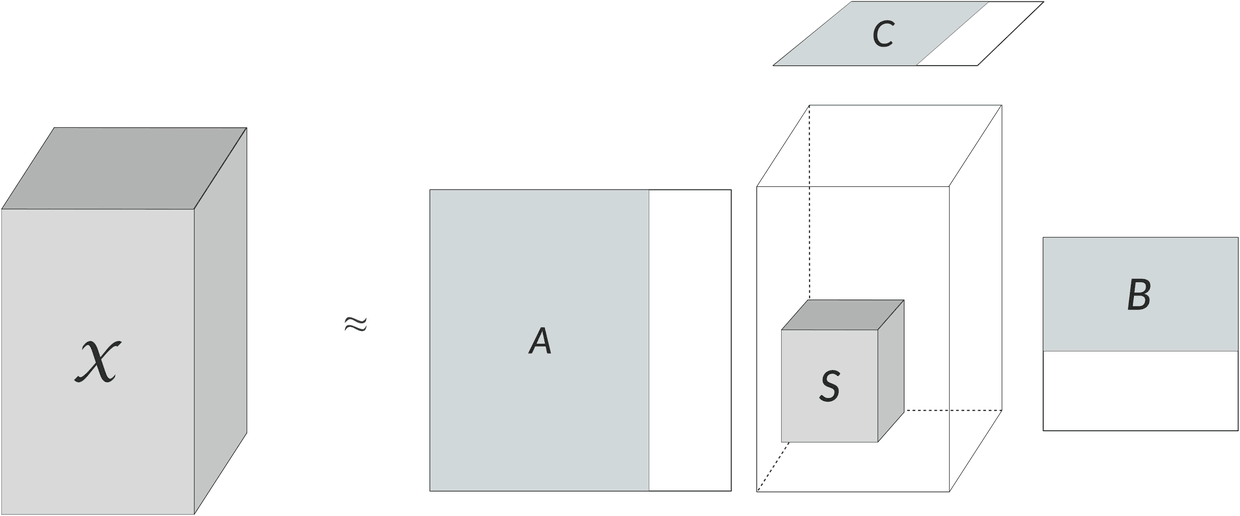
تجزیهٔ تاکر (HOSVD): عاملهای متعامد، اما هستهٔ پُر (در شکل با S نشان داده شده).
نتیجه برای هر مُد یک پایهٔ متعامد و یک رتبهٔ فشردهسازی جداگانه است، برای تانسوری با هر مرتبهای کار میکند و چیزی جز SVD ماتریسی لازم ندارد. در عوض هسته پُر است، نه قطری، پس هر مؤلفه با همهٔ مؤلفههای دیگر درگیر است؛ اندازهٔ هسته به شکل R1R2R3 رشد میکند؛ و HOSVD بریدهشده در حالت کلی بهترین تقریب با همان رتبهٔ چندخطی نیست، فقط تقریب خوبی است که روشهای تکراری مثل HOOI میتوانند بهترش کنند.
t-SVD: همان SVD ماتریسی در جبری دیگر
t-SVD (کیلمر و مارتین، ۲۰۱۱) بهجای شکل عاملها، خود ضرب را عوض میکند. با ضرب t، تانسور را به شکل X = U ∗ S ∗ VT مینویسد که در آن U و V متعامدند و S افقطری است.
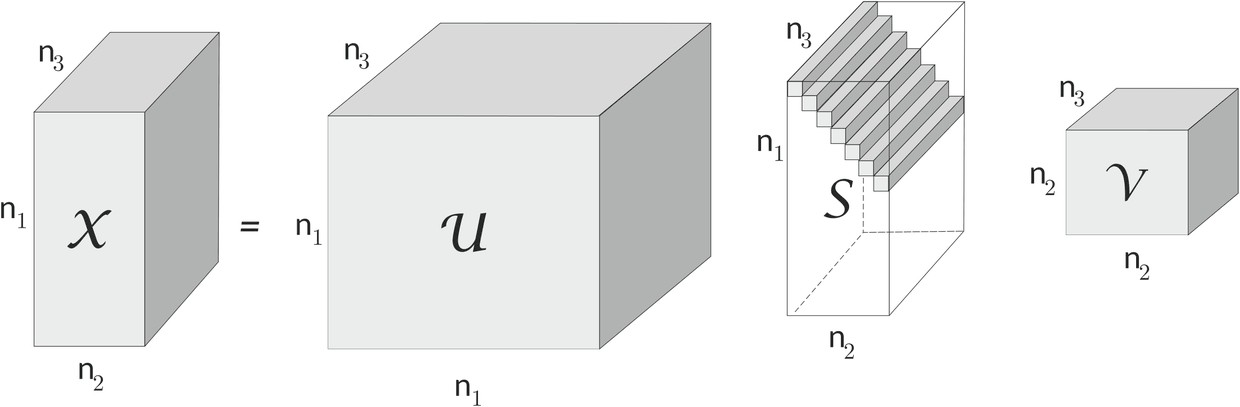
t-SVD کامل یک تانسور n1×n2×n3: ابعاد U برابر n1×n1×n3 و ابعاد V برابر n2×n2×n3 است و S افقطری است.
نتیجه تعامد است، عامل میانیای شبیه ماتریس قطری و برش بهینه: نگه داشتن k تیوب تکین، بهترین تقریب در نرم فروبنیوس را در میان تانسورهایی با رتبهٔ تیوبی حداکثر k میدهد. محاسبهاش هم ارزان است، چون بعد از FFT در راستای مُد سوم به K تجزیهٔ SVD ماتریسی مستقل تبدیل میشود که برای دادهٔ حقیقی فقط حدود نیمی از آنها لازم است و موازی اجرا میشوند. در عوض، برای تانسورهای مرتبهٔ سه تعریف شده است؛ با مُد سوم متفاوت از دو مُد دیگر رفتار میکند، پس جهت تانسور و ترتیب اسلایسها مهم است؛ و FFT در همان مُد یک فرض تناوبی با خودش میآورد. tc-SVD همین جبر را نگه میدارد، اما FFT را با DCT و چرخش را با آینه عوض میکند.
مقایسهٔ کنار هم
| ویژگی | CP | تاکر (HOSVD) | t-SVD |
|---|---|---|---|
| مدل | جمع R تانسور رتبهیک | هسته ضرب در یک ماتریس عامل برای هر مُد | U ∗ S ∗ VT با ضرب t |
| عاملهای متعامد | ندارد | دارد | دارد، در چارچوب ضرب t |
| عامل میانی | ندارد (فقط وزنهای اختیاری) | هستهٔ پُر | S افقطری |
| مفهوم رتبه | رتبهٔ CP | رتبهٔ چندخطی | رتبهٔ تیوبی |
| روش محاسبه | برازش تکراری، مثلاً ALS | SVD هر ماتریسیشده | FFT، یک SVD برای هر اسلایس روبهرو، FFT معکوس |
| برش بهینه | ممکن است وجود نداشته باشد | خوب، اما در حالت کلی بهینه نیست | بهینه برای رتبهٔ تیوبی |
| حافظه برای I×J×K | R(I + J + K) | R1R2R3 + IR1 + JR2 + KR3 | k(I + J + 1)K |
| مرتبهٔ تانسور | دلخواه | دلخواه | سه |
| رفتار با مُدها | یکسان | یکسان | مُد سوم ویژه است |
کدام را کِی انتخاب کنیم؟
- CP وقتی چند مؤلفهٔ تفسیرپذیر و فشردهترین مدل را میخواهید و برازش تکراری و جستوجو برای R برایتان مشکلی نیست.
- تاکر یا HOSVD وقتی مُدهای مختلف به مقدار فشردهسازی متفاوتی نیاز دارند، وقتی برای هر مُد یک پایهٔ متعامد میخواهید یا وقتی تانسور بیش از سه مُد دارد.
- t-SVD وقتی داده بهطور طبیعی دستهای از ماتریسها در یک راستاست، مثل تصویرهایی که هرکدام یک اسلایس جانبیاند یا فریمهایی در طول زمان، و ویژگیهایی شبیه SVD با برش بهینهٔ تضمینشده و کدی ساده و موازی میخواهید.
- tc-SVD در همان موقعیتهای t-SVD، وقتی چرخاندن آن راستا معنایی ندارد؛ مثلاً در سیگنالهایی که ابتدا و انتهایشان به هم ربطی ندارد.
آزمایشهای من چه نشان دادند؟
برندهٔ واحدی در کار نبود. در آزمایشهای خوشهبندی پایاننامه (بهترین NMI، میانگین ده اجرا)، tc-SVD دوسمتی روی ORL و Extended Yale B اول شد، t-SVD دوسمتی روی PIE-pose، و HOSVD روی COIL-100 با ۰٫۷۴۹، جلوتر از NMF و هر دو SVD تانسوری. HOSVD روی Yale B و COIL-100 از t-SVD و tc-SVD سریعتر هم بود. در طبقهبندی، t-SVD و tc-SVD روی MNIST به دقت تقریباً یکسانی، حوالی ۹۷٪، رسیدند. بر اساس ساختار داده و چیزی که از عاملها لازم دارید انتخاب کنید و بعد روی دادهٔ خودتان بسنجید. مبانی این بحث در قسمت اول یادداشتهای تانسوری مفصلتر آمده است.
پرسشهای رایج
آیا HOSVD همان تجزیهٔ تاکر است؟
تاکر نام مدل است: یک تانسور هسته که در راستای هر مُد در یک ماتریس عامل ضرب میشود. HOSVD روش استاندارد محاسبهٔ آن است که هر عامل را از SVD ماتریسیشدهٔ متناظر میگیرد.
کدام تجزیه تعمیم واقعی SVD به تانسورهاست؟
هیچکدام همهٔ ویژگیهای SVD ماتریسی را نگه نمیدارد. HOSVD عاملهای متعامد را نگه میدارد اما هستهاش قطری نیست، CP جمع جملههای رتبهیک را نگه میدارد اما تعامد ندارد، و t-SVD با عوض کردن ضرب، هم تعامد و هم برش بهینه را حفظ میکند.
فرق رتبهٔ CP، رتبهٔ چندخطی و رتبهٔ تیوبی چیست؟
رتبهٔ CP کمترین تعداد جملههای رتبهیکی است که جمعشان تانسور را میسازد. رتبهٔ چندخطی چندتاییِ رتبههای ماتریسیشدههای تانسور است که تاکر آن را برش میدهد. رتبهٔ تیوبی تعداد تیوبهای تکین غیرصفر در t-SVD است.
برای دستهای از تصویرها کدام تجزیه مناسبتر است؟
اگر ویژگیهای سریع و شبیه SVD با برش بهینهٔ تضمینشده میخواهید، t-SVD یا tc-SVD با تصویرها بهعنوان اسلایس شروع خوبی است؛ اگر برای هر مُد فشردهسازی جداگانه میخواهید، تاکر. در آزمایشهای خوشهبندی من بهترین روش از یک مجموعهداده به مجموعهٔ دیگر عوض میشد، پس روی دادهٔ خودتان بسنجید.