

Tekil değer ayrışımı (SVD), sayısal lineer cebirin muhtemelen en kullanışlı tek fikridir. Sıkıştırma, gürültü giderme, öneri sistemleri, PCA: perde arkasında çoğu zaman bir SVD vardır. Dolayısıyla matrislerden tensörlere geçtiğinizde akla gelen ilk soru, tensörler için de bir SVD olup olmadığıdır.
Birkaç tane var ve hiçbiri kusursuz değil. HOSVD ile hesaplanan Tucker ayrışımı size ortogonal faktör matrisleri verir, ama çekirdek tensörü köşegen değil, yoğundur. CP ayrışımı rank-bir terimlerin temiz bir toplamını verir, ama hesaplaması zordur ve faktörleri ortogonal değildir. Tezimde, Kilmer ve Martin'in (2011) önerdiği üçüncü bir seçeneği temel aldım: t-çarpımı ve onunla birlikte gelen t-SVD. Onu çekici kılan, zaten bildiğiniz matris SVD'sine neredeyse tıpatıp benzer davranması ve hızlı olmasıdır.
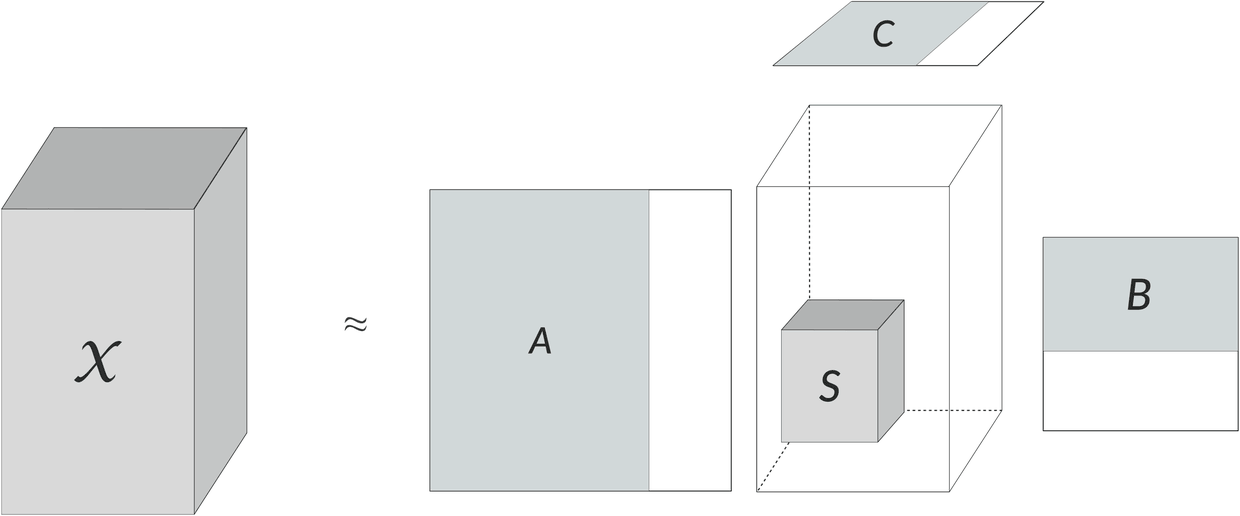
Tucker (HOSVD): ortogonal faktörler, ama yoğun bir çekirdek.
Tek şemada t-çarpımı
Üçüncü mertebeden bir tensörü, ön dilimlerinden oluşan bir matris yığını olarak düşünün. Böyle iki yığını çarpmak için t-çarpımı, ilk tensörün dilimlerinden blok dairesel (block-circulant) bir matris kurar. Bu matrisin ilk blok sütunu dilimleri sırayla içerir; sonraki her sütun, bir öncekinin bir blok aşağı kaydırılmış halidir ve en alttaki blok başa, en üste sarar.
Bu blok matris, dilimleri üst üste dizilerek tek bir uzun matrise dönüştürülmüş ikinci tensörle çarpılır ve sonuç yeniden bir yığına katlanır. Sembollerle: A ∗ B = fold(bcirc(A) · unfold(B)).
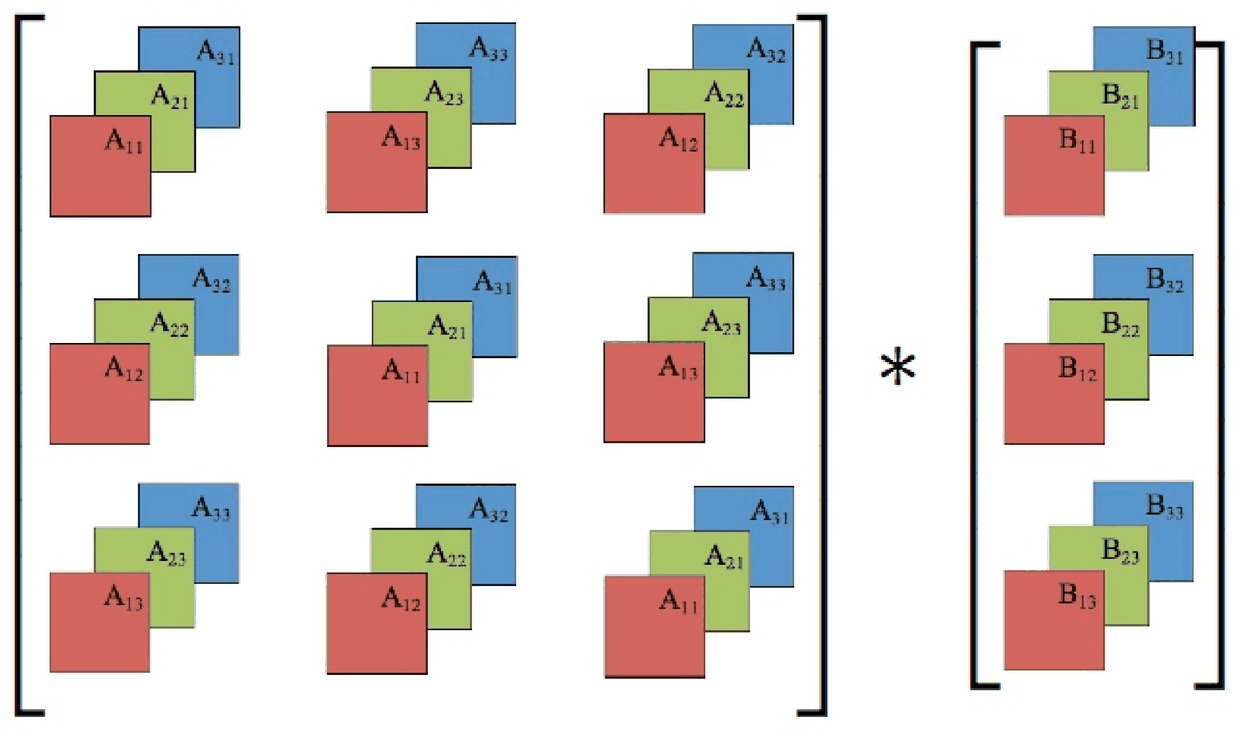
t-çarpımının arkasındaki blok dairesel matris.
Böyle yazılınca pahalı görünür. Blok dairesel matrisin eleman sayısı tensörünkünün n3 katıdır ve n2×l×n3 boyutunda bir ikinci tensör için doğrudan çarpımın maliyeti O(n1n2l n3²) olur.
Aslında neden ucuz
Dairesel matrislerin işe yarar bir özelliği vardır: ayrık Fourier dönüşümü onları köşegenleştirir. Blok dairesel matrisleri ise blok köşegenleştirir. Yani iki tensörün de üçüncü modu boyunca FFT alırsanız t-çarpımı, her ön dilim için bir tane olmak üzere n3 adet sıradan ve birbirinden bağımsız matris çarpımına ayrılır. Ters FFT sizi geri götürür.
Dönüşümlerin maliyeti O((n1n2 + n2l + n1l) n3 log n3), n3 dilim çarpımının toplam maliyeti O(n1n2l n3) olur ve bu çarpımlar paralel çalışabilir. Gerçel değerli veride bir tasarruf daha var: Fourier katsayıları karmaşık eşlenik çiftler halinde gelir, bu yüzden dilimlerin yalnızca yaklaşık yarısını hesaplamanız ve gerisini eşlenik alarak doldurmanız yeterlidir.
t-SVD: her dilim için bir SVD
t-çarpımı elimizdeyken t-SVD bir tensörü A = U ∗ S ∗ VT biçiminde yazar; burada U ve V ortogonal tensörler, S ise f-köşegendir, yani S'nin her ön dilimi köşegen bir matristir. Tarif kısadır:
- A'nın üçüncü modu boyunca FFT'sini alın.
- Her ön dilimin sıradan SVD'sini hesaplayın.
- Çarpanların ters FFT'sini alın.
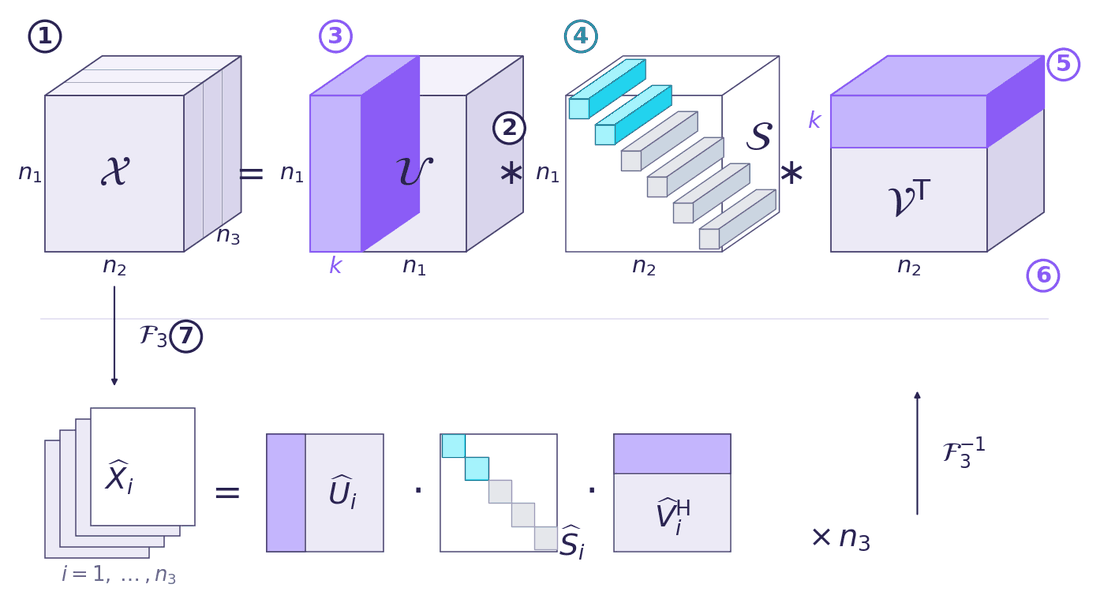
Açıklamalı t-SVD. Mor ve camgöbeği, k ranklı bir kesmenin koruduğu kısımları gösterir; numaralar aşağıda açıklanıyor.
Şemadaki her şeklin belirli bir anlamı var:
- X, n1×n2×n3 boyutundaki veri tensörüdür. Ön yüz onun ilk ön dilimidir; arkasındaki soluk çizgiler de üçüncü mod boyunca uzanan diğer dilimlerdir. Dördüncü bölümde görüntüleri sınıflandırırken her görüntü bir yanal dilimdir (n1×1×n3); dolayısıyla n2 örnek sayısıdır.
- ∗, sıradan matris çarpımı değil, yukarıda anlatılan t-çarpımıdır. Şemadaki her sembol bir tensördür ve her çarpım üçüncü mod boyunca işler.
- U (n1×n1×n3) ortogonaldir: UT ∗ U birim tensördür. Yanal dilimleri sol tekil vektörlerin rolünü üstlenir; mor blok bunların ilk k tanesidir, yani kesilmiş bir ayrışımın koruduğu tabandır.
- S (n1×n2×n3) f-köşegendir. Her ön dilimi köşegen bir matristir; bu yüzden sıfırdan farklı girdiler yalnızca köşegen boyunca önden arkaya uzanan tüplerdir. Bu tekil tüpler tekil değerlerin yerini alır. İlk k tanesi (camgöbeği) korunur, gri olanlar atılır.
- VT (n2×n2×n3), ortogonal bir V tensörünün t-devriğidir: her ön dilimin devriği alınır, ardından 2'den n3'e kadar olan dilimlerin sırası ters çevrilir. İlk k yatay dilimi (mor), V'nin ilk k yanal diliminin t-devrikleridir. Sütun sütun okunup tekil tüplerle ölçeklendiğinde, her örneğin korunan tabandaki koordinatlarını verirler.
- k, kesme rankıdır. Yalnızca renkli kısımları tutmak X ≈ Uk ∗ Sk ∗ VkT yaklaşımını verir; bu, tüp rankı en fazla k olan tensörler arasında Frobenius normuna göre en iyi yaklaşımdır.
- F3, üçüncü mod boyunca uygulanan bir dönüşümdür: t-SVD için FFT, tc-SVD için DCT. Dönüşümden sonra her ön dilim kendi başına sıradan bir SVD ile çarpanlarına ayrılır: X̂i = Ûi Ŝi V̂iH, i = 1, …, n3 için; her dilimde aynı kesme uygulanır. Ters dönüşüm, üst üste dizilmiş çarpanları yeniden U, S ve V'ye çevirir.
İşte eksiksiz ve test edilmiş bir NumPy sürümü. Tek incelikli kısım ikinci döngü: gerçel girdide ortanın ötesindeki dilimler ilk yarının karmaşık eşlenikleri olmalıdır, yoksa ters FFT gerçel bir sonuç vermez.
import numpy as np

def t_product(A, B):
    Af, Bf = np.fft.fft(A, axis=2), np.fft.fft(B, axis=2)
    return np.real(np.fft.ifft(np.einsum("ijk,jlk->ilk", Af, Bf), axis=2))

def t_transpose(A):
    At = np.transpose(A, (1, 0, 2))
    return np.concatenate([At[:, :, :1], At[:, :, :0:-1]], axis=2)

def t_svd(A):
    n1, n2, n3 = A.shape
    Af = np.fft.fft(A, axis=2)
    Uf = np.zeros((n1, n1, n3), complex)
    Sf = np.zeros((n1, n2, n3), complex)
    Vf = np.zeros((n2, n2, n3), complex)
    half = n3 // 2 + 1
    for k in range(half):                      # only half the slices are needed...
        u, s, vh = np.linalg.svd(Af[:, :, k])
        Uf[:, :, k], Vf[:, :, k] = u, vh.conj().T
        Sf[:len(s), :len(s), k] = np.diag(s)
    for k in range(half, n3):                  # ...the rest are complex conjugates
        Uf[:, :, k] = Uf[:, :, n3 - k].conj()
        Sf[:, :, k] = Sf[:, :, n3 - k].conj()
        Vf[:, :, k] = Vf[:, :, n3 - k].conj()
    back = lambda T: np.real(np.fft.ifft(T, axis=2))
    return back(Uf), back(Sf), back(Vf)

A = np.random.rand(6, 5, 4)
U, S, V = t_svd(A)
print(np.allclose(A, t_product(t_product(U, S), t_transpose(V))))   # True
Kesme: öğrenme için önemli olan kısım
Matrislerde olduğu gibi, U ve V'nin yalnızca ilk k yanal dilimini ve S'nin ilk k köşegen tüpünü tutabilirsiniz. Kilmer ve Martin, sonucun tüp rankı en fazla k olan tensörler arasında Frobenius normuna göre en iyi yaklaşım olduğunu gösterdi; bu, Eckart-Young teoreminin tensördeki karşılığıdır. t-SVD'yi sıkıştırma için ve dördüncü bölümde göreceğimiz gibi sınıflandırma için faydalı kılan da budur: U'nun bir avuç yanal dilimi, içinde öğrendiğiniz özellik uzayı haline gelir.
Gizli varsayım
İşin içinde, farkına varmam biraz zaman alan bir pürüz var. Dairesel yapı bir varsayımı kodlar: üçüncü boyut başa sarar, yani son dilim ilk dilimin komşusu sayılır. Bazı veriler için bu zararsızdır. Görüntüler ve sinyaller için ise bir fotoğrafın sağ kenarının sol kenarından devam ettiğini varsaymaya benzer.
Benim katkım tam da bu gözlemle başlıyor: başa sarmayı bir aynayla değiştiren tc-SVD. Bir sonraki notun konusu o.
Tarbiat Modares Üniversitesinde Dr. Mansoor Rezghi danışmanlığında hazırladığım “Tensör Temsiliyle Büyük Veri Öğrenimi” başlıklı yüksek lisans tezime dayanan serinin bir parçası.
Bu not İngilizce ve Farsça olarak da yayımlandı: İngilizce · Farsça.