
 مهدی مولوی
tc-SVD تجزیهٔ مقادیر تکین برای تانسورهای مرتبهٔ سه است که روی یک ضرب تانسوری مبتنی بر تبدیل کسینوسی، یعنی ضرب tc، ساخته میشود. این روش مرز تناوبی (چرخشی) پنهان در t-SVD را با مرز انعکاسی (آینهای) عوض میکند؛ در نتیجه تبدیل کسینوسی گسسته (DCT) جای FFT را میگیرد و همهٔ محاسبات با اعداد حقیقی انجام میشود. tc-SVD در پایاننامهٔ کارشناسی ارشد مهدی مولوی در دانشگاه تربیت مدرس توسعه یافت؛ ضربی بسیار نزدیک به آن، بر پایهٔ همین تبدیل، در کار کرنفلد، کیلمر و آئرون (۲۰۱۵) هم آمده است.
فرضی که tc-SVD کنار میگذارد
ضرب t که پشت t-SVD است، در راستای مُد سوم یک پیچش چرخشی است. مسئلهٔ رفع ماتی تصویر نشان میدهد چرا این مهم است. پیکسل ماتشده جمع وزنداری از همسایههایش است، yi = ∑j hi−j xj، و نزدیک لبهٔ تصویر این جمع به پیکسلهایی نیاز دارد که بیرون از قاباند. ناچاریم دربارهٔ آنها چیزی فرض کنیم و به این فرض شرط مرزی میگویند.
مرز تناوبی فرض میکند سیگنال تکرار میشود: هرچه از لبهٔ راست بیرون بزند، از لبهٔ چپ برمیگردد. در این حالت ماتریس ماتی چرخشی میشود و FFT همهچیز را سریع حل میکند. ضرب t دقیقاً همین مدل را در راستای مُد سوم تانسور اعمال میکند. مشکل این است که دادهٔ واقعی بهندرت تناوبی است. لبهٔ راست عکس ربطی به لبهٔ چپش ندارد و انتهای یک سری زمانی هم معمولاً ربطی به ابتدایش ندارد. چسباندن این دو به هم پرشی میسازد که هیچوقت در داده نبوده و در بازسازی تصویر معمولاً کنار لبهها اثر ناخواسته به جا میگذارد. انگ، چان و تانگ (۱۹۹۹) نشان دادند که مرز انعکاسی بازسازی بهتری میدهد، با همان هزینهٔ O(n log n).
آینه بهجای چرخش
مرز انعکاسی فرض میکند سیگنال به شکل تصویر آینهای خودش ادامه پیدا میکند: مقدارِ بلافاصله بیرونِ لبه برابر مقدارِ بلافاصله داخلِ آن است و پرش ساختگیای در کار نیست. در این حالت ماتریس ماتی دیگر چرخشی نیست و شکل توپلیتس بهعلاوهٔ هنکل پیدا میکند. برای هستههای متقارن، ماتریسهایی با این شکل با تبدیل کسینوسی گسسته قطری میشوند و هزینهٔ DCT هم O(n log n) است.
ضرب tc و tc-SVD
در پایاننامه این ایده را به تانسورها بردم. بهجای اینکه اسلایسهای روبهرو در یک ماتریس بلوکی چرخشی چیده شوند، در یک ماتریس بلوکی توپلیتس بهعلاوهٔ هنکل قرار میگیرند و DCT در راستای مُد سوم آن را بلوکقطری میکند. ضرب tc دو تانسور سه قدم دارد:
- هر دو تانسور را در راستای مُد سوم به حوزهٔ یک تبدیل مبتنی بر DCT میبریم (خود DCT بههمراه یک مقیاس قطری و یک جابهجایی که با ساختار توپلیتس بهعلاوهٔ هنکل جور درمیآید)؛
- اسلایسهای روبهرویشان را دوبهدو، مثل ماتریسهای معمولی، در هم ضرب میکنیم؛
- حاصل را به فضای اصلی برمیگردانیم.
این ضرب هرچه را برای جبر خطی لازم داریم حفظ میکند: خطی و شرکتپذیر است، عضو همانی و ترانهاده دارد و تانسور متعامد در آن تعریف میشود. اگر DCT به شکل متعامد یکه به کار رود، ضرب در تانسور متعامد نرم فروبنیوس را هم تغییر نمیدهد. تجزیه هم همان الگوی t-SVD را دنبال میکند:
A = U ∗c S ∗c VT
که در آن U و V متعامدند و S افقطری است. در راستای مُد سوم DCT میگیریم، روی هر اسلایس روبهرو یک SVD معمولی اجرا میکنیم و عاملها را برمیگردانیم. با DCT متعامد یکه، اگر فقط k جملهٔ اول را نگه داریم، بهترین تقریب در نرم فروبنیوس در میان تانسورهایی با رتبهٔ حداکثر k تحت همین ضرب به دست میآید؛ همان تضمینی که t-SVD در چارچوب خودش دارد.
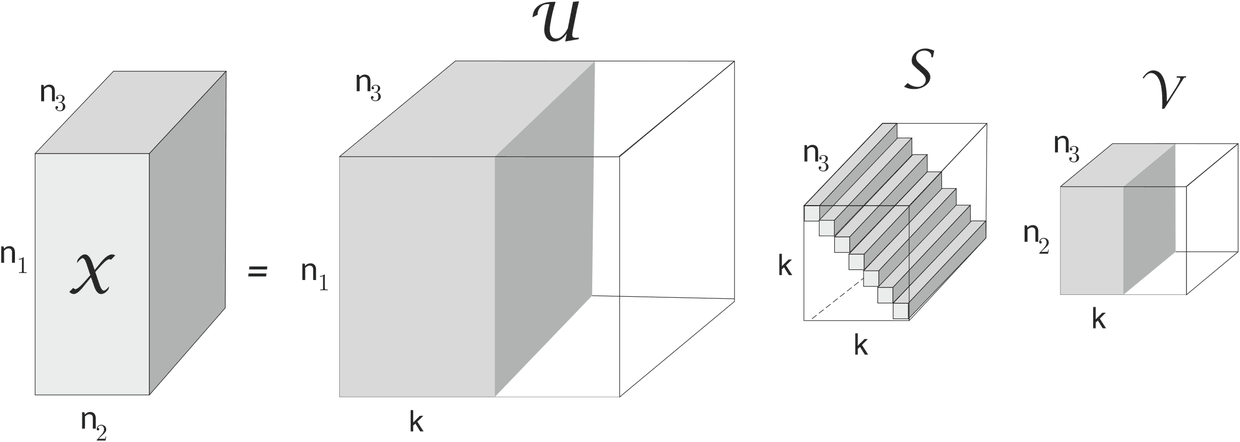
tc-SVD بریدهشده: فقط k اسلایس جانبی از U و V و k تیوب قطری از S نگه داشته میشود.
دو تفاوت عملی با t-SVD از همینجا میآید. عدد مختلط و حسابوکتاب جفتهای مزدوج در کار نیست، و در آزمایشهای من نسخههای مبتنی بر DCT تقریباً در همهٔ مقایسهها سریعتر بودند و اغلب تقریباً نصف زمان را گرفتند. پایاننامه یک راه ارزانتر برای فشردهسازی هم دارد که اصلاً تجزیهٔ کامل را حساب نمیکند: همهٔ اسلایسهای روبهرو را جمع میزنیم، از همین جمع یک SVD میگیریم، k1 بردار تکین چپ و k2 بردار تکین راست را نگه میداریم و هر اسلایس را به یک هستهٔ کوچک k1×k2 فشرده میکنیم.
tc-SVD در پایاننامه به چه کاری آمد؟
- طبقهبندی. هر تصویر یک اسلایس جانبی از تانسور داده است. رویکرد اول، روش کیلمر و همکارانش برای t-SVD را به tc-SVD تعمیم میدهد و یک پایهٔ مشترک از k اسلایس جانبی اول U میسازد. رویکرد دوم، که نوآوری خود پایاننامه است، برای هر کلاس یک پایهٔ tc-SVD جدا میسازد و تصویر آزمون را به کلاسی میدهد که آن را با کمترین باقیمانده بازسازی کند. آزمایشها روی MNIST و مجموعهٔ چهرهٔ CBCL انجام شد.
- خوشهبندی. اجرای k-means روی V بریدهشده، با امکان کوچک کردن از هر دو طرف (برش دوسمتی)، روی ORL، PIE-pose، Extended Yale B و COIL-100.
- fMRI. تفکیک اختلال شناختی خفیف در مرحلهٔ اولیه (eMCI) از افراد سالم با دادههای fMRI حالت استراحت از ADNI (۸۲ آزمودنی)؛ دادهٔ هر فرد ماتریسی از ۱۳۰ نقطهٔ زمانی در ۹۰ ناحیهٔ مغزی بود.
- دادهٔ جریانی. نسخهٔ افزایشی tc-SVD که SVD افزایشی برند (۲۰۰۲) را تعمیم میدهد: اسلایسهای تازه تبدیل میشوند و هر اسلایس روبهرو بهجای محاسبهٔ دوباره، بهروز میشود.
نتیجهها، همانطور که گزارش شد
- روی MNIST و CBCL دقت tc-SVD تقریباً با t-SVD یکی بود (هر دو منحنی MNIST حوالی ۹۷٪) و زمان اجرا حدود نصف.
- در خوشهبندی (بهترین NMI، میانگین ده اجرا)، tc-SVD دوسمتی روی ORL با ۰٫۷۳۰ و روی Extended Yale B با ۰٫۷۹۹ بهترین بود. روی PIE-pose همهٔ نسخههای t-SVD و tc-SVD نزدیک به کامل بودند و t-SVD دوسمتی با ۰٫۹۹۴ کمی جلوتر ایستاد. روی COIL-100، روش HOSVD با ۰٫۷۴۹ و NMF با ۰٫۷۳۰ از هر دو SVD تانسوری بهتر بودند.
- نسخهٔ یکسمتی tc-SVD روی همهٔ مجموعهدادهها از نسخهٔ یکسمتی t-SVD سریعتر بود: روی ORL، Yale B و COIL-100 کمتر از نصف زمان را گرفت و روی PIE-pose اختلاف حدود ۱۳ درصد بود. HOSVD روی Yale B و COIL-100 از این هم سریعتر بود.
- در تفکیک eMCI از افراد سالم (۸۲ آزمودنی، اعتبارسنجی «یکی بیرون»)، بهترین دقت در میان kها برای tc-SVD با k = ۴۴ برابر ۸۶٫۵٪ و برای t-SVD با k = ۱۳ برابر ۷۰٫۷٪ بود؛ بزرگترین فاصله در کل پایاننامه. عدد tc-SVD به k حساس بود و این یک نتیجهٔ پژوهشی در مطالعهای کوچک است، نه ابزار تشخیص.
پس مرز آینهای برندهٔ همیشگی نیست. برتری ثابتش سرعت بود و بهبود دقت به مجموعهداده بستگی داشت.
کد
پیادهسازی MATLAB بهصورت متنباز در github.com/mahdipc/tcSVD با مجوز MIT منتشر شده است. در این مخزن، کنار tc-SVD، نسخهٔ t-SVD مبتنی بر FFT برای مقایسه، بهروزرسانی افزایشی، کد طبقهبندی و خوشهبندی و یک پیادهسازی HOSVD هست. برای اجرا به جعبهابزار Tensor Toolbox for MATLAB نیاز دارید. نام تابعها در نمونهٔ زیر همانطور نوشته شده که در مخزن آمده:
A = rand(32, 50, 32);
[U, S, V] = tcSVD(A, 10);
Ak = tcProdact(U, tcProdact(S, tcTranspose(V)));
relative_error = norm(A(:) - Ak(:)) / norm(A(:))
اینجا A پنجاه تصویر ۳۲×۳۲ است که هرکدام یک اسلایس جانبیاند و tcSVD(A, 10) تجزیهٔ رتبهٔ ۱۰ را برمیگرداند. توضیح قدمبهقدم همین روش، همراه با کد NumPy، در یادداشتهای تانسوری آمده است.
پرسشهای رایج
فرق t-SVD و tc-SVD چیست؟
هر دو تانسور را در راستای مُد سوم تبدیل میکنند، برای هر اسلایس روبهرو یک SVD ماتریسی میگیرند و برمیگردند. t-SVD با FFT کار میکند، مرز تناوبی فرض میکند و به عدد مختلط نیاز دارد؛ tc-SVD با DCT کار میکند، مرز انعکاسی فرض میکند و همهچیز را حقیقی نگه میدارد.
آیا tc-SVD همیشه از t-SVD بهتر است؟
نه. در آزمایشهای پایاننامه دقت طبقهبندیاش همسطح t-SVD بود، روی ORL و Extended Yale B خوشههای بهتری داد و در یک مطالعهٔ کوچک fMRI روی مرحلهٔ اولیهٔ آلزایمر بهترین دقتش بالاتر بود (۸۶٫۵٪ در برابر ۷۰٫۷٪؛ عددی که به k حساس بود). روی PIE-pose نسخهٔ t-SVD کمی جلوتر بود و روی COIL-100 روشهای HOSVD و NMF از هر دو بهتر عمل کردند. از نظر سرعت، تقریباً در همهٔ مقایسهها از t-SVD سریعتر بود.
چرا tc-SVD از t-SVD سریعتر است؟
DCT همهٔ محاسبات را در اعداد حقیقی نگه میدارد، در حالی که FFT حتی برای دادهٔ حقیقی با عدد مختلط کار میکند. در آزمایشهای پایاننامه نسخههای مبتنی بر DCT تقریباً در همهٔ مقایسهها سریعتر بودند و اغلب حدود نصف زمان را گرفتند.
tc-SVD را چه کسی توسعه داد؟
tc-SVD و روشهای یادگیری مبتنی بر آن حاصل پایاننامهٔ کارشناسی ارشد مهدی مولوی با عنوان «یادگیری کلانداده با نمایش تانسوری» در دانشگاه تربیت مدرس (۲۰۱۹) به راهنمایی دکتر منصور رزقی است. ضربی بسیار نزدیک به آن، بر پایهٔ همین تبدیل کسینوسی، در کار کرنفلد، کیلمر و آئرون (۲۰۱۵) هم آمده است.
کد tc-SVD در دسترس است؟
بله. پیادهسازی MATLAB همراه با طبقهبندی، خوشهبندی و بهروزرسانی افزایشی در github.com/mahdipc/tcSVD با مجوز MIT منتشر شده است.