

یک ویدیوی سیثانیهای سیاهوسفید را در نظر بگیرید، با ۲۵ فریم در ثانیه و ابعاد ۷۶۸ در ۵۷۶ پیکسل. یعنی ۷۵۰ فریم که هرکدام شبکهای از ۴۴۲٬۳۶۸ عدد است. بیشتر کتابخانههای یادگیری ماشین قبل از اینکه سراغ چنین دادهای بروند، از ما میخواهند هر فریم یا کل ویدیو را به یک بردار بلند تبدیل کنیم.
این کار جواب میدهد، به این معنا که کد اجرا میشود، اما هندسهٔ داده در این مسیر از دست میرود. دو پیکسلی که در تصویر کنار هم نشستهاند، ممکن است در بردار صدها خانه از هم فاصله بگیرند. یک پیکسل در دو فریم پشتسرهم از این هم دورتر میافتد. حالا مدل باید ساختاری را از نو کشف کند که خود داده از اول رایگان در اختیارمان گذاشته بود.
پژوهش کارشناسی ارشد من در دانشگاه تربیت مدرس از همین دغدغه شروع شد: چطور میشود از دادههای حجیم یاد گرفت، بدون اینکه اول صافشان کنیم؟ پاسخی که با آن کار کردم تانسور بود. این نوشته اولین قسمت از یک مجموعهٔ کوتاه بر اساس پایاننامهام است و مبانیای را که برای ادامهٔ مسیر لازم دارید مرور میکند.
صاف کردن داده کجا ضرر میزند؟
دو مشکل متفاوت در کار است و بهتر است آنها را از هم جدا نگه داریم.
ساختار از بین میرود. تصویر فقط کیسهای از عددها نیست؛ پیکسلهای همسایه به هم وابستهاند و فریمهای پشتسرهم هم همینطور. برداریسازی این هندسه را دور میریزد و همراه آن، اطلاعاتی را که مدل میتوانست به کار بگیرد.
برای هر بُعد هزینه میدهیم. بردار بلند یعنی فضای ویژگی بزرگ. با تعداد نمونهٔ ثابت، اضافه کردن ویژگی از جایی به بعد پیشبینی را بدتر میکند؛ اثری که به «پدیدهٔ هیوز» (۱۹۶۸) معروف است و یکی از چهرههای همان چیزی است که بلمن «نفرین ابعاد» نامید. تاوانش را در حافظه و زمان هم میپردازیم: آموزش SVM کرنلی برای m نمونه تقریباً از مرتبهٔ O(m³) زمان و O(m²) حافظه میگیرد و هزینهٔ PCA یا رگرسیون خطی برای n ویژگی حدود O(mn² + n³) است. در کلانداده نه m کوچک است و نه n.
تانسور، به زبان داده
ریاضیدانها و فیزیکدانها این واژه را با دستگاه نظری مفصلی به کار میبرند. اما در کار با داده کافی است تانسور را یک آرایهٔ چندبُعدی بدانیم. تعداد ابعادش را مرتبه و هر بُعد را یک مُد میگوییم. یک عدد تنها مرتبهٔ صفر است، بردار مرتبهٔ یک و ماتریس مرتبهٔ دو. ویدیوی سیاهوسفید ما یک تانسور مرتبهٔ سه به ابعاد ۵۷۶×۷۶۸×۷۵۰ است: ارتفاع، عرض و فریم. اگر کانالهای رنگ را هم نگه داریم، مرتبهاش چهار میشود.
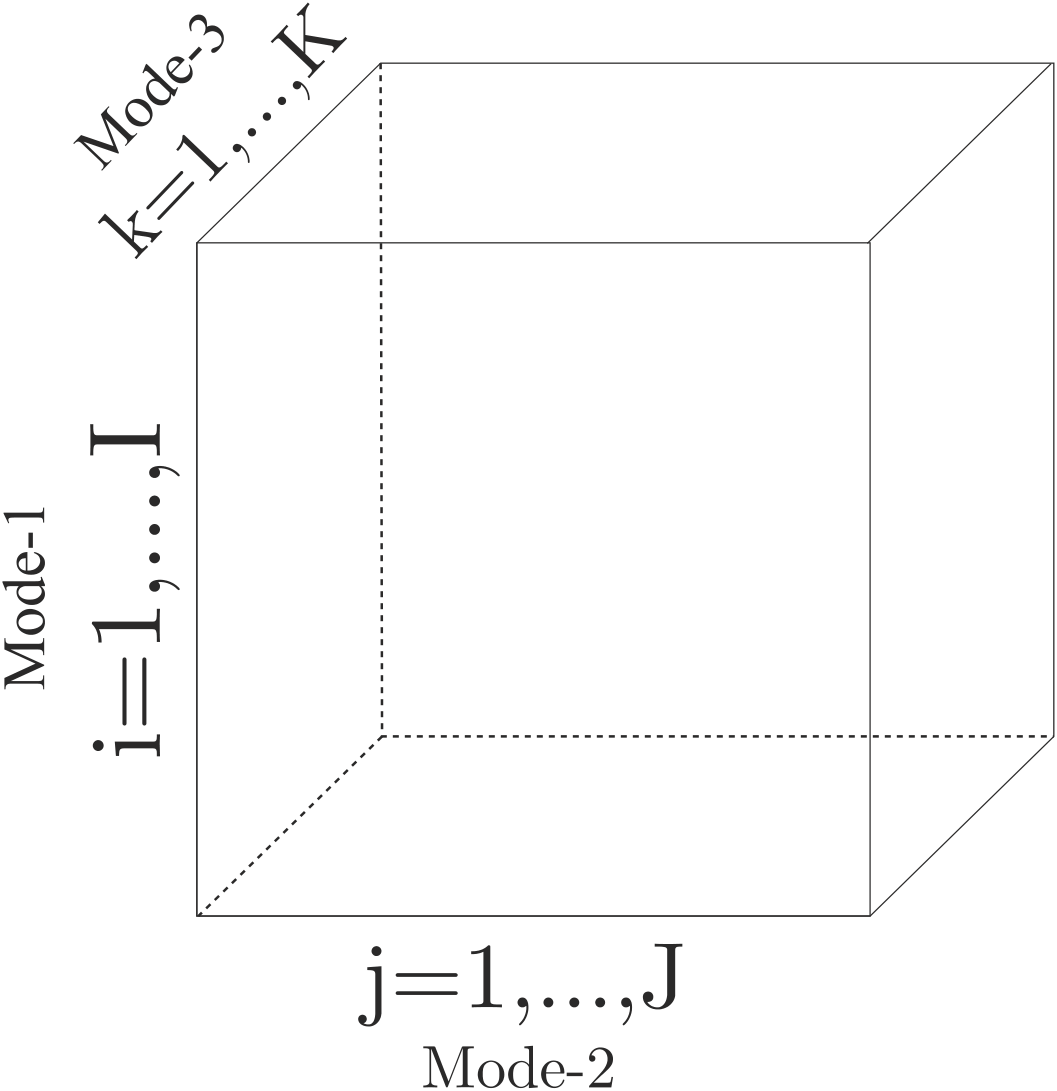
یک تانسور مرتبهٔ سه و سه مُد آن.
فیبر و اسلایس
دو مفهوم فکر کردن دربارهٔ تانسورها را ساده میکند.
فیبر چیزی است که با ثابت نگه داشتن همهٔ اندیسها بهجز یکی به دست میآید. در تانسور مرتبهٔ سه فیبرهای ستونی، سطری و تیوبی داریم. در مثال ویدیو، هر فیبر تیوبی یعنی یک پیکسل که در طول زمان دنبالش میکنیم؛ دقیقاً همان ساختاری که صاف کردن نابودش میکند.
اسلایس همهٔ اندیسها بهجز دو تا را ثابت نگه میدارد و بنابراین یک ماتریس است. برای ویدیو، اسلایسهای روبهرو طبیعیترین انتخاباند: هر اسلایس روبهرو یک فریم است. اسلایسهای افقی و جانبی همان بلوک داده را از دو جهت دیگر برش میزنند.
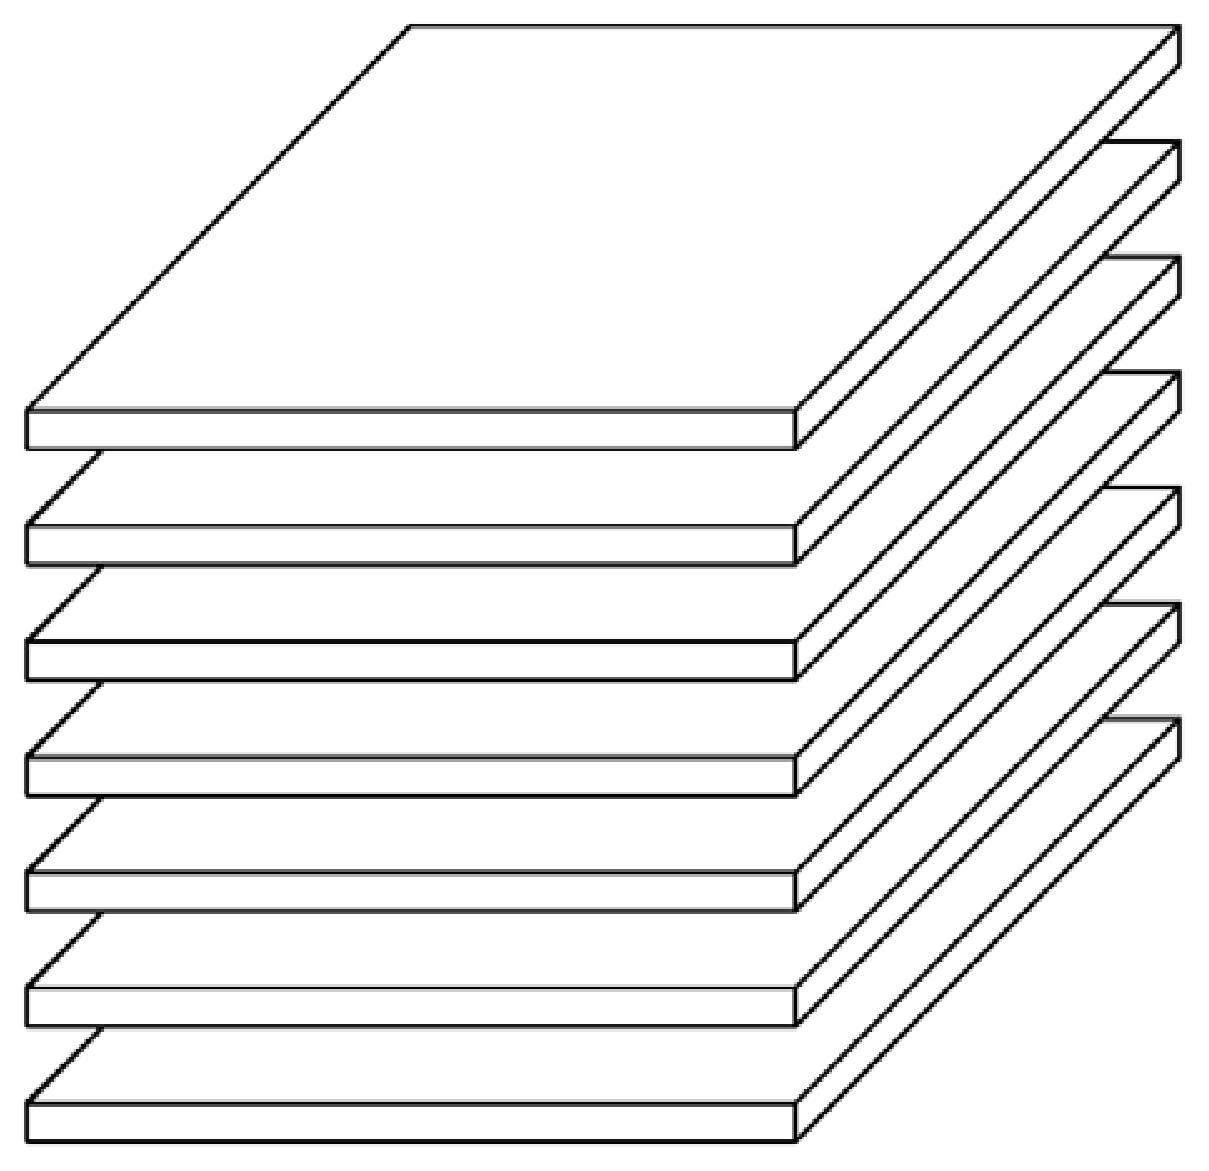
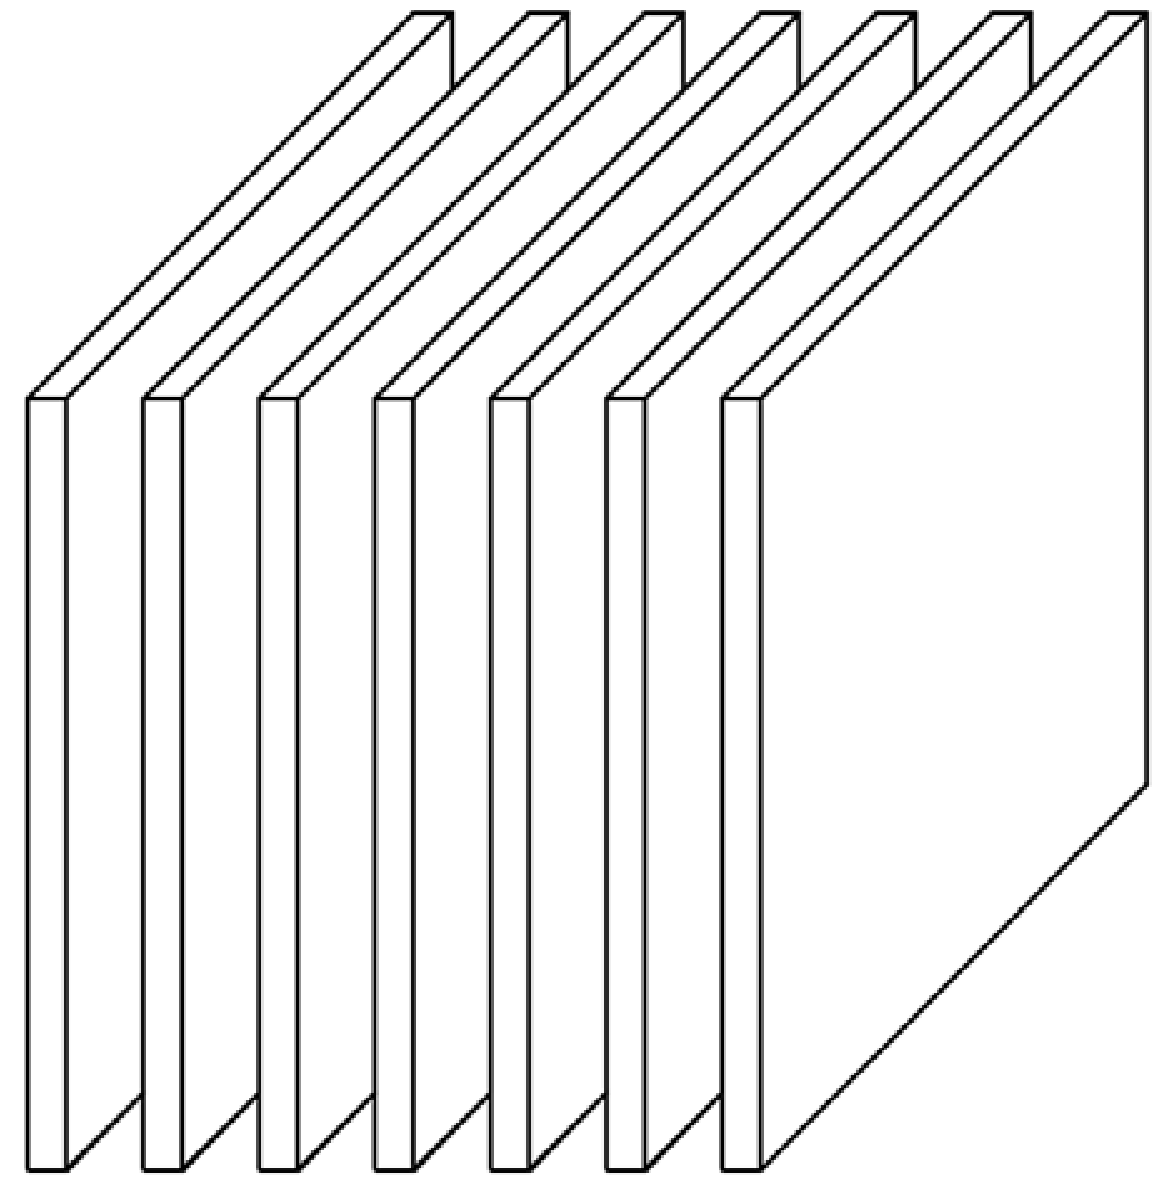
اسلایسهای افقی (راست) و جانبی (چپ) یک تانسور.
ماتریسیسازی؛ پلی به الگوریتمهای ماتریسی
دیر یا زود میخواهیم از ابزارهای ماتریسی آشنا استفاده کنیم. ماتریسیسازی (یا باز کردن تانسور) فیبرهای مُد n را بهعنوان ستونهای یک ماتریس کنار هم میچیند. یک تانسور ۳×۴×۲ اگر در راستای مُد یک باز شود، یک ماتریس ۳×۸ میشود: دو اسلایس روبهرو کنار هم. اگر در راستای مُد دو باز شود، بهجای خود اسلایسها ترانهادهٔ آنها کنار هم قرار میگیرند. هر ماتریسیسازی فقط نمای دیگری از همان داده است و چیزی دور ریخته نمیشود.
ضرب مُد n؛ کوچک کردن یک بُعد در هر بار
عملیاتی که بیش از همه به کارم آمد ضرب مُد n است. همهٔ فیبرهای مُد n تانسور را در یک ماتریس ثابت U ضرب میکنیم. اگر U سطر کمتری از طول آن مُد داشته باشد، آن مُد کوچک میشود و بقیه دستنخورده میمانند. در پایاننامه این را با کاهش مُد دوم یک تانسور از ۸ به ۲ نشان دادهام. اگر سطرهای U متعامد یکه باشند، هر فیبر مُد n روی چند جهت تصویر میشود؛ یعنی نسخهٔ تانسوری تصویر کردن داده روی مؤلفههای اصلی. همهٔ تجزیههای این مجموعه از آن استفاده میکنند.
نسخهٔ کوتاهی از هر دو عملیات با NumPy:
import numpy as np

def unfold(X, mode):
    # the mode-n fibers become the columns of a matrix
    return np.moveaxis(X, mode, 0).reshape(X.shape[mode], -1, order="F")

def mode_n_product(X, U, mode):
    # multiply every mode-n fiber of X by the matrix U
    Y = U @ unfold(X, mode)
    rest = [s for i, s in enumerate(X.shape) if i != mode]
    return np.moveaxis(Y.reshape([U.shape[0]] + rest, order="F"), 0, mode)

X = np.random.rand(3, 8, 5)
U = np.random.rand(2, 8)
print(mode_n_product(X, U, 1).shape)   # (3, 2, 5)
پای تجزیهها کجا باز میشود
ذخیرهٔ داده به شکل تانسور ساختارش را حفظ میکند؛ صرفهجویی وقتی به دست میآید که تانسور را تجزیه کنیم، همانطور که SVD یک ماتریس را تجزیه میکند، و فقط بخشهایی را نگه داریم که اطلاعات دارند. از گزینههای کلاسیک، یکی تجزیهٔ CP است که تانسور را جمع چند تکهٔ رتبهیک مینویسد و دیگری تجزیهٔ تاکر که با یک تانسور هستهٔ کوچک و یک ماتریس عامل برای هر مُد کار میکند و معمولاً با SVD مرتبهبالا (HOSVD) محاسبه میشود.
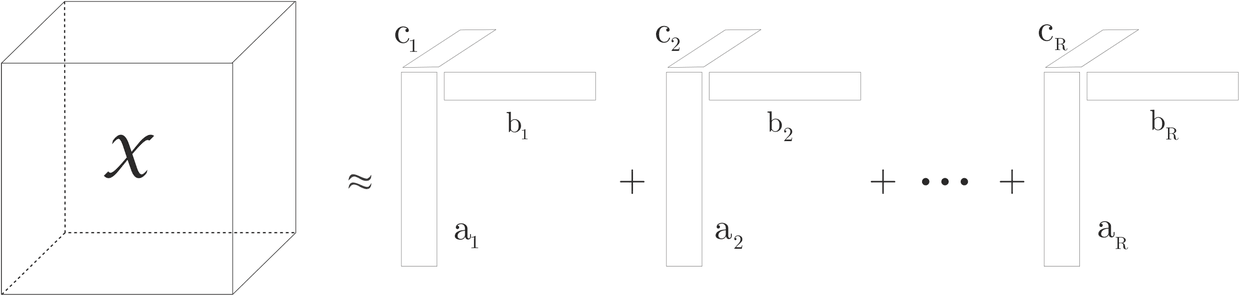
تجزیهٔ CP: جمع R تانسور رتبهیک.
هر دو کاربردیاند، اما برای مسئلههای یادگیریای که برایم مهم بود، خانوادهٔ سومی مناسبتر بود: ضرب t و تجزیهٔ t-SVD، چون ویژگی برش بهینهٔ SVD ماتریسی را حفظ میکند. موضوع قسمت بعد همین است. بعد از آن میرسیم به بخشی که خودم ساختم؛ نسخهای به نام tc-SVD که فرض «دایرهای» پنهان در t-SVD را با یک آینه عوض میکند.
نگاه اول به t-SVD
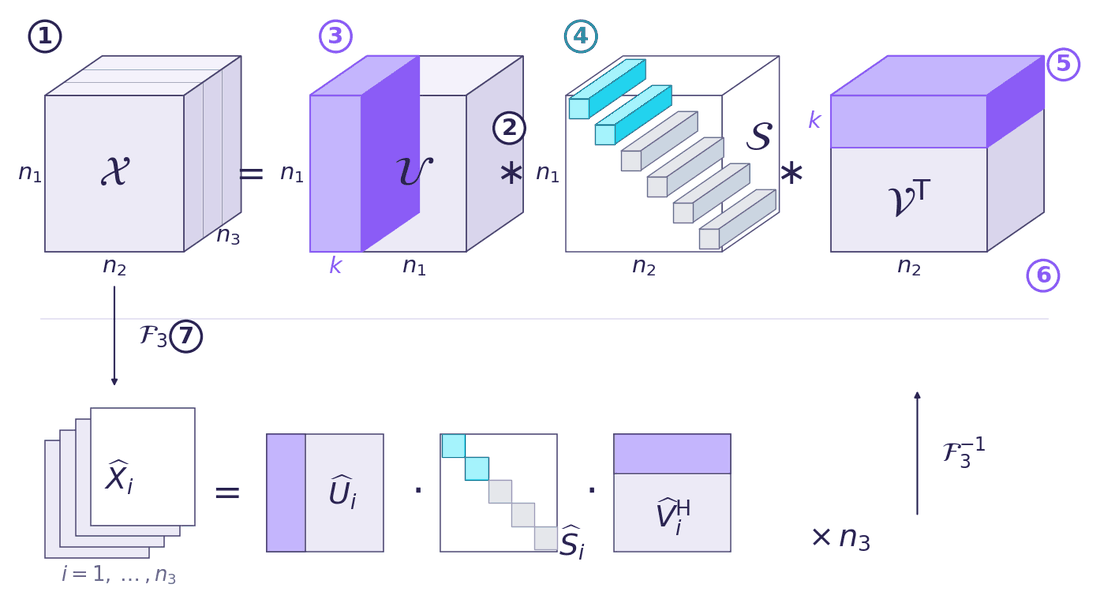
شمای t-SVD. رنگهای بنفش و فیروزهای بخشهایی را نشان میدهند که در برش با رتبهٔ k نگه داشته میشوند؛ شمارهها پایینتر توضیح داده شدهاند.
قسمت بعد این تجزیه را قدمبهقدم میسازد، ولی همین حالا هم میشود تصویر را خواند. X (۱) داده است با ابعاد n1×n2×n3 و ∗ (۲) ضرب t است؛ ضربی که در راستای مُد سوم کار میکند. U (۳) متعامد است؛ اسلایسهای جانبیاش نقش پایه را دارند و بلوک بنفش k تای اول آنهاست. S (۴) f-قطری است: فقط تیوبهای روی قطرش غیرصفرند و k تای اول (فیروزهای) نگه داشته میشوند. VT (۵) ترانهادهٔ t یک تانسور متعامد V است و سطرهای بنفشش هر نمونه را به پایهٔ نگهداشتهشده وصل میکنند. اگر فقط بخشهای رنگی را نگه داریم، یعنی k تا از هرکدام (۶)، X ≈ Uk ∗ Sk ∗ VkT به دست میآید. ردیف پایین (۷) نشان میدهد چرا این روش ارزان است: بعد از یک FFT در راستای مُد سوم (DCT در tc-SVD) کل تجزیه به n3 تجزیهٔ SVD معمولی تبدیل میشود، یکی برای هر اسلایس روبهرو.
این مجموعه بر اساس پایاننامهٔ کارشناسی ارشد من با عنوان «یادگیری کلانداده با نمایش تانسوری» به راهنمایی دکتر منصور رزقی در دانشگاه تربیت مدرس نوشته شده است. همهٔ قسمتهای این مجموعه را در یادداشتها میتوانید ببینید.
این یادداشت به انگلیسی هم منتشر شده است: نسخهٔ انگلیسی.