

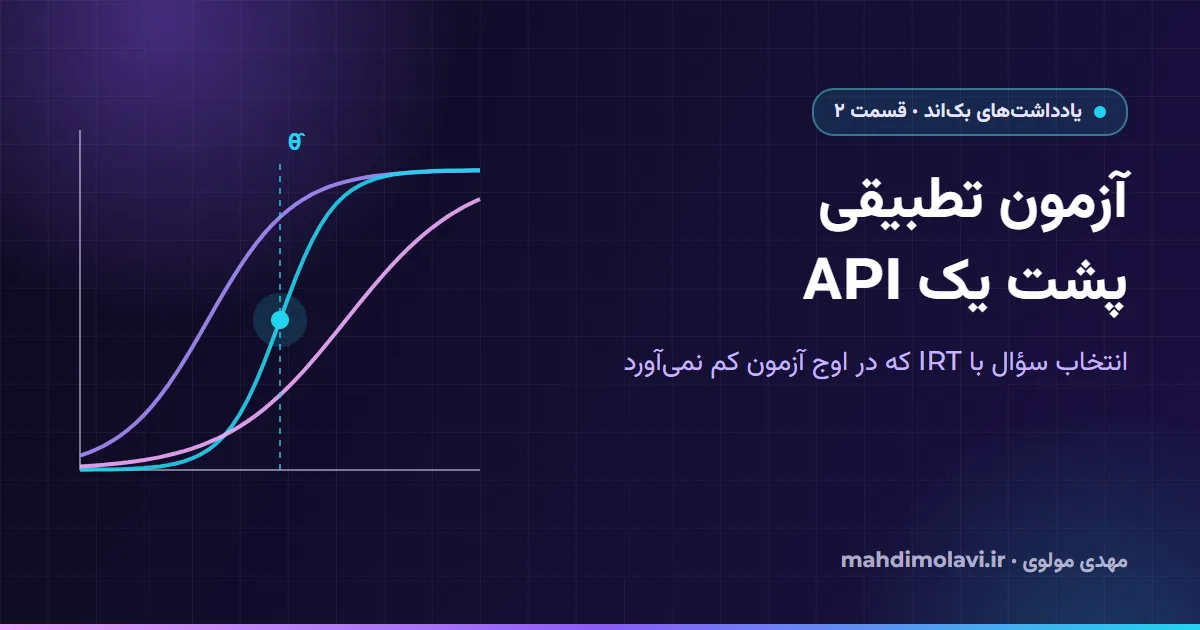
در آزمون ثابت همه همان چهل سؤال را جواب میدهند. دانشآموز قوی بیشتر وقتش را روی سؤالهایی میگذارد که چیز تازهای دربارهٔ او نمیگویند و دانشآموز ضعیفتر روی سؤالهایی که شانس چندانی برای حلشان ندارد. آزمون تطبیقی کار هوشمندانهتری میکند: بعد از هر پاسخ، برآوردش از توانایی دانشآموز را بهروز میکند و سؤالی را انتخاب میکند که در همان سطح بیشترین اطلاعات را میدهد. نتیجهٔ معمول، همان دقت اندازهگیری با سؤالهای کمتر است.
در NovaTech معماری یک پلتفرم آزمون تطبیقی مبتنی بر نظریهٔ سؤال–پاسخ (IRT) را طراحی کردم که برای سنجش شخصیسازیشده و تحلیل به کار میرود و حدود ۸۹٬۰۰۰ دانشآموز از آن استفاده میکنند. این یادداشت اول مدل را کوتاه مرور میکند و بعد سراغ بخشی میرود که بهعنوان مهندس بکاند بیشتر از همه برایم جالب است: گذاشتن چرخهٔ انتخاب، پاسخ و بهروزرسانی پشت یک API که وقتی پنجرهٔ آزمون باز میشود و همه با هم شروع میکنند، کند نشود.
IRT در پنج دقیقه
نظریهٔ سؤال–پاسخ احتمال پاسخ درست را تابعی از یک توانایی پنهان به نام θ (تتا) و چند پارامتر سؤال میداند. توانایی روی مقیاسی استاندارد تعریف میشود: θ = ۰ تقریباً میانگین جمعیتی است که سؤالها روی آن کالیبره شدهاند و بیشتر دانشآموزها بین −۳ و ۳ قرار میگیرند.
- مدل یکپارامتری (1PL یا راش): هر سؤال فقط یک پارامتر دارد، یعنی دشواری b. احتمال پاسخ درست P = ۱ / (۱ + e−(θ − b)) است، پس در θ = b شانس پاسخ درست پنجاه درصد است.
- مدل دوپارامتری (2PL): قدرت تمیز a اضافه میشود که تعیین میکند منحنی اطراف b با چه شیبی بالا برود: P = ۱ / (۱ + e−a(θ − b)).
- مدل سهپارامتری (3PL): یک مجانب پایین c برای حدس زدن اضافه میشود که برای سؤالهای چندگزینهای مناسب است: P = c + (۱ − c) / (۱ + e−a(θ − b)).
بعضی منابع توان را در ضریب مقیاس D ≈ ۱٫۷ هم ضرب میکنند. هر دو قرارداد درست است، به شرطی که سرویس دقیقاً همان قراردادی را به کار ببرد که کالیبراسیون با آن انجام شده.
مفهومی که انتخاب تطبیقی را پیش میبرد اطلاعات سؤال است. هر سؤال در یک ناحیه از θ خوب اندازه میگیرد و در بقیهٔ نواحی ضعیف. در مدل دوپارامتری I(θ) = a² P(۱ − P) است که در θ = b به بیشینه میرسد، و در مدل سهپارامتری I(θ) = a² · ((P − c) / (۱ − c))² · (۱ − P) / P. اطلاعات سؤالها با هم جمع میشود و خطای استاندارد برآورد توانایی تقریباً برابر ۱ / √(اطلاعات کل) است. پس انتخاب سؤالهایی که در سطح همان دانشآموز اطلاعات زیادی میدهند، خطا را سریعتر از هر راه دیگری پایین میآورد.
پارامترهای سؤال از کالیبراسیون میآیند، یعنی برازش مدل روی پاسخهای اجراهای قبلی. این یک کار آماری آفلاین است و پایتون محیط طبیعی آن است. سؤال تازه پیش از آنکه قابل انتخاب شود پارامتر لازم دارد؛ روش رایج این است که آن را بدون نمره در آزمونهای واقعی بگذارند تا پاسخ کافی جمع شود. سرویس آنلاین فقط خروجی این کار را مصرف میکند.
چرخهٔ آزمون
- شروع با یک باور اولیه دربارهٔ θ، معمولاً توزیع نرمال استاندارد.
- انتخاب سؤال بعدی بر اساس برآورد فعلی، سؤالهایی که قبلاً نشان داده شده و قواعد محتوایی آزمون.
- پاسخ: دانشآموز جواب میدهد و پاسخ بهصورت ماندگار ذخیره میشود.
- بهروزرسانی برآورد توانایی با پاسخ تازه.
- توقف وقتی خطای استاندارد از حد هدف پایینتر بیاید یا آزمون به حداکثر طولش برسد؛ وگرنه بازگشت به مرحلهٔ دوم.
برای بهروزرسانی، برآورد پسین مورد انتظار (EAP) روی یک شبکهٔ ثابت از مقدارهای θ را ترجیح میدهم. درستنمایی بیشینه انتخاب کتابهای درسی است، اما وقتی دانشآموز همهٔ سؤالها را درست یا همه را غلط جواب داده باشد جواب متناهی ندارد، و این وضعیت بعد از چند سؤال اول زیاد پیش میآید. EAP به کمک توزیع پیشین متناهی میماند و روی شبکه چیزی جز حساب ساده نیست. افزایشی هم هست: توزیع پسین بعد از n پاسخ همان توزیع پسین بعد از n − ۱ پاسخ است ضرب در یک منحنی درستنمایی. یعنی این بخش از وضعیت جلسه فقط یک آرایه است.
public sealed record Item(int Id, double A, double B, double C, string Area);

public static class Irt
{
    public static double P(Item item, double theta) =>
        item.C + (1 - item.C) / (1 + Math.Exp(-item.A * (theta - item.B)));

    public static double Information(Item item, double theta)
    {
        var p = P(item, theta);
        var x = (p - item.C) / (1 - item.C);
        return item.A * item.A * x * x * (1 - p) / p;
    }
}

public static class Eap
{
    // 61 quadrature points from -4 to 4
    public static readonly double[] Grid =
        Enumerable.Range(0, 61).Select(i => -4 + i * 8.0 / 60).ToArray();

    public static double[] Prior() =>
        Normalize(Grid.Select(t => Math.Exp(-0.5 * t * t)).ToArray());

    public static double[] Update(double[] posterior, Item item, bool correct)
    {
        var next = new double[Grid.Length];
        for (var i = 0; i < Grid.Length; i++)
        {
            var p = Irt.P(item, Grid[i]);
            next[i] = posterior[i] * (correct ? p : 1 - p);
        }
        return Normalize(next);
    }

    public static (double Theta, double Se) Summarize(double[] posterior)
    {
        double mean = 0, variance = 0;
        for (var i = 0; i < Grid.Length; i++) mean += Grid[i] * posterior[i];
        for (var i = 0; i < Grid.Length; i++) variance += Math.Pow(Grid[i] - mean, 2) * posterior[i];
        return (mean, Math.Sqrt(variance));
    }

    private static double[] Normalize(double[] w)
    {
        var sum = w.Sum();
        for (var i = 0; i < w.Length; i++) w[i] /= sum;
        return w;
    }
}
نرمالسازی بعد از هر پاسخ، مقدارها را هر قدر هم که آزمون طولانی باشد در محدودهٔ عددی امنی نگه میدارد. اندازهٔ شبکه یک بدهبستان است. شصتویک نقطه بین −۴ و ۴ نقطهٔ شروع معقولی است؛ پیش از آنکه هزینهٔ شبکهٔ ریزتر را بدهید، بررسی کنید اصلاً نمرهٔ نهایی کسی را عوض میکند یا نه.
انتخاب سؤال بعدی
قاعدهٔ کتاب درسی بیشینهٔ اطلاعات است: از میان سؤالهای استفادهنشده، سؤالی انتخاب میشود که در برآورد فعلی بیشترین اطلاعات را دارد. اگر بیملاحظه به کار برود، در محیط واقعی دو مشکل جدی دارد.
نرخ مواجهه. بیشینهٔ اطلاعات مدام همان چند سؤال با قدرت تمیز بالا را انتخاب میکند. سهم بزرگی از دانشآموزها آنها را میبینند، سؤالها لو میروند و بقیهٔ بانک بیاستفاده میماند. راهحلهای رایج: انتخاب شبهتصادفی (randomesque)، یعنی انتخاب تصادفی از میان k سؤال برتر؛ کنترل مواجههٔ سیمپسون-هتر که برای هر سؤال یک احتمال اجرا تعیین میکند و با شبیهسازی تنظیمش میکند؛ و طبقهبندی بر اساس a، یعنی استفاده از سؤالهای کمتمیز در ابتدای آزمون که θ هنوز نامطمئن است و نگه داشتن سؤالهای تیز برای بعد.
توازن محتوایی. آزمون ریاضیای که θ را دقیق اندازه میگیرد ولی هیچ سؤالی از هندسه ندارد، آزمون ریاضی معتبری نیست. سادهترین روش، به سبک CAT مقیددِ کینگزبری و زارا، اول حوزهٔ محتواییای را انتخاب میکند که بیشترین فاصله را با سهم هدفش دارد و بعد درون همان حوزه اطلاعات را بیشینه میکند. ابزارهای سنگینتری هم هست، مثل آزمونهای سایهٔ وندرلیندن که در هر قدم یک مسئلهٔ بهینهسازی حل میکنند، اما همین نسخهٔ ساده کار را تا حد زیادی پیش میبرد.
public sealed class ItemSelector(IReadOnlyList<Item> bank, IReadOnlyDictionary<string, double> targets)
{
    public Item? Next(double theta, IReadOnlySet<int> used,
                      IReadOnlyDictionary<string, int> givenPerArea, int topK = 5)
    {
        var total = Math.Max(1, givenPerArea.Values.Sum());

        // 1. content balancing: the area furthest below its target share that still has items
        var area = targets
            .OrderByDescending(t => t.Value - givenPerArea.GetValueOrDefault(t.Key) / (double)total)
            .Select(t => t.Key)
            .FirstOrDefault(a => bank.Any(i => i.Area == a && !used.Contains(i.Id)));
        if (area is null) return null;

        // 2. maximum information within that area, 3. randomesque exposure control
        var candidates = bank
            .Where(i => i.Area == area && !used.Contains(i.Id))
            .OrderByDescending(i => Irt.Information(i, theta))
            .Take(topK)
            .ToList();
        return candidates[Random.Shared.Next(candidates.Count)];
    }
}
این یک پیمایش خطی روی بانک است و برای چند هزار سؤال، هزینهاش خیلی کمتر از یک رفتوبرگشت شبکه است. اگر روزی پروفایلر خلافش را نشان داد، اطلاعات هر سؤال را در همهٔ نقاط شبکه یک بار، هنگام بارگذاری بانک، حساب کنید تا انتخاب به یک جستوجو در نزدیکترین نقطهٔ شبکه تبدیل شود.
کش کردن بانک سؤال
پارامترهای سؤال کمحجماند و بهندرت عوض میشوند: چند عدد برای هر سؤال، بهعلاوهٔ حوزهٔ محتوایی و چند پرچم وضعیت. همین آنها را برای کش درونپروسهای ایدهآل میکند. هر نمونهٔ API بانک فعال را بهشکل یک شیء تغییرناپذیر با شمارهٔ نسخه در حافظه نگه میدارد. انتشار یک کالیبراسیون تازه ردیفهای جدید را در SQL Server مینویسد، شمارهٔ نسخه را بالا میبرد و به نمونهها خبر میدهد که دوباره بارگذاری کنند؛ با کلیدی در Redis که مرتب بررسیاش میکنند یا با یک پیام pub/sub. نمونهها ارجاع را بهصورت اتمیک عوض میکنند، پس درخواستی که در جریان است با همان بانکی تمام میشود که با آن شروع شده بود.
دو قاعده این کار را امن نگه میدارد. هر جلسه نسخهٔ بانکی را که با آن شروع شده ثبت میکند تا هیچ دانشآموزی با پارامترهای دو کالیبراسیون مختلف نمره نگیرد؛ یعنی نسخهٔ قبلی باید تا پایان جلسههایش در حافظه بماند. و متن سؤال و کلید پاسخ جزو این شیء نیستند؛ فقط برای سؤالی که نمایش داده میشود خوانده میشوند و کلید هیچوقت از سرور بیرون نمیرود.
شکل API
| اندپوینت | کاربرد |
|---|---|
POST /sessions | شروع آزمون: ساختن وضعیت جلسه (توزیع پیشین، تاریخچهٔ خالی، نسخهٔ بانک) و برگرداندن اولین سؤال. |
POST /sessions/{id}/responses | ثبت پاسخ؛ جواب این درخواست سؤال بعدی یا اعلام پایان آزمون است. |
GET /sessions/{id} | ادامه بعد از قطع اتصال: سؤال فعلی را بدون جلو بردن آزمون برمیگرداند. |
GET /sessions/{id}/result | نمره و گزارش، پس از پایان جلسه. |
برگرداندن سؤال بعدی در جواب همان درخواست ثبت پاسخ، برای هر سؤال یک رفتوبرگشت کم میکند و این صرفه در طول آزمون و در اوج ترافیک جمع میشود. اندپوینت ثبت پاسخ باید idempotent هم باشد؛ یعنی تکرار درخواست نباید اثر دوباره بگذارد. روی اینترنت ناپایدار موبایل، کلاینت درخواست را دوباره میفرستد و پاسخ تکراری نباید دو بار شمرده شود یا آزمون را دو قدم جلو ببرد. یک قید یکتایی روی جفت (جلسه، سؤال) در SQL Server، بهعلاوهٔ برگرداندن همان سؤالی که قبلاً انتخاب شده بود وقتی درخواست تکراری میرسد، مسئله را تمیز حل میکند.
پاسخگو ماندن در اوج آزمون
محاسبات IRT ارزان است: یک بهروزرسانی EAP روی شصتویک نقطه و یک پیمایش بانک، کار پردازشی کمی است و خیلی کمتر از یک رفتوبرگشت به پایگاهداده طول میکشد. چیزی که تعیین میکند سامانه در اوج دوام بیاورد، همهچیزِ اطراف ریاضیات است. در پلتفرم NovaTech گردشکارهای ساخت آزمون، نمرهدهی، گزارشگیری و انتخاب سؤال را من ساختم و همه باید در اوج دورههای آزمون سر پا میماندند. اصولی که برای این نوع سرویس رعایت میکنم:
- هیچ خواندنی از پایگاهداده در مسیر انتخاب سؤال. بانک در حافظه است و وضعیت جلسه (توزیع پسین، سؤالهای استفادهشده، شمار هر حوزه) در Redis با TTLی بلندتر از طول آزمون. هر پاسخ فقط یک نوشتن ماندگار و یک بهروزرسانی کوچک وضعیت هزینه دارد.
- اول ماندگار، بعد کش. پاسخ پیش از تغییر وضعیت در Redis در SQL Server نوشته میشود. اگر Redis جلسهای را از دست بدهد، میشود با عبور دادن پاسخهای ذخیرهشده از همان تابع بهروزرسانی دوباره ساختش؛ دلیلی دیگر برای اینکه آن تابع قطعی بماند.
- نمونههای بیحالت API. هر نمونه میتواند به هر درخواستی جواب دهد، پس افزایش نمونهها پیش از پنجرهٔ آزمون فقط یک تغییر پیکربندی لازم دارد.
- کار سنگین بیرون از مسیر درخواست. گزارشها و تحلیلها پس از پایان جلسه بهصورت ناهمزمان ساخته میشوند. دانشآموزی که منتظر سؤال بعدی است نباید منتظر گزارش کس دیگری بماند.
- گرم کردن پیش از باز شدن پنجره. بانک را بار کنید، مطمئن شوید همهٔ نمونهها یک نسخه را اجرا میکنند و با زمان فکر کردن واقعبینانه، خیلی پیش از روز آزمون، تست بار بگیرید.
یک نکتهٔ آخر دربارهٔ نمره. θ نهایی روی مقیاس کالیبراسیون است و هیچکس دوست ندارد نمرهاش را −۰٫۳۷ ببیند. آن را به یک مقیاس گزارشدهی ببرید و خطای استاندارد را بهصورت یک بازه نشان دهید، بهجای اینکه وانمود کنید عدد دقیق است.
اگر در حال طراحی یک سامانهٔ سنجش تطبیقی یا پرترافیک هستید، این از جنس کارهای بکاندی است که انجام میدهم. یادداشت بعدی از دامنهٔ آزمون فاصله میگیرد و به خود کد میرسد: اینکه یک سرویس واقعی .NET را با Minimal APIs چطور ساختار میدهم.
این یادداشت به انگلیسی هم منتشر شده است: نسخهٔ انگلیسی.