سه آزمون سال جاری، از هر رشته یکی، از کالیبراسیون با بیشینهٔ قدرت تمیز برآوردشدهای برگشتند که خیلی پایینتر از مقدار آرشیو در همان رشتهها بود. دادهها مال یک پلتفرم آزمون آنلاین بود که روی تحلیلهایش کار میکردم، و سؤالی که به من رسید کوتاه بود: آیا سؤالهای جدید بدترند؟ اگر جدول نتایج را همانطور که بود میخواندیم، جواب مثبت بود. به نظر میرسید فرمهای جدید دانشآموزان قویتر و ضعیفتر را کمتر از فرمهای دو سال قبل از هم جدا میکنند.
اولین چیزی که به چشمم آمد تعداد حاضران بود. آزمونهای آرشیوی که با آنها مقایسه میکردم شرکتکنندهٔ خیلی بیشتری داشتند:
| رشته | آزمون جاری (۱۴۰۵)، حاضران رسمی | آزمون آرشیو (۱۴۰۳)، حاضران رسمی |
|---|---|---|
| ریاضی | 434 | 6,342 |
| علوم تجربی | 521 | 9,222 |
| علوم انسانی | 1,134 | 8,648 |
اختلاف تقریباً ۸ تا ۱۸ برابری در تعداد حاضران، کنار افت قدرت تمیز، همزمانیای بود که نمیخواستم بدون بررسی قبولش کنم یا کنارش بگذارم. چند توضیح با این خلاصه جور درمیآمد. ممکن بود سؤالهای جدید ضعیفتر باشند، گروههای جدید پراکندگی کمتری داشته باشند، نمونهها خیلی کوچک باشند، یا خود برآوردگر بهتنهایی به حجم نمونه واکنش نشان دهد. یک قاعدهٔ سرانگشتی آشنا هم وسط بحث بود: برای کالیبراسیون بیش از ۲۰۰ دانشآموز کافی است. اگر این قاعده درست بود، حجم نمونه برای هر سه آزمون از فهرست خط میخورد. هر توضیح پیشبینیای دارد که میشود بررسیاش کرد. بررسی آنها بیشتر از انتظارم طول کشید و طرز خواندن من از شاخص اصلی را عوض کرد.
آنچه این مجموعه پوشش میدهد
این مجموعه گزارش من از همان بررسی است. آن را برای مهندسان بکاند و داده، برای کسانی که سامانههای سنجش را اداره میکنند، و برای برنامهنویسهایی نوشتهام که به روانسنجی کنجکاوند. هر قسمت یک لایه از مسئله را برمیدارد:
- قسمت ۱، همین قسمت: معما، مروری کوتاه بر مدل 2PL، دو نام در کد که راه را اشتباه نشان میدادند، و اینکه خواندن کد چه چیزی را ثابت کرد و چه چیزی را نه.
- قسمت ۲: چه کسانی وارد کالیبراسیون شدند. حاضران رسمی، پاسخهای قابل استفاده و تواناییهای ذخیرهشده شمارشهای متفاوتیاند، و کدگذاری پاسخها تعیین میکند صفر چه معنایی دارد.
- قسمت ۳: پیشینی با برچسب «vague» (مبهم) که در واقع خیلی باریک است، آزمایشی که در آن سؤالها ثابت ماندند و فقط N تغییر کرد، و شبیهسازیای که میپرسد آیا ۴۳۴ دانشآموز اصلاً میتوانند پشتوانهٔ قدرت تمیز بالا باشند.
- قسمت ۴: دو برآوردگر دیگر، یک پیشین سلسلهمراتبی و درستنمایی بیشینهٔ حاشیهای (MML) با کتابخانهٔ GIRTH، که هر کدام شکلهای شکست خودشان را دارند.
- قسمت ۵: یک مطالعهٔ نمونهگیری تکراری روی نُه آزمون، بیست نمونه در هر حجم، و کار مهندسیای که آن را قابل ازسرگیری و تکرارپذیر کرد.
- قسمت ۶: مقایسههای با N برابر بین سالها، نحوهٔ گزارش نتایج، و اینکه چرا N برابر به معنای همترازسازی نیست.
در سراسر مجموعه مشاهدهها، تفسیرها و پیشنهادها را از هم جدا نگه میدارم و میگویم هر نتیجه از کجا به بعد دیگر صدق نمیکند. عددها از چند مرحلهٔ مختلف کار آمدهاند، با استخراجها و جمعیتهای متفاوت. آنها را با هم ادغام نمیکنم، حتی وقتی دوتایشان آنقدر به هم نزدیکاند که میشود با آنها داستان مرتبتری ساخت.
مدل در چند خط
برآوردگری که پشت این ضرایب است یک مدل لجستیک دوپارامتری، یعنی 2PL، را برازش میدهد. برای دانشآموز s و سؤال i:
P(correct response by student s to item i) = sigmoid(a_i * (theta_s - b_i))

sigmoid(x) = 1 / (1 + exp(-x))
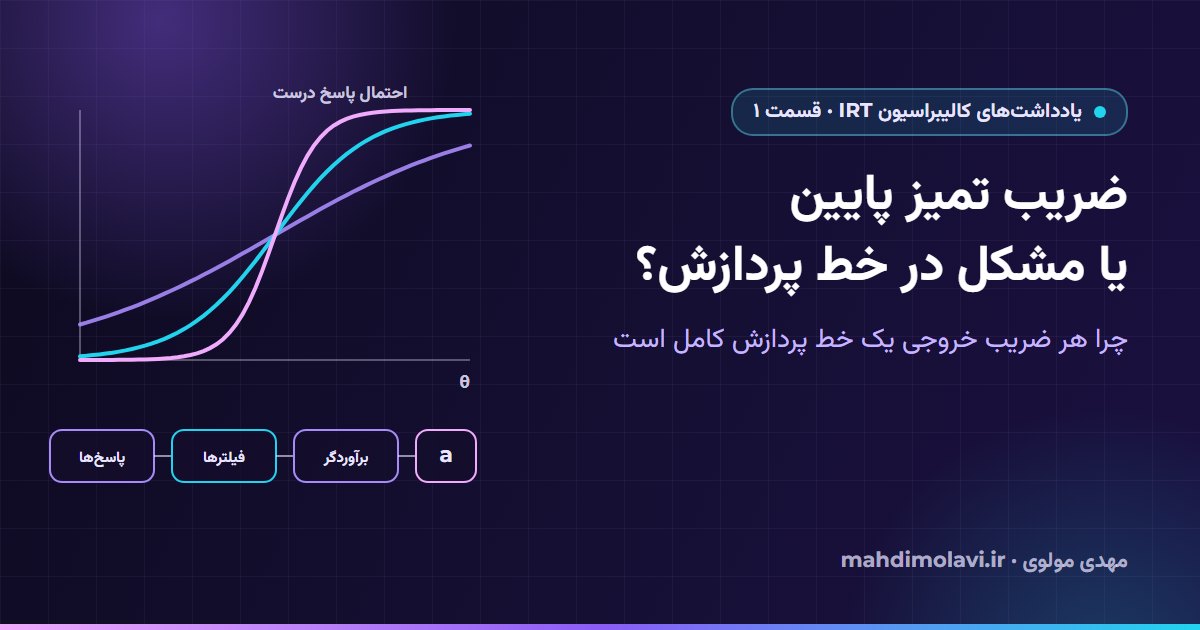
θ توانایی پنهان دانشآموز است. هیچکس آن را مستقیم مشاهده نمیکند؛ مدل آن را همراه با پارامترهای سؤال برآورد میکند. b دشواری است و در این پارامتربندی، تواناییای است که احتمال مدلشدهٔ پاسخ درست در آن ۰٫۵ میشود. a قدرت تمیز است، یعنی شیب منحنی در اطراف b. سؤالی با a مثبت و بزرگ، دانشآموزانی را که تواناییشان نزدیک دشواری آن است با وضوح زیادی از هم جدا میکند، در حالی که سؤالی با a کوچک به دانشآموزانی که فاصلهٔ زیادی با هم دارند شانسهای مشابهی میدهد.
از همان ابتدا دو احتیاط لازم است. سؤال دشوار خودبهخود سؤال بدی نیست، و سؤال با قدرت تمیز بالا هم خودبهخود برای هر جمعیت یا هر هدف محتوایی مناسب نیست. شاخصی که زیر سؤال بود، یعنی بزرگترین a در یک آزمون، هر دو احتیاط را با خودش دارد. دربارهٔ اینکه همین پارامترها چطور انتخاب سؤال را پیش میبرند در یادداشتهای بکاند ۲، دربارهٔ آزمون تطبیقی با IRT نوشتهام. این مجموعه دربارهٔ این است که پارامترها از کجا میآیند.
دو نامی که راه را اشتباه نشان میدادند
جدولهای نتایج ستونی به نام Lambda دارند و در هر ردیفی که دیدم مقدارش ۰٫۲۵ بود. تابع سرویسی که برآورد را اجرا میکند «3pl» را در نامش دارد. این دو واقعیت کنار هم مدلی سهپارامتری با کف حدسِ برآوردشده را به ذهن میآورند. وقتی تابع را خواندم، دیدم کلاس 2PL کتابخانه را صدا میزند. Lambda هیچ جای تابع پاسخِ برازششده نیست؛ خطهای پردازش خروجی آن را بهصورت یک مقدار ثابت مینویسند. مدلی که واقعاً حدس را برآورد میکرد، یک مجانب پایین c را هم برازش میداد:
P = c + (1 - c) * sigmoid(a * (theta - b))
این تابع پاسخ با تابعی که اینجا برازش شده فرق دارد. این مورد را اول آوردم چون ارزانترین اشتباه کل این ماجراست و منتشر کردنش از همه خجالتآورتر است. گزارشی که بگوید پلتفرم یک 3PL برآورد میکند، خواننده را به مقایسه با راهنماهای 3PL میکشاند که اینجا کاربردی ندارند. در ادامهٔ مجموعه هر ضریبی ضریب 2PL است و Lambda یک ثابت ذخیرهشده.
آیا دانشآموزان کمتر با هم فرق داشتند؟
یکی از توضیحهای مطرح این بود که گروههای جدید به هم شبیهتر بودند. استدلال این بود که قدرت تمیز به تفاوت بین دانشآموزان نیاز دارد، پس یک گروه همگن منحنیهای تخت میدهد. آمار رسمی درسها امکان یک بررسی اولیه را میداد. در درس اصلی ریاضی هر رشته، درصد خام و بیشینهٔ قدرت تمیز ذخیرهشده اینطور بود:
| رشته | میانگین / انحراف معیار درصد خام در آزمون جاری | میانگین / انحراف معیار در آرشیو | بیشینهٔ a ذخیرهشده در ریاضی، جاری / آرشیو |
|---|---|---|---|
| ریاضی | 22.10 / 16.62 | 15.80 / 15.56 | حدود 0.90 / 1.54 |
| علوم تجربی | 8.60 / 14.47 | 5.10 / 11.13 | حدود 0.96 / 1.73 |
| علوم انسانی | 9.40 / 14.02 | 5.20 / 11.70 | حدود 1.22 / 1.72 |
در هر سه رشته، آزمون جدید پراکندگی بیشتری در نمرهٔ خام داشت و در هر سه، بیشینهٔ قدرت تمیز ذخیرهشدهاش پایینتر بود. نسخهٔ سادهٔ داستان همگنی خلاف این را پیشبینی میکند. با این حال جدول محدودیتهایی دارد و میخواهم ثبت شوند. اینها آمارهای ذخیرهشدهٔ مخصوص یک درساند، پس بیشینههای اینجا بیشینه روی همهٔ ردیفهای درس و زیردرس نیستند. انحراف معیار نمرهٔ خام نمرههای مشاهدهشده را توصیف میکند و انحراف معیار توانایی پنهان کمیت دیگری است. آزمونهای قدیم و جدید سؤالهای متفاوتی هم داشتند. جدول یک توضیح آسان را کنار میگذارد و علت را همچنان نامعلوم باقی میگذارد.
سه نوع تغییرپذیری
پیش از ادامه، بهتر است سه کمیتی را که در گفتوگو همه «تغییرپذیری» نامیده میشوند از هم جدا کنیم. هر کدام به سؤال متفاوتی جواب میدهد و قسمتهای بعدی آنها را با ابزارهای متفاوتی اندازه میگیرند.
| کمیت | چه چیزی تغییر میکند | به چه سؤالی جواب میدهد |
|---|---|---|
| توزیع بین سؤالها | سؤالهای مختلف در یک درس و یک سال | ضرایب برازششدهٔ سؤالها چقدر با هم فرق دارند؟ |
| تغییرپذیری نمونهگیری | دانشآموزانی که از یک استخر پاسخِ منجمدِ واحد (جامعهٔ در دسترس) انتخاب میشوند | وقتی نمونهٔ کالیبراسیون عوض میشود، جواب چقدر تغییر میکند؟ |
| تصادفی بودن آموزش | seed (بذر تصادفی) آموزش، با دقیقاً همان زیرمجموعهٔ پاسخها | برازش تصادفی چقدر جواب را تغییر میدهد؟ |
پراکندگی زیاد ضرایب بین سؤالهای یک آزمون چیزی دربارهٔ پایداری هیچ ضریب منفردی نمیگوید، و ضریبی که با بازنمونهگیری بهزحمت تکان میخورد ممکن است هنوز با seed بهینهساز جابهجا شود. قسمت ۵ کمیتهای دوم و سوم را اندازه میگیرد. هیستوگرامها و نمودارهای جعبهای قسمت ۶ اولی را نشان میدهند، و جعبهٔ باریک در آنجا به معنای بازهٔ اطمینان باریک برای هیچ سؤالی نیست.
خواندن کد
اولین سؤال عملی این بود که آیا دو مخزن کد پلتفرم پارامترهای یکسانی را با منطق و تنظیمات یکسان حساب میکنند. یکی از آنها آزمونهای تطبیقی را ارائه میداد. در قابلیتی که بررسی کردم، این مخزن پارامترهای موجود سؤال را از جدولهای سؤال خودش میخواند، و هیچ نقطهٔ ورود معادلی برای کالیبراسیون سرتاسری در آن پیدا نکردم. کسی هم نقطهٔ ورود دیگری برای بررسی در اختیارم نگذاشت. مخزن دوم همانی بود که کالیبراسیون را انجام میداد.
هر دو یک نسخهٔ داخلی (vendored) از py-irt داشتند، کتابخانهٔ متنباز IRT که روی Pyro ساخته شده است. چهار فایل آن را با SHA-256 مقایسه کردم: مدل 2PL، کلاس دیتاست، حلقهٔ آموزش و پیکربندی. هر چهار فایل در دو مخزن بایتبهبایت یکسان بودند.
یکسان بودن هشها دقیقاً یک چیز را ثابت میکند: اینکه آن چهار فایل یکساناند. هشها چیزی دربارهٔ این نمیگویند که هر سرویس کدام پاسخها را انتخاب میکند، آنها را چطور گروهبندی میکند، با چه تنظیمات زمان اجرایی کار میکند، یا اصلاً کالیبراسیونی اجرا میکند یا نه. اینجا در کد بررسیشدهٔ یکی از دو سرویس هیچ نقطهٔ ورود کالیبراسیونی پیدا نکردم، پس این تطابق درست بود و تقریباً بیربط. هشها نمیتوانند بار این ادعا را بکشند که هر دو برنامه یکسان کالیبره میکنند.
درون مخزنی که کالیبراسیون انجام میداد، دو مسیر کد به یک برآوردگر میرسید. مسیر اول رکوردهای پاسخ به تفکیک سؤال را از جدول فکت پاسخها در انبار دادهٔ تحلیلی میخواند، آنها را از طریق درخواست تحلیل فعال و جدولهای بُعد سؤال join میکرد، پاسخهای با وضعیت پاسخ ۵ (دیدهنشده) را کنار میگذاشت، بر اساس درسِ آزمون گروهبندی میکرد و برآوردگر را صدا میزد. مسیر دوم حول نتایج اجراهای آزمون ساخته شده بود. پاسخها و پاسخبرگهای فشرده را با رویههای ذخیرهشده (stored procedure) میگرفت، آنها را بر اساس آزمون، کاربر و محتوا ادغام میکرد، به پاسخهای پاسخبرگ اولویت میداد، هر گزینهٔ انتخابشده را با یک کلید پاسخ کششده تطبیق میداد، بر اساس درسِ آزمون و درس گروهبندی میکرد، همان کلاسهای 2PL را صدا میزد و مدلهای نتیجهٔ خودش را مینوشت. شکل کلی فراخوانی برآوردگر این بود:
trainer = TwoParamLog.train(data, device="cpu", epochs=2000)
params = trainer.best_params
پس کلاس مدل و فراخوانی آموزش مشترک بودند و ورودیها به شکل متفاوتی آماده میشدند. مسیر پاسخبرگ میتواند برای یک سؤالِ شناختهشده یک ورودی خالی را بهصورت یک ردیف پاسخ صریح بسازد، و چنین ردیفی خودبهخود معادل وضعیت دیدهنشده در جدول فکت نیست. یکی از شمارشهای خروجی این مسیر نامی دارد که «دانشآموزانی که پاسخ دادند» را به ذهن میآورد. این شمارش کاربرانی را میشمارد که در ورودی ادغامشده حضور دارند، و نامش بهتنهایی ثابت نمیکند که هر کدام از آنها واقعاً گزینهای انتخاب کرده باشد.
دو مسیر جدولهای نتایج متفاوتی را پر میکردند. ضرایبی که نگرانی دربارهٔ آنها بود در جدول نتایج اجراهای آزمون بودند، و یک جدول جداگانهٔ بانک محتوا کالیبراسیون دیگری را نگه میداشت. یکی گرفتن این دو شاخه یک اشتباه اولیه بود، و با دنبال کردن جدول سطح اجرا و کلیدهای اجرا و درس آن اصلاحش کردم. بعدها که جابهای پژوهشی را ساختم، آنها کلاسهای برآوردگر را مستقیم import میکردند و هیچوقت اندپوینت HTTP را که قابلیت نوشتن داشت صدا نزدند.
این مقایسه مرز مشخصی دارد. من کد منبع فعلی را مقایسه کردم، که با ممیزی تاریخی استقرارها فرق دارد. نتایج پژوهشی ذخیرهشده پیادهسازی رویههای ذخیرهشده، نسخههای مستقرشده، اسنپشاتهای دقیق ورودی در محیط عملیاتی یا وضعیتهای گذشتهٔ پیکربندی را ثابت نمیکنند. بنابراین نمیتوانم بگویم هر اجرای ذخیرهشده از قواعد ورودی همان مسیری استفاده کرده که بعدها برای پژوهش به کار بردم، و چنین چیزی هم نمیگویم.
ضریب، خروجی یک خط پردازش است
تا اینجا سؤال اصلی شکل دیگری پیدا کرده بود. «آیا سؤالهای جدید بدترند؟» مقدار ذخیرهشدهٔ a را ویژگی خود سؤال فرض میکند. در عمل، این مقدار انتهای زنجیرهای از تصمیمهاست: چه کسانی انتخاب شدند، پاسخهایشان چطور کدگذاری شد، کدام مدل و کدام پیشین برازش داده شد، بهینهساز چطور اجرا شد و کی متوقف شد، و عددها برای گزارش چطور تجمیع شدند. تا وقتی همهٔ حلقههای این زنجیره بررسی نشدهاند، نمیشود تفاوتی در خروجی را به کیفیت سؤال نسبت داد.
این نگاه یک برنامهٔ کاری هم به من داد. هر مرحله را میشد با معیار خودش بررسی کرد: جمعیت را در برابر پایگاه داده، مدل را در برابر کد منبعش، و برآوردگر را با آزمایشهای کنترلشدهای که میدانستم در آنها چه باید اتفاق بیفتد. بعضی از این بررسیها توضیحهایی را که بدیهی به نظر میرسیدند کنار گذاشتند، و یکی دو تا از آنها مشکلاتی در داده پیدا کردند که مدل بهتر هم حلشان نمیکرد. بقیهٔ مجموعه همین ترتیب را دنبال میکند.
قسمت ۲ از جمعیت شروع میکند: شش شمارش مشروع از «دانشآموزان» برای یک درس، و قاعدهٔ کدگذاریای که تعیین میکند سؤال بیپاسخ چه معنایی دارد.
این یادداشت به انگلیسی هم منتشر شده است: نسخهٔ انگلیسی.