

Sabit bir sınav her öğrenciye aynı kırk soruyu sorar. Güçlü öğrenciler zamanlarının çoğunu, kendileri hakkında yeni hiçbir şey söylemeyen sorulara harcar; daha zayıf öğrenciler ise cevaplama şanslarının düşük olduğu sorulara. Uyarlamalı bir test daha akıllıca bir şey yapar. Her cevaptan sonra öğrencinin yeteneğine dair tahminini günceller ve bu tahmin düzeyinde en çok bilgi verecek soruyu seçer. Genellikle sonuç, daha az soruyla aynı kesinliktir.
NovaTech'te, kişiselleştirilmiş ölçme-değerlendirme ve analitik için yaklaşık 89.000 öğrenciye hizmet veren, IRT tabanlı bir uyarlamalı test platformunun mimarisini tasarladım. Bu not modeli kısaca ele alıyor, ardından bir backend mühendisi olarak beni en çok ilgilendiren kısma geçiyor: seç, cevapla, güncelle döngüsünü, bir sınav penceresi açılıp herkes aynı anda başladığında da hızlı yanıt vermeye devam eden bir API'nin arkasına yerleştirmek.
Beş dakikada IRT
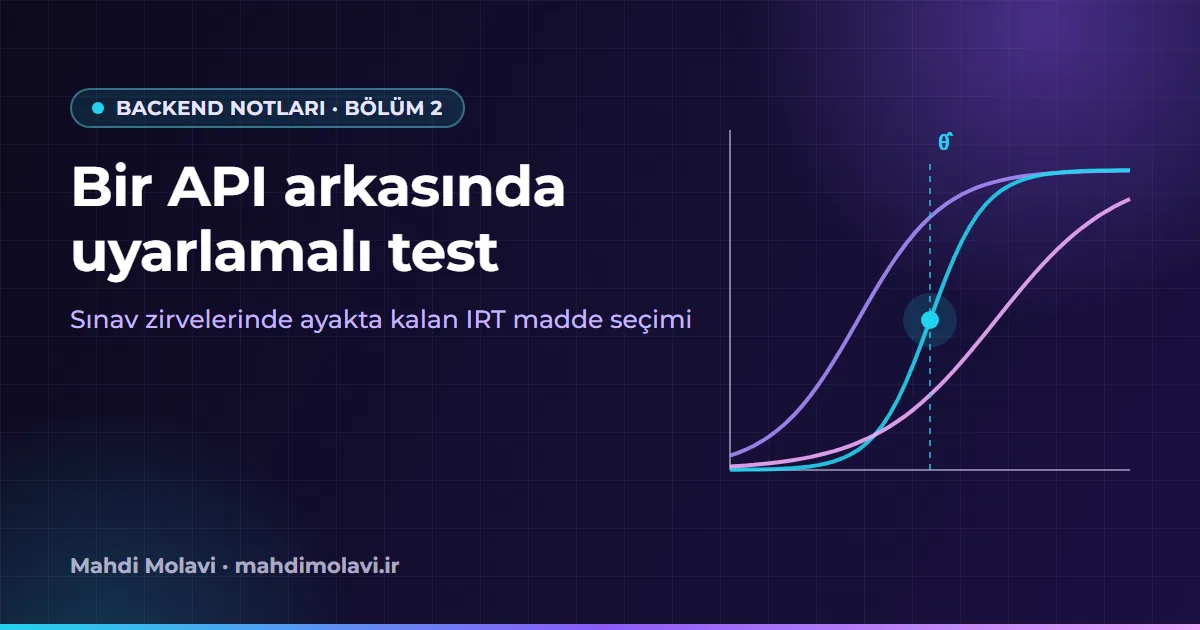
Madde tepki kuramı (item response theory), doğru cevap olasılığını θ (theta) ile gösterilen gizil bir yeteneğin ve maddenin birkaç parametresinin fonksiyonu olarak modeller. Yetenek standartlaştırılmış bir ölçek üzerindedir: θ = 0 kabaca kalibrasyon popülasyonunun ortalamasıdır ve öğrencilerin çoğu −3 ile 3 arasında yer alır.
- 1PL (Rasch): madde başına tek parametre, yani maddenin güçlüğü b. P(doğru) = 1 / (1 + e−(θ − b)); dolayısıyla θ = b noktasında olasılık %50'dir.
- 2PL: eğrinin b çevresinde ne kadar dik yükseldiğini belirleyen bir ayırt edicilik parametresi a ekler: P = 1 / (1 + e−a(θ − b)).
- 3PL: şansla doğru cevaplamayı (guessing) temsil eden bir alt asimptot c ekler; bu da çoktan seçmeli maddelere uyar: P = c + (1 − c) / (1 + e−a(θ − b)).
Bazı kaynaklar üssü D ≈ 1,7 ölçekleme sabitiyle çarpar. Hangisini seçtiğiniz fark etmez; yeter ki servis, parametreleri üreten kalibrasyonla aynı gösterimi kullansın.
Uyarlamalı seçimin arkasındaki fikir madde bilgisi (item information) kavramıdır. Her madde θ'nın bir bölgesinde iyi, başka bölgelerde zayıf ölçer. 2PL modeli için I(θ) = a² P(1 − P) olur ve θ = b noktasında en yüksek değerine ulaşır. 3PL için I(θ) = a² · ((P − c) / (1 − c))² · (1 − P) / P. Bilgi maddeler boyunca toplanır ve yetenek tahmininin standart hatası kabaca 1 / √(toplam bilgi) olur. Öğrencinin düzeyinde bilgi veren maddeleri seçmek, hatayı en hızlı biçimde küçültür.
Madde parametreleri, modeli önceki uygulamalardan gelen cevaplara uyduran kalibrasyondan gelir. Bu çevrim dışı bir istatistik işidir ve Python bunun için doğal bir ortamdır. Yeni maddelerin seçilebilmesi için önce parametrelerinin olması gerekir; bu yüzden yaygın bir uygulama, yeterli cevap birikene kadar onları puanlanmadan canlı testlerin içine yerleştirmektir. Çevrim içi servis yalnızca sonuçları kullanır.
Döngü
- θ hakkında bir önsel (prior) inançla başla; bu genellikle standart normal dağılımdır.
- Güncel tahmine, daha önce gösterilen maddelere ve testin içerik kurallarına göre bir sonraki maddeyi seç.
- Cevap: öğrenci cevap verir ve cevap kalıcı olarak saklanır.
- Yeni cevapla yetenek tahminini güncelle.
- Standart hata bir hedefin altına düştüğünde ya da test azami uzunluğuna ulaştığında dur; aksi hâlde 2. adıma dön.
Güncelleme için sabit bir θ değerleri ızgarası üzerinde EAP (expected a posteriori, beklenen sonsal) kestirimini tercih ederim. En çok olabilirlik (maximum likelihood) ders kitaplarındaki standart seçimdir, ama bir öğrenci her şeyi doğru ya da her şeyi yanlış cevapladığında sonlu bir sonuç vermez; ilk birkaç maddeden sonra durum çoğu zaman budur. EAP sonlu kalmak için önseli kullanır ve bir ızgara üzerinde düz aritmetikten ibarettir. Ayrıca artımlıdır: n cevaptan sonraki sonsal (posterior), n − 1 cevaptan sonraki sonsalın tek bir olabilirlik eğrisiyle çarpımıdır; dolayısıyla oturum durumunun bu kısmı tek bir dizidir.
public sealed record Item(int Id, double A, double B, double C, string Area);

public static class Irt
{
    public static double P(Item item, double theta) =>
        item.C + (1 - item.C) / (1 + Math.Exp(-item.A * (theta - item.B)));

    public static double Information(Item item, double theta)
    {
        var p = P(item, theta);
        var x = (p - item.C) / (1 - item.C);
        return item.A * item.A * x * x * (1 - p) / p;
    }
}

public static class Eap
{
    // 61 quadrature points from -4 to 4
    public static readonly double[] Grid =
        Enumerable.Range(0, 61).Select(i => -4 + i * 8.0 / 60).ToArray();

    public static double[] Prior() =>
        Normalize(Grid.Select(t => Math.Exp(-0.5 * t * t)).ToArray());

    public static double[] Update(double[] posterior, Item item, bool correct)
    {
        var next = new double[Grid.Length];
        for (var i = 0; i < Grid.Length; i++)
        {
            var p = Irt.P(item, Grid[i]);
            next[i] = posterior[i] * (correct ? p : 1 - p);
        }
        return Normalize(next);
    }

    public static (double Theta, double Se) Summarize(double[] posterior)
    {
        double mean = 0, variance = 0;
        for (var i = 0; i < Grid.Length; i++) mean += Grid[i] * posterior[i];
        for (var i = 0; i < Grid.Length; i++) variance += Math.Pow(Grid[i] - mean, 2) * posterior[i];
        return (mean, Math.Sqrt(variance));
    }

    private static double[] Normalize(double[] w)
    {
        var sum = w.Sum();
        for (var i = 0; i < w.Length; i++) w[i] /= sum;
        return w;
    }
}
Her cevaptan sonra normalize etmek, test ne kadar uzun sürerse sürsün değerleri rahat bir sayısal aralıkta tutar. Izgara boyutu bir ödünleşimdir. −4 ile 4 arasında altmış bir nokta makul bir başlangıçtır; daha sık bir ızgaranın bedelini ödemeden önce, bunun herhangi bir nihai puanı değiştirip değiştirmediğine bakın.
Bir sonraki maddeyi seçmek
Ders kitabı kuralı maksimum bilgidir: güncel tahminde I(θ̂) değeri en yüksek olan kullanılmamış maddeyi seçmek. Olduğu gibi uygulandığında bu kuralın, canlı ortamda önem taşıyan iki sorunu vardır.
Açığa çıkma (exposure). Maksimum bilgi, ayırt ediciliği yüksek aynı birkaç maddeyi seçip durur. Öğrencilerin büyük bir kısmı bu maddeleri görür, maddeler sızar ve bankanın geri kalanı atıl kalır. Yaygın çözümler şunlardır: randomesque seçim (en iyi k madde arasından rastgele seçim), Sympson-Hetter açığa çıkma kontrolü (her maddeye simülasyonla ayarlanan bir uygulanma olasılığı verilir) ve a-tabakalama (θ henüz belirsizken başta düşük ayırt edicilikli maddeleri kullanmak, keskin olanları sonraya saklamak).
İçerik dengesi. θ'yı kesin biçimde ölçen ama hiç geometri sormayan bir matematik testi geçerli bir matematik testi değildir. Kingsbury ve Zara'nın kısıtlı CAT yaklaşımının ruhuna uygun en basit yöntem, önce hedef payının en çok altında kalan içerik alanını seçer ve ancak ondan sonra o alan içinde bilgiyi maksimize eder. Her adımda bir optimizasyon problemi çözen van der Linden'in gölge testleri (shadow tests) gibi daha ağır araçlar da var, ama basit versiyon çoğu durumda epey yol alır.
public sealed class ItemSelector(IReadOnlyList<Item> bank, IReadOnlyDictionary<string, double> targets)
{
    public Item? Next(double theta, IReadOnlySet<int> used,
                      IReadOnlyDictionary<string, int> givenPerArea, int topK = 5)
    {
        var total = Math.Max(1, givenPerArea.Values.Sum());

        // 1. content balancing: the area furthest below its target share that still has items
        var area = targets
            .OrderByDescending(t => t.Value - givenPerArea.GetValueOrDefault(t.Key) / (double)total)
            .Select(t => t.Key)
            .FirstOrDefault(a => bank.Any(i => i.Area == a && !used.Contains(i.Id)));
        if (area is null) return null;

        // 2. maximum information within that area, 3. randomesque exposure control
        var candidates = bank
            .Where(i => i.Area == area && !used.Contains(i.Id))
            .OrderByDescending(i => Irt.Information(i, theta))
            .Take(topK)
            .ToList();
        return candidates[Random.Shared.Next(candidates.Count)];
    }
}
Bu, banka üzerinde doğrusal bir taramadır ve birkaç bin madde için tek bir ağ gidiş-dönüşünden çok daha ucuzdur. Profil ölçümleri bir gün aksini söylerse, banka yüklenirken her maddenin her ızgara noktasındaki bilgisini bir kez hesaplayın; seçim de en yakın ızgara indeksinde basit bir aramaya dönüşür.
Madde bankasını önbelleğe almak
Madde parametreleri küçüktür ve nadiren değişir: madde başına birkaç sayı, artı bir içerik alanı ve durum bayrakları. Bu da onları süreç içi bir önbellek için ideal kılar. Her API instance'ı aktif bankayı, bir banka versiyonuyla etiketlenmiş değiştirilemez (immutable) bir nesne olarak bellekte tutar. Yeni bir kalibrasyonu yayımlamak SQL Server'a satırlar yazar, versiyonu artırır ve instance'lara, düzenli olarak kontrol ettikleri bir Redis anahtarı ya da bir pub/sub mesajı aracılığıyla yeniden yüklemelerini söyler. Instance'lar referansı atomik olarak değiştirir; böylece hâlihazırda işlenmekte olan bir istek, başladığı bankayla tamamlanır.
Bunu güvenli tutan iki kural var. Bir oturum, başladığı banka versiyonunu kaydeder; böylece hiçbir öğrenci iki farklı kalibrasyonun parametreleriyle puanlanmaz. Bu da önceki versiyonu, onunla başlayan oturumlar bitene kadar yüklü tutmak demektir. Ayrıca madde metinleri ve cevap anahtarları bu nesnenin parçası değildir. Yalnızca gösterilen madde için getirilirler ve cevap anahtarı sunucudan asla çıkmaz.
API'nin yapısı
| Endpoint | Amaç |
|---|---|
POST /sessions | Bir test başlatır: oturum durumunu (önsel, boş geçmiş, banka versiyonu) oluşturur ve ilk maddeyi döndürür. |
POST /sessions/{id}/responses | Bir cevap gönderir. Yanıt, bir sonraki maddeyi ya da bir tamamlanma sinyalini taşır. |
GET /sessions/{id} | Yeniden bağlandıktan sonra kaldığı yerden devam eder: ilerlemeden güncel maddeyi döndürür. |
GET /sessions/{id}/result | Oturum tamamlandıktan sonra puan ve rapor. |
Bir sonraki maddeyi cevap isteğinin yanıtında döndürmek soru başına bir gidiş-dönüş kazandırır; bu da bir test boyunca ve bir zirve boyunca birikir. Cevap endpoint'i ayrıca idempotent olmalıdır. Kararsız bir mobil bağlantıda istemci isteği yeniden dener ve yeniden denenen bir cevap iki kez sayılmamalı ya da testi iki kez ilerletmemelidir. SQL Server'da (session, item) üzerinde bir unique constraint ve kopya bir istek geldiğinde zaten seçilmiş olan sonraki maddeyi döndürmek, bu sorunu temiz biçimde çözer.
Sınav zirvelerinde hızlı kalmak
IRT'nin aritmetiği ucuzdur: 61 nokta üzerinde bir EAP güncellemesi ve banka üzerinde tek bir geçiş, küçük bir CPU işidir; bir veritabanı gidiş-dönüşünden çok daha azdır. Sistemin dayanıp dayanmayacağını belirleyen, matematiğin etrafındaki her şeydir. NovaTech platformunda değerlendirme oluşturma, puanlama, raporlama ve madde seçimi iş akışlarını geliştirdim ve bunların yoğun sınav dönemlerinde ayakta kalması gerekiyordu. Bu tür bir servis için izlediğim ilkeler:
- Seçim yolunda veritabanı okuması yok. Banka bellektedir; oturum durumu (sonsal, kullanılmış maddeler, alan sayıları) testten daha uzun bir TTL ile Redis'te durur. Her cevabın maliyeti bir kalıcı yazma ve küçük bir durum güncellemesidir.
- Önce kalıcı kayıt, sonra önbellek. Cevap, Redis'teki durum değişmeden önce SQL Server'a yazılır. Redis bir oturumu kaybederse, saklanan cevaplar aynı güncelleme fonksiyonundan yeniden geçirilerek oturum yeniden oluşturulabilir; bu da o fonksiyonu deterministik tutmak için bir neden daha.
- Durumsuz (stateless) API instance'ları. Her instance her isteğe hizmet verebilir; bu yüzden bir sınav penceresinden önce yatay ölçeklendirme yalnızca bir yapılandırma değişikliği gerektirir.
- Ağır işler istek yolunun dışında. Raporlar ve analizler, bir oturum tamamlandıktan sonra asenkron olarak hesaplanır. Bir sonraki soruyu bekleyen bir öğrenci asla başkasının raporunu beklememelidir.
- Pencere açılmadan önce sistemi ısıtın. Bankayı yükleyin, her instance'ın aynı versiyonu çalıştırdığını doğrulayın ve sınav gününden epey önce gerçekçi düşünme süreleriyle bir yük testi çalıştırın.
Puanlama için son bir not. Nihai θ kalibrasyon ölçeğindedir ve kimse −0,37 diye bir puan görmek istemez. Onu bir raporlama ölçeğine dönüştürün ve sayı kesinmiş gibi davranmak yerine standart hatayı bir aralık olarak gösterin.
Uyarlamalı ya da yüksek trafikli bir ölçme-değerlendirme sistemi planlıyorsanız, bu tam da üstlendiğim türden bir backend işi. Bir sonraki not alandan bir adım geri çekilip kodun kendisine dönüyor: gerçek bir .NET servisini Minimal APIs ile nasıl yapılandırdığım.
Bu not İngilizce ve Farsça olarak da yayımlandı: İngilizce · Farsça.