یک تجزیه فقط وقتی جالب است که کمکمان کند کاری انجام دهیم. در این قسمت tc-SVD را (همان تجزیه با مرز آینهای از قسمت سوم) برای دو کار روزمرهٔ یادگیری ماشین به کار میبرم: طبقهبندی تصویرها و خوشهبندیشان. عددهای پایاننامه را همانطور که هستند میآورم، حتی جاهایی که tc-SVD برنده نشد.
تصویرها چطور تانسور میشوند؟
هر تصویر یک ماتریس n1×n3 است. بهجای اینکه آن را به یک بردار صاف کنم، میانگین تصویرها را از آن کم میکنم و حاصل را به پهلو میچرخانم تا یک اسلایس جانبی از تانسور شود، یعنی بلوکی n1×1×n3. اگر همهٔ تصویرهای آموزشی را کنار هم بچینیم، یک تانسور n1×m×n3 داریم که هر اسلایس جانبیاش یک تصویر است. تصویر در تمام این مدت شکل دوبُعدیاش را حفظ میکند.
دو راه برای طبقهبندی
رویکرد اول روشی است که کیلمر و همکارانش برای t-SVD پیشنهاد دادند و من آن را به tc-SVD تعمیم دادم. تانسور آموزشی را تجزیه میکنیم، k اسلایس جانبی اول U را نگه میداریم و از آنها بهعنوان پایه استفاده میکنیم. هر نمونهٔ آموزشی و آزمایشی روی این پایه تصویر میشود و برای هرکدام یک اسلایس کوچک k×1×n3 از ضرایب به دست میآید. سپس ضریبهای تصویر آزمایشی با ضریبهای آموزشی مقایسه میشود. یک راستیآزمایی جالب: اگر تصویرها فقط یک ستون داشته باشند (n3 = ۱)، این روش دقیقاً به همان PCA کلاسیک تبدیل میشود.
رویکرد دوم پیشنهاد خود پایاننامه است. بهجای یک پایهٔ مشترک، برای هر کلاس یک پایهٔ tc-SVD جداگانه به نام Ui میسازد. برای طبقهبندی یک تصویر آزمایشی، سعی میکنیم آن را با پایهٔ هر کلاس بازسازی کنیم و ببینیم چهقدر باقی میماند:
label = argmini ‖ B − Ui ∗c UiT ∗c B ‖
کلاسی که پایهاش تصویر را بهتر توضیح بدهد، یعنی کمترین باقیمانده را داشته باشد، برنده است. روش سادهای است، آموزشی جز همان تجزیهها لازم ندارد و اضافه کردن یک کلاس جدید فقط یعنی محاسبهٔ یک پایهٔ دیگر، بدون دست زدن به بقیه.
نتایج طبقهبندی
آزمایشها روی دو مجموعهدادهٔ استاندارد انجام شد. MNIST شامل ۷۰٬۰۰۰ رقم دستنویس ۲۸×۲۸ پیکسلی است که ۱۰٬۰۰۰تای آن برای آزمایش کنار گذاشته شده. CBCL (از MIT) یک مجموعهٔ تشخیص چهره با تصویرهای ۱۹×۱۹ است: ۲٬۴۲۹ چهره و ۴٬۵۴۸ غیرچهره برای آموزش و ۴۷۲ چهره و ۲۳٬۵۷۳ غیرچهره برای آزمایش.
از نظر دقت، tc-SVD تقریباً همپای روش t-SVD کیلمر بود. تفاوت این دو در سرعت بود: چون DCT همهچیز را در اعداد حقیقی نگه میدارد، نسخههای tc-SVD تقریباً نصف زمان را گرفتند.
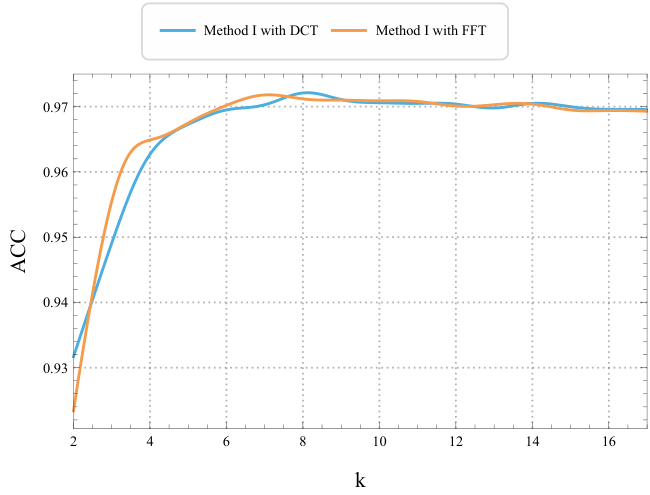
دقت روی MNIST بر حسب k، تعداد اسلایسهای نگهداشتهشده: منحنیهای DCT (tc-SVD) و FFT (t-SVD) تقریباً روی هم افتادهاند، حوالی ۹۷٪.
نرخ خطای هر رقم نشان میدهد سختی کجاست. با نگه داشتن k = ۷ اسلایس، رقم ۱ فقط در ۰٫۵۳٪ موارد اشتباه تشخیص داده شد و رقم ۰ در ۰٫۸۲٪. سختترین رقمها ۸ (۴٫۶٪)، ۴ و ۷ (هرکدام ۴٫۴٪) و ۳ (۳٫۸٪) بودند. میانگین روی ده رقم میشود حدود ۲٫۸٪ خطا. از k حدود ۷ یا ۸ به بعد، اضافه کردن اسلایس بیشتر کمکی نکرد؛ اسلایسهای اضافه اطلاعات تازهٔ چندانی ندارند.
خوشهبندی؛ فشردن داده از دو طرف
در خوشهبندی برچسبی در کار نیست، پس هدف پیدا کردن نمایش کوچکی است که k-means در آن خوب کار کند. در tc-SVD تانسور داده، U و S بین همهٔ نمونهها مشترکاند و اطلاعات مخصوص هر نمونه در V نشسته است. برای همین یک V بریدهشده را بهعنوان تانسور ویژگی نگه میدارم.
k-means در ابعاد بالا معمولاً به مشکل میخورد، پس یک قدم دیگر هم اضافه کردم: مُدهای V را جابهجا میکنم و دوباره روی آن tc-SVD میگیرم تا جهت دیگر هم کوچک شود. اسم این کار را برش دوسمتی گذاشتهام. ویژگیهای نهایی از هر دو جهت کوچکاند و k-means روی همینها اجرا میشود.
این روش را با t-SVD (با همان دو نسخهٔ یکسمتی و دوسمتی)، NMF و HOSVD روی چهار مجموعه تصویر مقایسه کردم:
- ORL: ۴۰۰ تصویر چهره از ۴۰ نفر، ۶۴×۶۴
- PIE-pose: ۲٬۸۵۶ تصویر از ۶۸ نفر، ۳۲×۳۲
- Extended Yale B (زیرمجموعه): ۱٬۷۱۰ تصویر از ۳۸ نفر، ۱۹۲×۱۶۸
- COIL-100: ۷٬۲۰۰ تصویر از ۱۰۰ شیء، ۱۲۸×۱۲۸
این جدول بهترین NMI (اطلاعات متقابل نرمالشده؛ هرچه بیشتر بهتر) هر روش را بهصورت میانگین ده اجرا نشان میدهد:
| Method | ORL | PIE-pose | Yale B | COIL-100 |
|---|---|---|---|---|
| tc-SVD | 0.670 | 0.986 | 0.784 | 0.621 |
| tc-SVD, two-sided | 0.730 | 0.973 | 0.799 | 0.680 |
| t-SVD | 0.605 | 0.983 | 0.670 | 0.593 |
| t-SVD, two-sided | 0.636 | 0.994 | 0.756 | 0.583 |
| NMF | 0.694 | 0.847 | 0.636 | 0.730 |
| HOSVD | 0.706 | 0.909 | 0.756 | 0.749 |
tc-SVD دوسمتی روی ORL و Yale B بهترین نتیجه را داد. روی PIE-pose همهٔ نسخههای t-SVD و tc-SVD نزدیک به کامل بودند و t-SVD دوسمتی کمی جلوتر ایستاد. روی COIL-100، HOSVD و NMF بهتر عمل کردند؛ پس مرز آینهای برندهٔ همیشگی نیست.
نسخهٔ یکسمتی tc-SVD روی همهٔ مجموعهها از نسخهٔ یکسمتی t-SVD سریعتر بود. روی ORL، Yale B و COIL-100 کمتر از نصف زمان را گرفت (۲۴٫۹ در برابر ۵۸٫۷ روی Yale B و ۲۴٫۸ در برابر ۶۲٫۳ روی COIL-100، با همان واحد زمانی که در پایاننامه گزارش شده). روی PIE-pose اختلاف حدود ۱۳ درصد بود و آنجا نسخهٔ دوسمتی tc-SVD حتی از نسخهٔ دوسمتی t-SVD کندتر بود. HOSVD روی Yale B و COIL-100 از این هم سریعتر بود (۲۱٫۱ و ۱۵٫۱) و NMF روی COIL-100 به ۱٬۲۲۵ واحد زمان نیاز داشت.
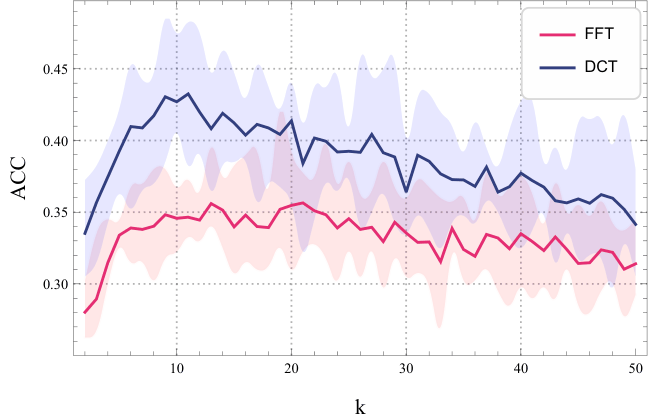
دقت خوشهبندی روی ORL برای kهای مختلف: DCT (tc-SVD) در تمام بازه بالاتر از FFT (t-SVD) میماند. نوارهای کمرنگ پراکندگی بین اجراها را نشان میدهند.
برداشت من
در این آزمایشها tc-SVD در بیشتر موارد از نظر دقت همسطح t-SVD یا بهتر از آن بود و تقریباً در همهٔ مقایسهها سریعتر، اغلب دو برابر یا بیشتر. روی ORL و Yale B مرز آینهای خوشههای محسوساً بهتری هم داد، ولی روی COIL-100 هیچکدام از دو SVD تانسوری به HOSVD و NMF نرسیدند. برای دادههای بزرگ، کم شدن چشمگیر زمان اجرا با همان دقت، اغلب همان نتیجهای است که در عمل بیشترین اهمیت را دارد.
قسمت آخر این مجموعه روش را از دنیای بنچمارک بیرون میبرد: شناسایی اختلال شناختی خفیف اولیه با تصویربرداری مغز و بهروز نگه داشتن تجزیه وقتی داده مدام از راه میرسد.
بخشی از مجموعهای بر اساس پایاننامهٔ کارشناسی ارشد من، «یادگیری کلانداده با نمایش تانسوری»، به راهنمایی دکتر منصور رزقی در دانشگاه تربیت مدرس.
این یادداشت به انگلیسی هم منتشر شده است: نسخهٔ انگلیسی.