Bir ayrışım ancak bir işe yaradığında ilginçtir. Bu notta, üçüncü bölümdeki ayna sınırlı ayrışım olan tc-SVD'yi makine öğrenmesinin iki gündelik işi için kullanıyorum: görüntüleri sınıflandırmak ve kümelemek. Tezimdeki sayıları, tc-SVD'nin kazanmadığı durumlar da dâhil olmak üzere olduğu gibi göstereceğim.
Görüntüler nasıl tensöre dönüşür
Her görüntü n1×n3 boyutunda bir matristir. Onu bir vektöre düzleştirmek yerine ortalama görüntüyü çıkarıyor ve sonucu yan çevirerek bir tensörün yanal dilimi, yani n1×1×n3 boyutunda bir blok hâline getiriyorum. Tüm eğitim görüntülerini yan yana koyduğunuzda, her görüntü için bir yanal dilim içeren tek bir n1×m×n3 tensör elde edersiniz. Görüntü bu süreç boyunca iki boyutlu şeklini korur.
Sınıflandırmanın iki yolu
Yaklaşım I, Kilmer ve arkadaşlarının t-SVD için önerdiği yöntemi izliyor; ben bu yöntemi tc-SVD'ye genelleştirdim. Eğitim tensörünü ayrıştırın, U'nun ilk k yanal dilimini tutun ve bunları taban olarak kullanın. Her eğitim görüntüsü ve her test görüntüsü bu tabana izdüşürülür; böylece her biri için küçük bir k×1×n3 katsayı dilimi elde edilir. Ardından test görüntüsü eğitim katsayılarıyla karşılaştırılır. Güzel bir sağlama: görüntüler tek sütundan oluşuyorsa (n3 = 1), yöntem tam olarak klasik PCA'ya indirgenir.
Yaklaşım II ise tezde önerilen yeni bir yöntem. Tek bir ortak taban yerine her sınıf için ayrı bir tc-SVD tabanı Ui oluşturur. Bir test görüntüsünü sınıflandırmak için onu her sınıfın tabanından yeniden oluşturmaya çalışırsınız ve geriye ne kaldığını ölçersiniz:
etiket = argmini ‖ B − Ui ∗c UiT ∗c B ‖
Tabanı görüntüyü en iyi açıklayan, yani artığı en küçük olan sınıf kazanır. Yöntem basittir, ayrışımların ötesinde bir eğitim gerektirmez ve yeni bir sınıf eklemek, diğerlerine dokunmadan bir taban daha hesaplamak demektir.
Sınıflandırma sonuçları
İki standart veri seti üzerinde test ettim. MNIST, 28×28 piksellik 70.000 el yazısı rakam içerir; bunların 10.000'i test için ayrılmıştır. CBCL (MIT'den) 19×19 görüntülerden oluşan bir yüz tespiti veri setidir: eğitim için 2.429 yüz ve 4.548 yüz olmayan görüntü, test için 472 yüz ve 23.573 yüz olmayan görüntü.
Doğruluk açısından tc-SVD, Kilmer'in t-SVD yöntemiyle neredeyse tamamen aynı noktaya geldi. İkisi arasındaki fark hızdaydı: DCT her şeyi gerçel sayılarda tuttuğu için tc-SVD sürümleri kabaca yarı sürede tamamlandı.
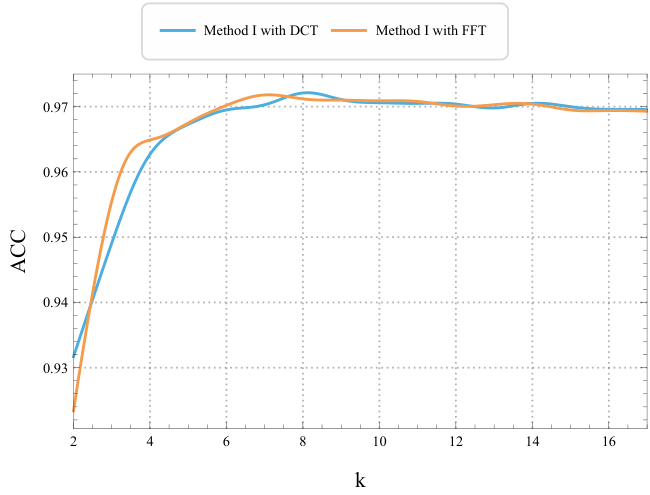
Tutulan dilim sayısı k'ye göre MNIST doğruluğu: DCT (tc-SVD) ve FFT (t-SVD) eğrileri %97 civarında üst üste biniyor.
Rakam bazında hata oranları zorluğun nerede olduğunu gösteriyor. k = 7 tutulan dilimle 1 rakamı yalnızca %0,53 oranında, 0 ise yalnızca %0,82 oranında yanlış sınıflandırıldı. En zor rakamlar 8 (%4,6), 4 ve 7 (her biri %4,4) ve 3 (%3,8) oldu. On rakamın ortalaması alındığında bu, yaklaşık %2,8'lik bir hata oranı demek. k yaklaşık 7 veya 8'i geçtikten sonra daha fazla dilim eklemek işe yaramadı; ek dilimler çok az yeni bilgi taşıyor.
Kümeleme: veriyi iki taraftan sıkıştırmak
Kümelemede etiket yoktur, bu yüzden amaç k-means'in iyi çalıştığı küçük bir temsil bulmaktır. Veri tensörünün tc-SVD'sinde U ve S tüm örneklerde ortaktır; her örneğin kendine ait bilgisi V'de bulunur. Bu yüzden özellik tensörü olarak kesilmiş bir V tutuyorum.
k-means'in yüksek boyutlarda zorlandığı bilinir; bu yüzden ikinci bir adım ekledim: V'yi permüte edip ona yeniden tc-SVD uyguluyor, böylece diğer yönü de küçültüyorum. Buna iki taraflı kesme diyorum. Son özellikler her iki yönde de küçüktür ve k-means bunların üzerinde çalışır.
Bu yöntemi t-SVD (aynı tek ve iki taraflı varyantlarıyla), NMF ve HOSVD ile dört görüntü koleksiyonu üzerinde karşılaştırdım:
- ORL: 40 kişiye ait 400 yüz görüntüsü, 64×64
- PIE-pose: 68 kişiye ait 2.856 görüntü, 32×32
- Extended Yale B (alt küme): 38 kişiye ait 1.710 görüntü, 192×168
- COIL-100: 100 nesneye ait 7.200 görüntü, 128×128
Her yöntemin ulaştığı en iyi NMI değeri (normalleştirilmiş karşılıklı bilgi; yüksek olan daha iyidir), on çalıştırmanın ortalaması olarak:
| Yöntem | ORL | PIE-pose | Yale B | COIL-100 |
|---|---|---|---|---|
| tc-SVD | 0,670 | 0,986 | 0,784 | 0,621 |
| tc-SVD, iki taraflı | 0,730 | 0,973 | 0,799 | 0,680 |
| t-SVD | 0,605 | 0,983 | 0,670 | 0,593 |
| t-SVD, iki taraflı | 0,636 | 0,994 | 0,756 | 0,583 |
| NMF | 0,694 | 0,847 | 0,636 | 0,730 |
| HOSVD | 0,706 | 0,909 | 0,756 | 0,749 |
İki taraflı tc-SVD, ORL ve Yale B'de en iyi sonucu verdi. PIE-pose'da tüm t-SVD ve tc-SVD varyantları mükemmele yakındı; iki taraflı t-SVD az farkla öndeydi. COIL-100'de HOSVD ve NMF daha iyi sonuç verdi; yani ayna sınırı her durumda kazanan değil.
Tek taraflı tc-SVD, her veri setinde tek taraflı t-SVD'den daha hızlıydı. ORL, Yale B ve COIL-100'de t-SVD'nin yarısından da kısa sürdü (tezde raporlanan çalışma süresi birimleriyle Yale B'de 24,9'a karşı 58,7 ve COIL-100'de 24,8'e karşı 62,3). PIE-pose'da fark yaklaşık %13'tü ve orada iki taraflı tc-SVD aslında iki taraflı t-SVD'den daha yavaştı. HOSVD, Yale B ve COIL-100'de daha da hızlıydı (21,1 ve 15,1); NMF'nin COIL-100'deki süresi ise 1.225'ti.
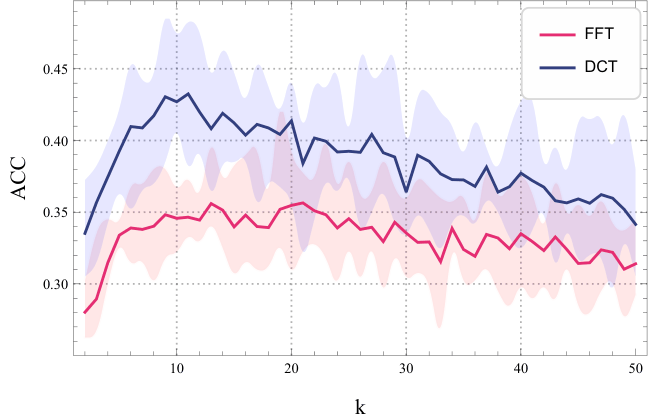
Farklı k değerleri için ORL'de kümeleme doğruluğu: DCT (tc-SVD) tüm aralık boyunca FFT'nin (t-SVD) üzerinde kalıyor. Gölgeli bantlar çalıştırmalar arasındaki yayılımı gösteriyor.
Bundan çıkardığım sonuç
Bu deneylerde tc-SVD, doğrulukta çoğu durumda t-SVD'ye denk ya da ondan daha iyi sonuç verdi ve neredeyse her karşılaştırmada, çoğu zaman iki kat veya daha fazla farkla, daha hızlıydı. ORL ve Yale B'de ayna sınırı belirgin biçimde daha iyi kümeler de verdi; COIL-100'de ise iki tensör SVD'sinden hiçbiri HOSVD'ye veya NMF'ye yetişemedi. Büyük veride, doğruluk aynı kalırken çalışma süresinin ciddi biçimde kısalması pratikte çoğu zaman en önemli sonuçtur.
Serinin son notu yöntemi benchmark dünyasının dışına çıkarıyor: beyin taramalarında erken evre hafif bilişsel bozukluğu tespit etmek ve veri gelmeye devam ederken bir ayrışımı güncel tutmak.
Tarbiat Modares Üniversitesinde Dr. Mansoor Rezghi danışmanlığında hazırladığım “Tensör Temsiliyle Büyük Veri Öğrenimi” başlıklı yüksek lisans tezime dayanan bir serinin parçasıdır.
Bu not İngilizce ve Farsça olarak da yayımlandı: İngilizce · Farsça.