

قسمت قبل را با یک گلایهٔ کوچک از t-SVD تمام کردم: ساختار بلوکی چرخشیاش فرض میکند بُعد سوم دور خودش میچرخد، یعنی اسلایس آخر همسایهٔ اسلایس اول است. این قسمت دربارهٔ کاری است که با همین گلایه کردم. نتیجهاش یک ضرب تانسوری بر پایهٔ تبدیل کسینوسی است که اسمش را ضرب tc گذاشتم، و تجزیهای که روی آن ساخته میشود: tc-SVD. ضربی بسیار نزدیک به این، بر پایهٔ همین تبدیل کسینوسی، در مقالهٔ کرنفلد، کیلمر و آئرون (۲۰۱۵) هم آمده است. سهم پایاننامه در بخش یادگیری است: فشردهسازی، طبقهبندی، خوشهبندی و بهروزرسانی جریانی بر پایهٔ tc-SVD، و آزمایشهایی که پشت آنهاست.
ضرب t در واقع یک پیچش است
سادهترین راه دیدن مشکل، مسئلهٔ رفع ماتی تصویر است؛ جایی که همین ریاضیات دوباره پیدا میشود. پیکسل ماتشده، جمع وزنداری از همسایههایش است: yi = Σ hi−j xj، که h همان هستهٔ ماتی است. نزدیک لبهٔ تصویر، این جمع به پیکسلهایی نیاز دارد که بیرون از قاب افتادهاند. آنها را نداریم، پس ناچاریم چیزی فرض کنیم. به این فرض میگویند شرط مرزی.
سادهترین انتخاب مرز تناوبی است: فرض میکنیم تصویر تکرار میشود، پس هرچه از لبهٔ راست بیرون بزند از لبهٔ چپ برمیگردد. در این حالت ماتی به یک ماتریس چرخشی تبدیل میشود و FFT همهچیز را سریع حل میکند. ضرب t دقیقاً همین مدل است که در راستای مُد سوم تانسور اعمال شده؛ به همین دلیل در قسمت دوم FFT آن را ارزان کرد.
مشکل اینجاست که تقریباً هیچچیز در دنیای واقعی تناوبی نیست. لبهٔ راست یک عکس ربطی به لبهٔ چپش ندارد و چسباندن این دو به هم پرشی میسازد که هیچوقت در داده نبوده. در بازسازی تصویر، مرز تناوبی معمولاً کنار لبهها اثر ناخواسته به جا میگذارد. انگ، چان و تانگ (۱۹۹۹) نشان دادند که مرز انعکاسی بازسازی بهتری میدهد و هزینهاش هم همان O(n log n) است.
بهجایش آینه بگذاریم
مرز انعکاسی فرض میکند تصویر به شکل تصویر آینهای خودش ادامه پیدا میکند. پیکسلِ درست بیرون لبه، برابر پیکسلِ درست داخل آن است. هیچ پرش ساختگیای در کار نیست و برای تصویرها این فرض خیلی طبیعیتر است.
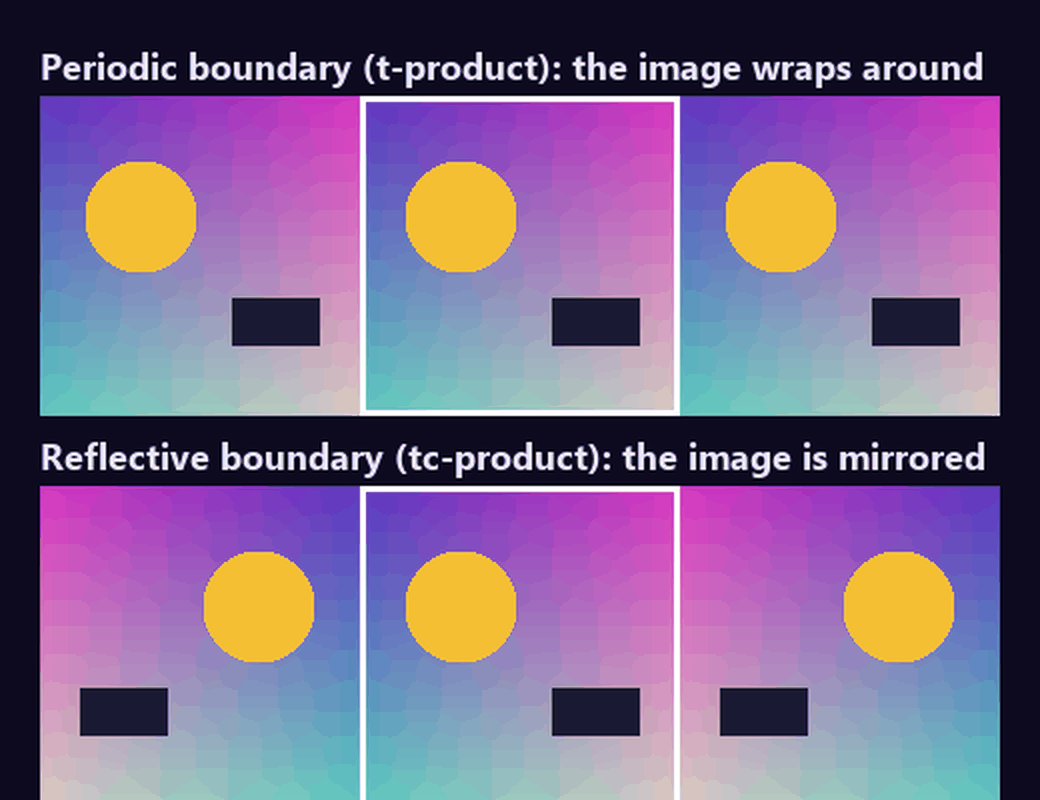
یک تصویر (داخل قاب) که به دو روش ادامه داده شده. مرز تناوبی لبههای ناهمخوان را به هم میچسباند؛ مرز انعکاسی نرم و پیوسته ادامه میدهد.
با مرز انعکاسی، ماتریس ماتی دیگر چرخشی نیست و به یک ماتریس توپلیتس بهعلاوهٔ هنکل تبدیل میشود. شاید بدتر به نظر برسد، اما یک نتیجهٔ شناختهشده به کار میآید: برای هستههای متقارن، ماتریسهایی با این شکل با تبدیل کسینوسی گسسته (DCT) قطری میشوند، همانطور که ماتریسهای چرخشی با FFT قطری میشوند. هزینهٔ DCT هم O(n log n) است.
از یک بُعد تا تانسور: ضرب tc
در پایاننامه این ایده را به تانسورها تعمیم دادهام. بهجای اینکه اسلایسهای روبهروی تانسور را در یک ماتریس بلوکی چرخشی بچینم، آنها را در یک ماتریس بلوکی توپلیتس بهعلاوهٔ هنکل میچینم و نشان میدهم که DCT در راستای مُد سوم آن را بلوکقطری میکند. ضرب tc دو تانسور به این شکل انجام میشود:
- هر دو تانسور را در راستای مُد سوم به حوزهٔ یک تبدیل مبتنی بر DCT میبریم.
- اسلایسهای روبهرویشان را دوبهدو، مثل ماتریسهای معمولی، در هم ضرب میکنیم.
- حاصل را به فضای اصلی برمیگردانیم.
این ضرب ویژگیهایی را که برای جبر خطی لازم داریم حفظ میکند: خطی و شرکتپذیر است، عضو همانی و ترانهاده دارد و تانسور متعامد در آن تعریف میشود. اگر DCT به شکل متعامد یکه به کار رود، ضرب در تانسور متعامد نرم فروبنیوس را هم حفظ میکند.
یک برتری عملی هم دارد. FFT حتی وقتی داده حقیقی است با عدد مختلط کار میکند؛ DCT نه، و همهچیز حقیقی میماند. در آزمایشهای من نسخههای مبتنی بر DCT تقریباً در همهٔ مقایسهها سریعتر بودند و اغلب تقریباً نصف زمانِ نسخههای مبتنی بر FFT را گرفتند.
tc-SVD
با داشتن ضرب tc، SVD هم همان الگوی قبل را دنبال میکند: A = U ∗c S ∗c VT که در آن U و V متعامدند و S f-قطری است. برای محاسبهاش در راستای مُد سوم DCT میگیریم، روی هر اسلایس روبهرو یک SVD معمولی اجرا میکنیم و عاملها را برمیگردانیم. مثل t-SVD، اگر فقط k جملهٔ اول را نگه داریم، بهترین تقریب در نرم فروبنیوس در میان تانسورهایی با رتبهٔ حداکثر k (تحت همین ضرب) به دست میآید؛ همان ویژگیای که tc-SVD را برای فشردهسازی و یادگیری مفید میکند.
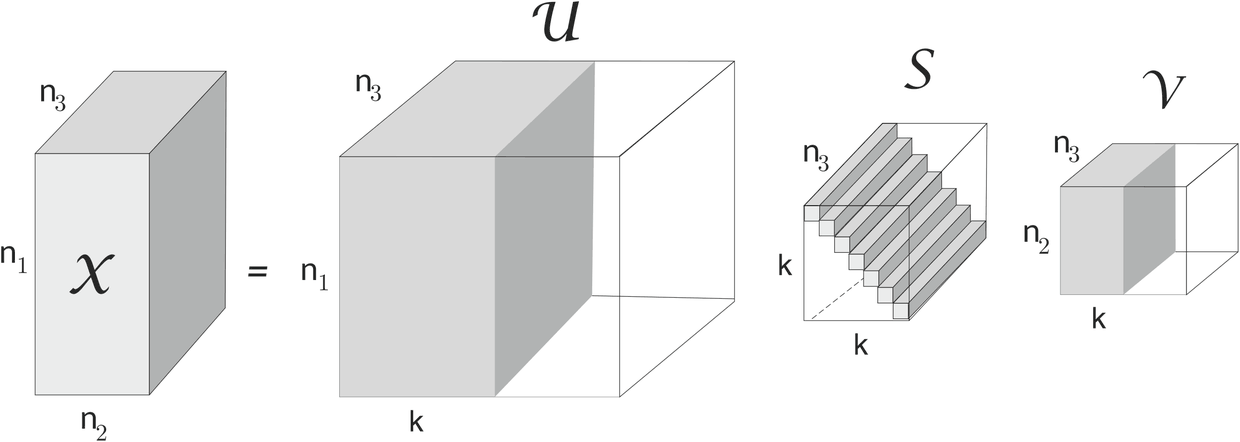
tc-SVD بریدهشده: فقط k اسلایس جانبی از U و V و k تیوب قطری از S نگه داشته میشود.
این هم یک پیادهسازی کوتاه با NumPy و SciPy. برای خوانایی مستقیم از DCT متعامد یکه استفاده کردهام. تبدیل دقیقِ متناظر با ضرب توپلیتس بهعلاوهٔ هنکل، علاوه بر DCT، یک مقیاس قطری و جمع هر اسلایس با اسلایس بعدی را هم دارد (مانند کار کرنفلد، کیلمر و آئرون، ۲۰۱۵)، اما شکل کلی الگوریتم همین است.
import numpy as np
from scipy.fft import dct, idct

def c_product(A, B):
    Ac = dct(A, type=2, norm="ortho", axis=2)
    Bc = dct(B, type=2, norm="ortho", axis=2)
    return idct(np.einsum("ijk,jlk->ilk", Ac, Bc), type=2, norm="ortho", axis=2)

def tc_svd(A):
    Ac = dct(A, type=2, norm="ortho", axis=2)   # real numbers only
    n1, n2, n3 = A.shape
    U, S, V = np.zeros((n1, n1, n3)), np.zeros((n1, n2, n3)), np.zeros((n2, n2, n3))
    for k in range(n3):
        u, s, vh = np.linalg.svd(Ac[:, :, k])
        U[:, :, k], V[:, :, k] = u, vh.T
        S[:len(s), :len(s), k] = np.diag(s)
    back = lambda T: idct(T, type=2, norm="ortho", axis=2)
    return back(U), back(S), back(V)

A = np.random.rand(6, 5, 4)
U, S, V = tc_svd(A)
Vt = np.transpose(V, (1, 0, 2))                 # transpose every frontal slice
print(np.allclose(A, c_product(c_product(U, S), Vt)))   # True
اگر با کد t-SVD قسمت دوم مقایسهاش کنید، نه عدد مختلطی در کار است و نه حسابوکتاب مزدوجها.
میانبری برای فشردهسازی
راه واضح فشرده کردن تانسور با tc-SVD این است که فقط k جملهٔ اول را نگه داریم. در پایاننامه رویکرد دوم و ارزانتری هم آوردهام که اصلاً نیازی به محاسبهٔ کل تجزیه ندارد. همهٔ اسلایسهای روبهرو را با هم جمع میکنیم تا یک ماتریس به دست بیاید، یک SVD از همین جمع میگیریم و k1 بردار تکین چپ و k2 بردار تکین راست را نگه میداریم. بعد هر اسلایس را از یک طرف در ترانهادهٔ بردارهای چپِ بریدهشده و از طرف دیگر در بردارهای راست ضرب میکنیم تا یک هستهٔ کوچک k1×k2 به دست بیاید. این کار جواب میدهد چون در این ضرب، جمع اسلایسهای U ∗c S ∗c VT بهخوبی به حاصلضرب جمع اسلایسهای U، S و V شکسته میشود.
در قسمت بعد tc-SVD را روی مسئلههای واقعی امتحان میکنیم: طبقهبندی ارقام دستنویس و چهرهها و خوشهبندی چند مجموعه تصویر، با مقایسهٔ بیکموکاست عددها در برابر t-SVD، HOSVD و NMF.
بخشی از مجموعهای بر اساس پایاننامهٔ کارشناسی ارشد من، «یادگیری کلانداده با نمایش تانسوری»، به راهنمایی دکتر منصور رزقی در دانشگاه تربیت مدرس.
این یادداشت به انگلیسی هم منتشر شده است: نسخهٔ انگلیسی.