

Saniyede 25 kare hızında, 768×576 piksellik, otuz saniyelik gri tonlamalı bir video klip düşünün. Bu 750 kare eder ve her kare 442.368 sayıdan oluşan bir ızgaradır. Makine öğrenmesi kütüphanelerinin çoğu bu veriyle çalışmaya başlamadan önce, standart tarif her kareyi ya da klibin tamamını tek bir uzun vektöre çevirmenizi ister.
Kodun çalışması anlamında bu yöntem işe yarar, ama verinin geometrisi yolda kaybolur. Görüntüde yan yana duran iki piksel, vektörde yüzlerce konum uzağa düşebilir. Ardışık iki karedeki aynı piksel ise daha da uzağa düşer. Artık model, verinin size bedavaya verdiği yapıyı yeniden keşfetmek zorundadır.
Tarbiat Modares Üniversitesindeki yüksek lisans araştırmam tam da bu sıkıntıdan doğdu: büyük veri setlerinden, onları önce düzleştirmeden nasıl öğrenilir? Üzerinde çalıştığım yanıt tensördü. Bu not, tezime dayanan kısa bir serinin ilki ve serinin geri kalanı için gereken temel kavramları anlatıyor.
Düzleştirme neden zarar verir
Burada iki ayrı sorun var ve bunları birbirinden ayrı tutmak işe yarar.
Yapıyı kaybedersiniz. Bir görüntü bir sayı torbası değildir; komşu pikseller birbiriyle güçlü biçimde ilişkilidir, komşu kareler de öyle. Vektörleştirme bu geometriyi ve onunla birlikte bir modelin kullanabileceği bilgiyi çöpe atar.
Boyutların bedelini ödersiniz. Uzun vektörler devasa bir özellik uzayı demektir. Örnek sayısı sabitken özellik eklemek, bir noktadan sonra tahminleri kötüleştirir. Buna Hughes fenomeni (1968) denir ve Bellman'ın boyut laneti adını verdiği olgunun bir yüzüdür. Fatura bellek ve zaman olarak da gelir: m örnek için bir kernel SVM eğitmek kabaca O(m³) zaman ve O(m²) bellek ister; n özellik için PCA ya da doğrusal regresyonun maliyeti yaklaşık O(mn² + n³) olur. Büyük veride ne m küçüktür ne de n.
Tensör nedir (bizim amacımız için)
Matematikçiler ve fizikçiler bu kelimeyi beraberinde epey ağır bir kuramsal donanımla kullanır. Veriyle çalışırken bir tensörü çok boyutlu bir dizi olarak düşünebilirsiniz. Boyut sayısına tensörün mertebesi, her bir boyuta da mod denir. Tek bir sayı sıfırıncı mertebeden, bir vektör birinci mertebeden, bir matris ikinci mertebedendir. Gri tonlamalı klibimiz 576×768×750 boyutunda üçüncü mertebeden bir tensördür: yükseklik, genişlik ve kareler. Renk kanallarını da tutarsanız dördüncü mertebeden olur.
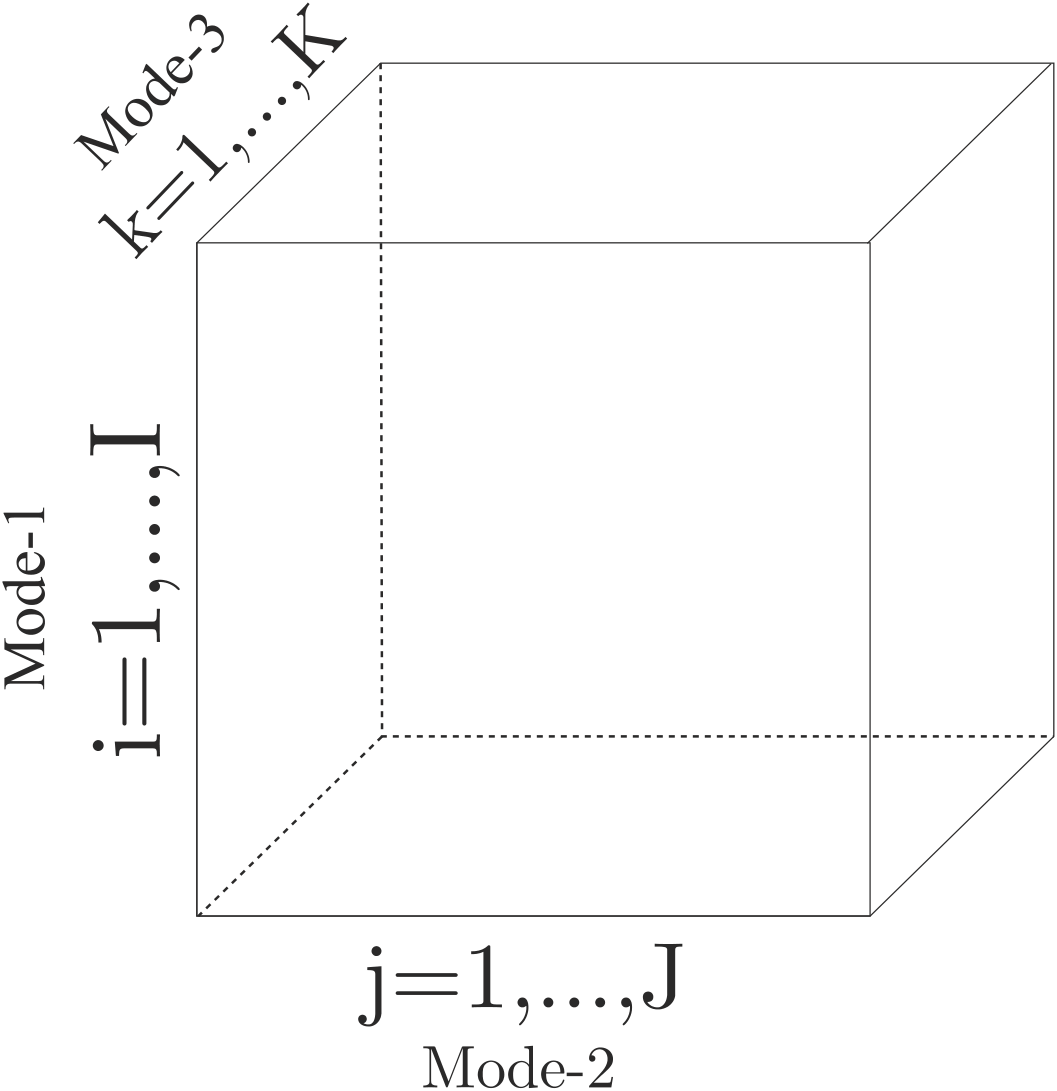
Üçüncü mertebeden bir tensör ve üç modu.
Lifler ve dilimler
İki kavram, tensörler üzerine düşünmeyi kolaylaştırır.
Lif, biri hariç tüm indisleri sabitlediğinizde elde ettiğiniz şeydir. Üçüncü mertebeden bir tensörde sütun lifleri, satır lifleri ve tüp lifleri vardır. Video örneğinde bir tüp lifi, zaman içinde takip edilen tek bir pikseldir; düzleştirmenin yok ettiği yapı da tam olarak budur.
Dilim ise iki indis dışındaki tüm indisleri sabitler, yani bir matristir. Video için doğal olanlar ön dilimlerdir: her ön dilim bir karedir. Yatay ve yanal dilimler aynı veri bloğunu diğer iki yönden keser.
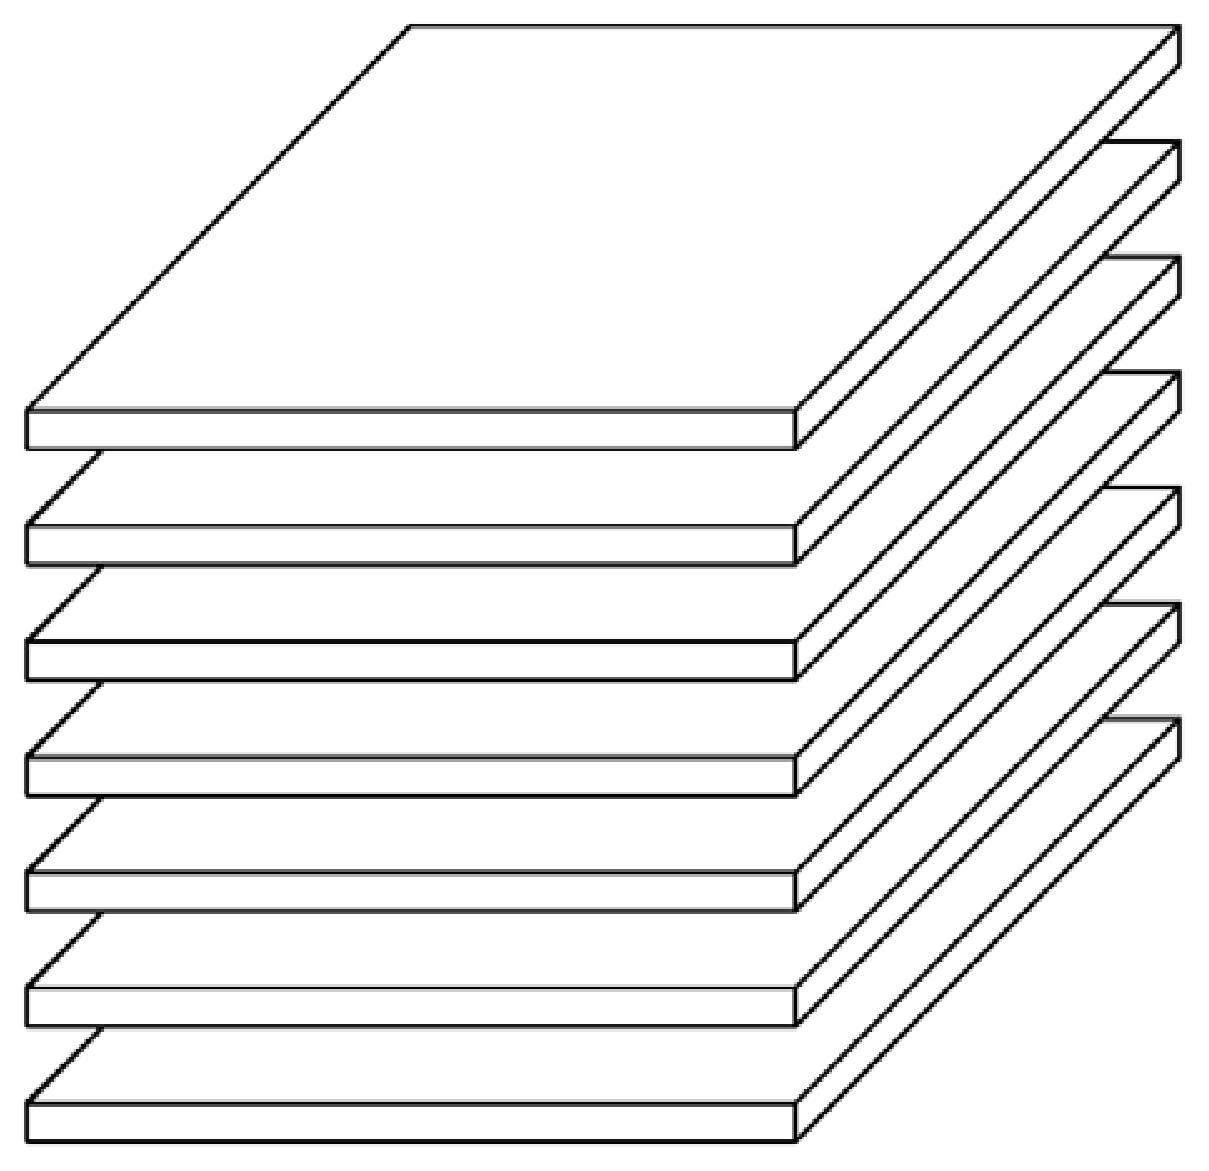
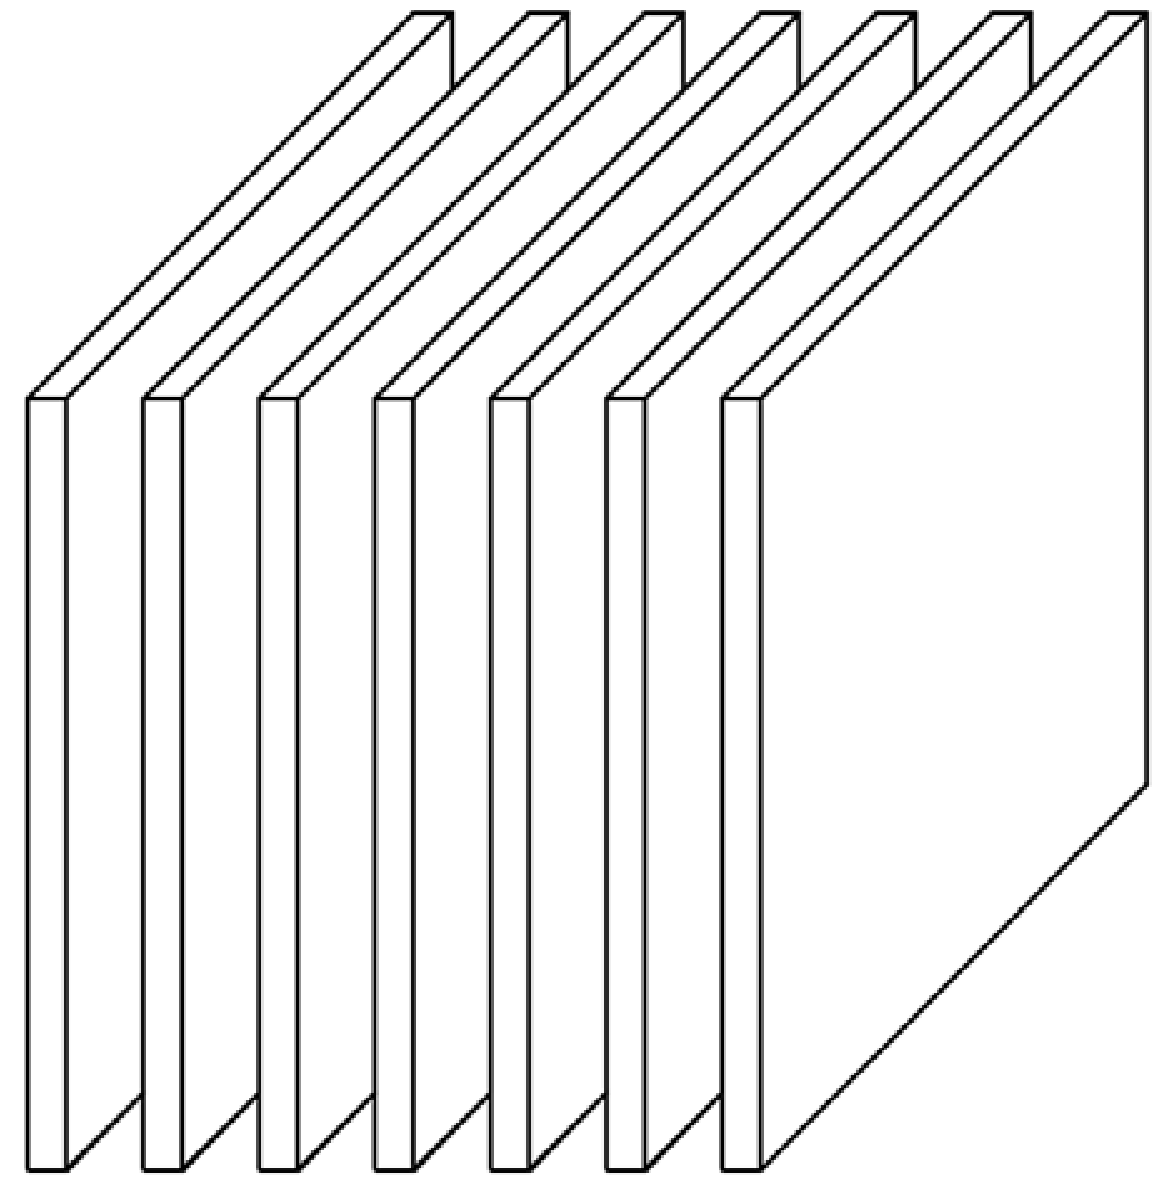
Aynı tensörün yatay dilimleri (solda) ve yanal dilimleri (sağda).
Açılım: matris algoritmalarıyla konuşmak
Er ya da geç, zaten güvendiğiniz matris araçlarını kullanmak istersiniz. Açılım (matrisleştirme olarak da bilinir), bir tensörün mod-n liflerini bir matrisin sütunları olarak dizer. 3×4×2 boyutundaki bir tensör mod 1 boyunca açıldığında 3×8'lik bir matris olur: iki ön dilim yan yana konur. Mod 2 boyunca açarsanız bu kez dilimlerin devriklerini elde edersiniz. Her açılım aynı verinin yalnızca başka bir görünümüdür; hiçbir şey atılmaz.
Mod-n çarpımı: boyutları birer birer küçültmek
En çok kullandığım işlem mod-n çarpımı. Tensörün her mod-n lifini aynı U matrisiyle çarparsınız. U'nun satır sayısı o modun eleman sayısından azsa, diğer modlar olduğu gibi kalırken o mod küçülür. Tezde bunu, bir tensörün 2. modunu 8'den 2'ye indirerek gösteriyorum. U'nun satırları ortonormal olduğunda her mod-n lifi birkaç doğrultuya izdüşürülür; bu, veriyi temel bileşenlere izdüşürmenin tensördeki karşılığıdır. Bu serideki her ayrışım bu işlemi kullanır.
İki işlemin de kısa bir NumPy sürümü şöyle:
import numpy as np

def unfold(X, mode):
    # the mode-n fibers become the columns of a matrix
    return np.moveaxis(X, mode, 0).reshape(X.shape[mode], -1, order="F")

def mode_n_product(X, U, mode):
    # multiply every mode-n fiber of X by the matrix U
    Y = U @ unfold(X, mode)
    rest = [s for i, s in enumerate(X.shape) if i != mode]
    return np.moveaxis(Y.reshape([U.shape[0]] + rest, order="F"), 0, mode)

X = np.random.rand(3, 8, 5)
U = np.random.rand(2, 8)
print(mode_n_product(X, U, 1).shape)   # (3, 2, 5)
Ayrışımların devreye girdiği yer
Veriyi tensör olarak saklamak yapısını korur; tasarruf ise onu, SVD'nin bir matrisi ayrıştırdığı gibi ayrıştırmaktan ve yalnızca bilgi taşıyan kısımları tutmaktan gelir. Klasik seçenekler, bir tensörü rank-bir parçaların toplamı olarak yazan CP ayrışımı ile küçük bir çekirdek tensör ve her mod için bir faktör matrisi kullanan, genellikle yüksek mertebeli SVD (HOSVD) ile hesaplanan Tucker ayrışımıdır.
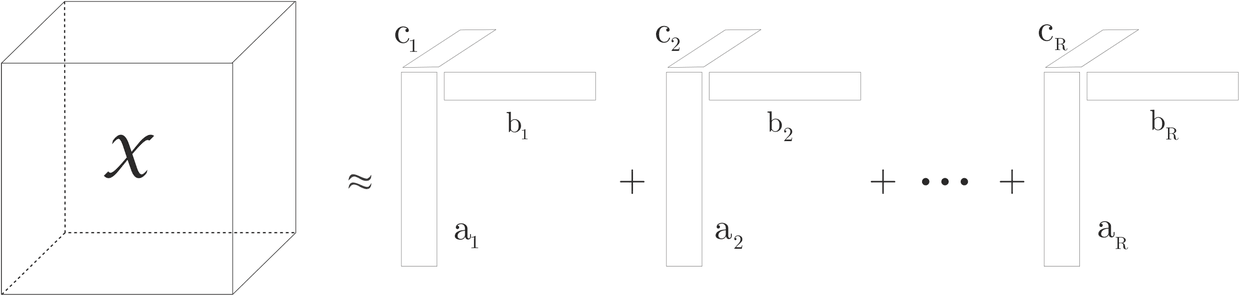
CP ayrışımı: R adet rank-bir tensörün toplamı.
İkisi de faydalı, ama benim ilgilendiğim öğrenme problemlerine üçüncü bir aile daha iyi uydu: matris SVD'sinin optimal kesme özelliğini koruyan t-çarpımı ve t-SVD. Bir sonraki notun konusu bu. Ardından kendi geliştirdiğim kısım geliyor: t-SVD'nin içinde gizli olan dairesel varsayımı bir aynayla değiştiren, tc-SVD adlı bir varyant.
t-SVD'ye ilk bakış
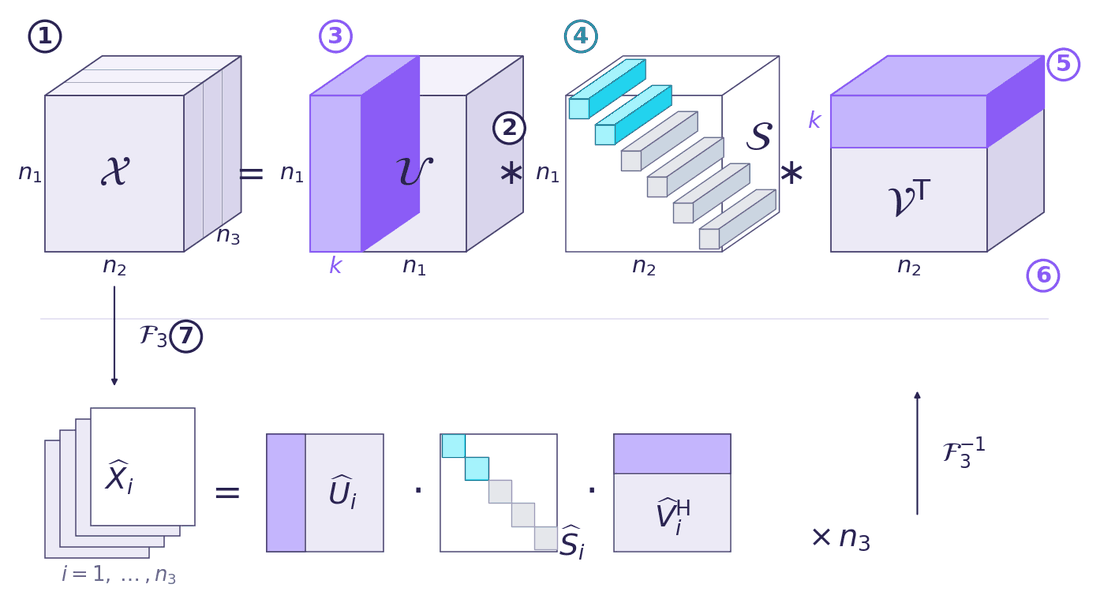
Açıklamalı t-SVD. Mor ve camgöbeği, k ranklı bir kesmenin koruduğu kısımları gösterir; numaralar aşağıda açıklanıyor.
Bir sonraki not bu ayrışımı adım adım kuruyor, ama şemayı şimdiden okuyabilirsiniz. X (1), n1×n2×n3 boyutundaki veridir; ∗ (2) ise üçüncü mod boyunca işleyen bir çarpma olan t-çarpımıdır. U (3) ortogonaldir; yanal dilimleri bir taban görevi görür ve mor blok bunların ilk k tanesidir. S (4) f-köşegendir: yalnızca köşegeni boyunca uzanan tüpler sıfırdan farklıdır ve ilk k tanesi (camgöbeği) korunur. VT (5), ortogonal bir V'nin t-devriğidir; mor satırları her örneği korunan tabanla eşleştirir. Yalnızca renkli kısımları, her birinden k tane (6) tutmak X ≈ Uk ∗ Sk ∗ VkT yaklaşımını verir. Alt satır (7) yöntemin neden ucuz olduğunu gösterir: üçüncü mod boyunca bir FFT'den (tc-SVD'de DCT'den) sonra tüm çarpanlara ayırma işlemi, her ön dilim için bir tane olmak üzere n3 adet sıradan matris SVD'sine dönüşür.
Bu seri, Tarbiat Modares Üniversitesinde Dr. Mansoor Rezghi danışmanlığında hazırladığım “Tensör Temsiliyle Büyük Veri Öğrenimi” başlıklı yüksek lisans tezime dayanıyor. Tezin kısa bir özeti burada.
Bu not İngilizce ve Farsça olarak da yayımlandı: İngilizce · Farsça.