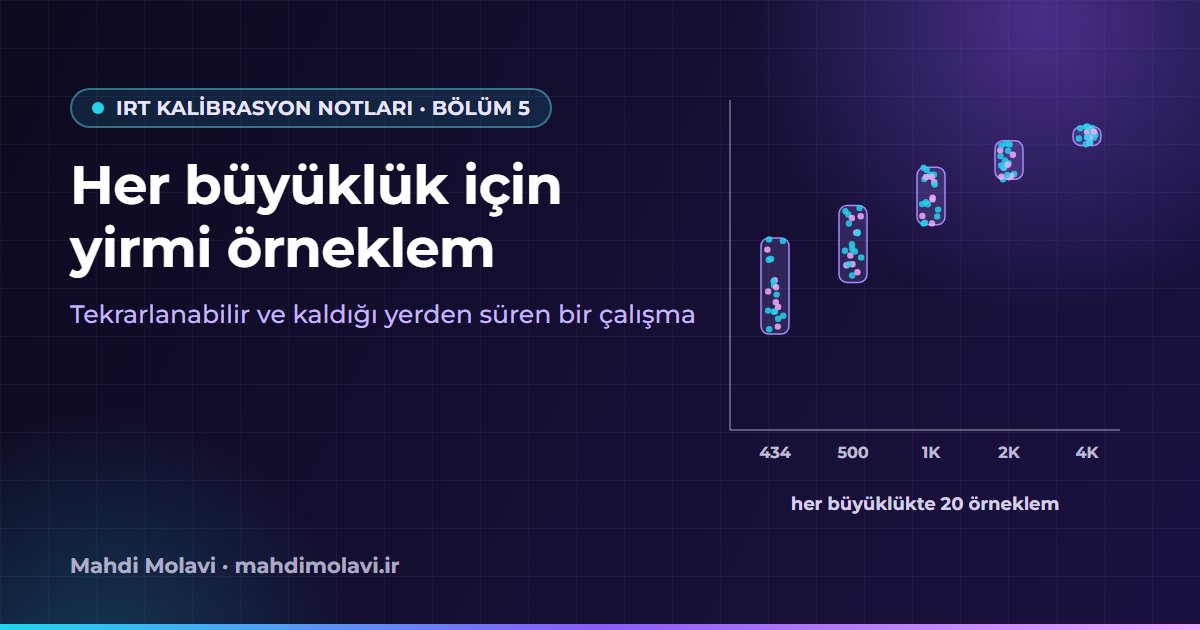
Şimdiye kadarki her deney örneklem büyüklüğü başına tek bir alt küme ya da birkaç tane kullandı. Bu, yerel kestiricinin katsayılarının sabit sorularda N ile birlikte oynadığını gösterdi. Ama bu oynamanın ne kadarının o an hangi öğrencilerin çekildiğinden kaynaklandığını, ya da örüntünün alanlar ve yıllar boyunca geçerli olup olmadığını söyleyemedi. Bunun için tekrarlı bir örnekleme çalışması gerekiyordu ve emeğin çoğu altyapıya gitti: deterministik örnekleme, kimliği belirlenip yeniden kullanılabilen kestirimler, kesintiden sağ çıkan kontrol noktaları (checkpoint) ve farklı istatistiksel birimleri birbirinden ayrı tutan bir çıktı dosyası.
Talep ilk başta on iki sınavdan söz ediyordu. Onaylanan ve uygulanan kapsam dokuz sınavdı: üç alan (Matematik, Deneysel Bilimler ve Beşerî Bilimler), 1403, 1404 ve 1. bölümdeki özgün 1405 formlarında.
Tasarım
Örnekleme birimi öğrenciydi ve örnekleme her uygun ders için ayrı yapıldı. Bir dersin havuzu, o derste geçerli puanı ve en az bir kullanılabilir yanıtı olan herkesten oluşuyordu; uygunluk ve yanıt kodlama kuralları 2. bölümdekilerle aynıydı. Her havuzdan:
- hedef büyüklükler 434, 500, 1.000, 2.000, 4.000 ve 8.000'di, yinelenen büyüklükler çıkarıldı;
- mümkün olan her büyüklük ve ders 20 tekrar aldı ve her tekrar yerine koymadan yapılan bir seçimdi;
- bir tekrar içinde her büyük örneklem tek bir rastgele permütasyonun önekiydi; böylece 500 kişilik örneklem 434 kişilik örneklemi içeriyordu ve yukarıya doğru bu böyle sürüyordu;
- havuzdan büyük bir büyüklük atlandı ve atlandığı kaydedildi; eksik kalan yer hiçbir zaman aynı kişileri tekrarlayarak doldurulmadı;
- her ders ayrıca kendi havuzunun tamamı üzerinde, referans noktası işlevi gören bir kestirim aldı;
- her ana kestirimde eğitim seed'i 42 kullanıldı; ayrı bir kontrol ise ilk temel alt kümeyi, içindeki kişileri sabit tutarak 42'den 46'ya kadarki seed'lerle yeniden kestirdi.
İç içe yapı, büyüklük karşılaştırmalarını eşleştirilmiş hâle getiriyor: N = 4.000'deki r tekrarı, N = 434'teki r tekrarından yalnızca eklenen kişilerle ayrılıyor. Her tekrar kendi permütasyonunu çektiği için bir öğrenci birkaç tekrarda yer alabilir, ama tek bir örneklemin içinde hiçbir zaman iki kez bulunmaz.
Tam havuz kestirimi bir referanstır, asla gerçek parametre değeri değildir. 3. bölümdeki dar önselle bu kestirim, eldeki en büyük N'deki kestirimden ibarettir.
Beşerî Bilimler içindeki ayrı müfredat kolunun popülasyonları küçüktü; bu yüzden iki dersine kendi ortak temel büyüklükleri verildi: Arapça için 226, tarih/coğrafya için 221. Arapça dersinin tanımlayıcısı yıllar arasında değiştiği için, karşılaştırılabilir ders eşlemesi özgün tanımlayıcıları korurken yıllar arası karşılaştırmayı mümkün kıldı. Bu müfredat baştan sona standart Beşerî Bilimler'den ayrı tutuldu. Toplamda 52 ders-yıl grubu vardı: 48 standart alan grubu ve ayrı müfredat kolunda uygun dört grup. Aktif ders istatistiği olmayan eski bir ders satırı ek bir ders sayılmadı.
Deterministik bir örnekleme tarifi
Belirli bir sınav, ders ve tekrarın örneklemi, işler hangi sırayla çalışırsa çalışsın her çalıştırmada aynı olmalıydı. NumPy'nin SeedSequence sınıfı bunu sabit bir tamsayı listesinden yapıyor. Genel biçimde, örnek amaçlı bir taslak (seed malzemesi çalışmadakiyle aynı; üreteç, hash ve dtype seçimleri benim):
import hashlib
import numpy as np

def replicate_permutation(pool, exam_id, lesson_key, replicate):
    # pool: anonymized student indices in a fixed, canonical order
    ss = np.random.SeedSequence([STUDY_CONSTANT, exam_id, lesson_key, replicate])
    return np.random.default_rng(ss).permutation(pool)

def nested_samples(permutation, sizes):
    for n in sorted(set(sizes)):
        if n > len(permutation):
            yield n, None                 # recorded as Skipped, never padded
        else:
            yield n, permutation[:n]      # prefix: smaller samples nest in larger ones

def fit_key(lesson, n, selected, training_seed):
    ids = np.unique(selected)             # sorted and unique
    fingerprint = hashlib.sha256(ids.astype("<i8").tobytes()).hexdigest()
    return (lesson, n, fingerprint, training_seed)
Çalışma sabiti bir tarihe benziyor, ama çalıştırmalar arasında hiç değişmeyen tek bir sabit sayı. Tekrar indeksi seed malzemesinin parçası olduğu için 7. tekrar, 1'den 6'ya kadarki tekrarların önce çalışıp çalışmadığına bağlı değil. Bu türden her tarif, permütasyondan önce havuzu kararlı bir sıraya da koymak zorunda; yoksa aynı seed farklı kişileri seçer.
Tarifin ikinci yarısı kimlik. Seçimden sonra, seçilen öğrenci indekslerinin (2. bölümdeki anonim, ders başına indeksler) sıralanmış ve tekrarsız dizisi hash'lenerek bir popülasyon parmak izine dönüşüyor. Kestirim anahtarı (fit key) da dersi, N'yi, bu parmak izini ve eğitim seed'ini birleştiriyor. Anahtarı aynı olan iki istek aynı kişileri aynı seed'le kestirir, bu yüzden ikincisi birincinin sonucunu yeniden kullanabilir. Yeniden kullanım hesaplamadan tasarruf sağlar. Kanıt eklemez ve muhasebenin bunu göstermesi gerekir.
Çalıştırmaları dürüstçe saymak
| Muhasebe kategorisi | Sayı |
|---|---|
| Tasarlanan istenen çalıştırmalar, desteklenmeyen büyüklükler dâhil | 6,632 |
| Başarılı yürütülebilir istekler | 4,852 |
| Ayrı girdi/seed kestirimleri | 4,760 |
| Aynı girdi/seed kestirimini yeniden kullanan istekler | 92 |
| Desteklenmeyen büyüklük/ders kombinasyonları | 89 |
| Bu desteklenmeyen kombinasyonlarda istenen tekrarlar | 1,780 |
| 20 tekrarı tamamlanmış örneklem grupları | 227 |
| Nihai başarısız / bekleyen çalıştırmalar | 0 / 0 |
4.852 başarılı istek; 4.540 örneklem kaydından (20'şerlik 227 tam grup), 52 tam havuz kaydından ve 260 optimize edici kontrol kaydından (beş seed'de 52 ders) oluşuyor. 89 desteklenmeyen kombinasyon 1.780 istenen tekrara karşılık geliyor ve 4.852 artı 1.780, tasarlanan 6.632'yi veriyor. Başarılı isteklerin 92'si daha önce kestirilmiş bir girdi ve seed'e denk geldi; geriye 4.760 ayrı kestirim kalıyor. Yeniden kullanılan kestirimleri bağımsız yeni kanıt diye saymadım.
Çalıştırma yol boyunca kesildi ve yeniden başlatıldı. Kaydedilen son dilim, kontrol noktalarından devam ettirilen 2.162 kestirim ile yeni tamamlanan 2.598 kestirim bildiriyor; toplam yine 4.760. Bu dilimin yaklaşık 12.042 saniyelik süresi yalnızca devam ettirilen o dilime ait, çalışmanın baştan sona süresi değil.
Uzun bir çalıştırmayı yeniden başlatılabilir kılmak
CPU üzerinde binlerce 2.000 epokluk kestirim saatler sürer ve bu çalışma kesintiye uğradı. Her şeyi baştan başlatmak bitmiş hesaplamayı çöpe atmak demekti. Bu yüzden çalıştırma dondurulmuş bir manifestten devam ediyor: istek anlık görüntüsü, örnekleme tarifi, ayrıca hem kestirici kaynak dosyalarının hem de gizli girdi anlık görüntülerinin hash'leri. Tamamlanan her kestirim kendi kontrol noktasını yazıyor: sürümler ve köken bilgisi içeren küçük bir JSON özeti, artı madde katsayılarını ve gizli yetenek dizilerini tutan bir NumPy arşivi. Ayrı bir ilerleme kaydı başarı, başarısızlık ve bekleme sayılarını açıkça tutuyor; zamanlayıcı da henüz kontrol noktası olmayan kestirim anahtarlarını alıyor.
Kontrol noktaları atomik yazılıyor: önce geçici bir dosya yazılır, sonra hedefin üzerine yeniden adlandırılır. Windows'ta bu yeniden adlandırma, kestirimin kendisi başarılı olsa bile dosya kısa süreliğine kilitli olduğu için PermissionError ile başarısız olabiliyordu. Bu yüzden bitmiş bir kestirimi atmak yerine yeniden adlandırma tekrar deneniyor. Örnek bir sürüm:
import json, os, time
from pathlib import Path

def save_checkpoint(path: Path, summary: dict, attempts: int = 10) -> None:
    tmp = path.with_name(path.name + ".tmp")
    tmp.write_text(json.dumps(summary), encoding="utf-8")
    for attempt in range(attempts):
        try:
            os.replace(tmp, path)          # atomic on the same volume
            return
        except PermissionError:            # file briefly locked; the fit is fine
            time.sleep(0.2 * (attempt + 1))
    raise RuntimeError(f"could not publish checkpoint {path.name}")
Ortam ayrıntıları da en az bu kadar önemliydi. Konsol kodlaması Farsça metni temsil edemeyen gizli worker süreçlerinde bu metin loglamayı bozdu ve hazırlık, aslında yalnızca bir loglama sorunu yüzünden durabiliyordu. Python'u UTF-8 modunda (-X utf8) çalıştırmak ve her dosyayı UTF-8 ile yazmak sorunu çözdü.
Çalıştırmada her biri tek bir hesaplama iş parçacığı kullanan dört worker süreci vardı. Araştırma sarmalayıcısı iş parçacığı sayısını açıkça ayarladı, çünkü eğiticiye bir cores argümanı vermek bu kontrolün yerini tutmaz. Genel, örnek bir sürüm:
import os
for var in ("OMP_NUM_THREADS", "MKL_NUM_THREADS", "OPENBLAS_NUM_THREADS"):
    os.environ[var] = "1"                  # before importing numpy or torch

import torch
torch.set_num_threads(1)
Devam ettirilen kestirimlerin öncekilerle karşılaştırılabilir olması gerekiyordu. Bu yüzden çalıştırma, sonuçları karıştırmadan önce kestirici kaynaklarının SHA-256 hash'lerini ve kütüphane sürümlerini doğruladı. Saklanan ortam Python 3.13, PyTorch 2.7.1 (CPU derlemesi), NumPy 2.2.6, pandas 2.3.1, Pyro 1.9.1 ve SciPy 1.16.1'di. Aynı girdileri aynı seed'le kestiren bir pilot çalıştırma, en büyük parametre farkını sıfır buldu. Bu yalnızca bu araştırma ortamı için geçerli; canlıdaki servisin seed davranışının aynı olduğu hiçbir zaman gösterilmedi.
Hazırlık doğrulamaları birkaç erken denemeyi durdurdu. Takılan her kontrolü girdilerde yapılması gereken bir düzeltme saydım; böylece kısmi bir veri kümesi bitmiş bir çalışma gibi geçemezdi. Birebir yeniden çalıştırmalar dondurulmuş yerel girdilere bağlı, çünkü istekler, yanıtlar ve uygunluk meta verileri değiştikçe yeni bir canlı veri çekimi farklı çıkabilir. Gizli anlık görüntüler ve kontrol noktaları, takma adlandırılmış olsalar da olmasalar da yayımlanmıyor.
Tek CSV, birkaç tür satır
Ana çıktı tek bir CSV ve içindeki RecordType sütunu farklı istatistiksel birimleri birbirinden ayırıyor:
- Sample, Full ve OptimizerControl: çalıştırma başına bir satır;
- SizeSummary: bir büyüklük ve dersin tekrarlanan çalıştırmaları üzerinden istatistikler;
- ItemStability: tek bir içerik maddesinin örneklemler arasındaki değişkenliği;
- SizeComparison: bir hedef N ile temel N arasındaki eşleştirilmiş değişimler;
- OptimizerSummary: sabit bir alt kümede eğitim seed'leri arasındaki değişimler;
- CrossExamComparison: eşleşen bir ders ve N için betimsel karşılaştırmalar;
- Skipped, başarısızlık ve bekleme durumlarının açık işlenmesiyle birlikte; bunlara istek anlık görüntüleri, yapılandırma, köken bilgisi ve çalıştırma muhasebesi ekleniyor.
Her kestirim satırı a, b, θ ve sabit Lambda'nın ortalamasını, medyanını, en küçük ve en büyük değerini ve standart sapmasını özetliyor. Yanında havuz büyüklüğü, gerçekleşen ve istenen N, yanıt sayıları, doğru ve görülüp boş bırakılan oranları, örneklemin ham puan özetleri, seed'ler ve geçen süre gibi bağlam bilgileri duruyor.
En çok dikkat isteyen sütun standart sapma, çünkü anlamı kayıt türüne göre değişiyor. Tekrarlar arası istatistik olarak standart sapmanın seçildiği bir SizeSummary satırında, ayırt edicilik ortalaması sütunundaki değer 20 ders düzeyi ortalamanın standart sapmasıdır. Ders içindeki madde a değerlerinin yayılımı değildir.
İstatistikler
Her ders ve daha büyük, mümkün her N için karşılaştırma, her temel/hedef çiftinde bulunan maddelerin kesişimini kullandı. Bu yapılmasa, kestirilen madde kümesinin değişmesi katsayılarda bir değişim gibi görünebilirdi. Her parametre ve r tekrarı için:
delta_r = mean coefficient at target N on the common questions
        - mean coefficient at base N on those same questions
Yirmi fark bir eşleştirilmiş t testinden ve çift yönlü bir Wilcoxon işaretli sıralar kontrolünden (zero_method='pratt' ile) geçti. Farklar önce 12 ondalık basamağa yuvarlandı ki kayan nokta gürültüsü tam bir eşitliği çok küçük, sıfırdan farklı bir farka çeviremesin. Tamamı sıfır olan farklar ile sıfırdan farklı sabit farklar ayrıca ele alındı ve her karşılaştırma, eşleştirilmiş ortalama fark için %95'lik bir aralık kaydetti. Tek bir karşılaştırmanın örnek taslağı:
from scipy import stats
import numpy as np

d = np.round(target_means - base_means, 12)      # 20 paired differences
if np.all(d == 0) or np.ptp(d) == 0:
    record_degenerate(d)                         # all-zero or nonzero-constant
else:
    t = stats.ttest_rel(target_means, base_means)
    ci = t.confidence_interval(0.95)             # not multiplicity-adjusted
    w = stats.wilcoxon(d, zero_method="pratt")   # two-sided

# later, per test family, across within-exam size contrasts for a and b:
q_t = stats.false_discovery_control(t_pvalues, method="bh")
q_w = stats.false_discovery_control(w_pvalues, method="bh")
Yanlış keşif oranı için Benjamini-Hochberg düzeltmesi t testi p değerlerine ve Wilcoxon p değerlerine ayrı ayrı uygulandı; aile, hem a hem b için sınav içi büyüklük karşıtlıklarından oluşuyordu ve eşik q < 0,05 idi. İki ailenin ayrıştığı yerler işaretlendi. Tek tek fark aralıkları çoklu karşılaştırma için düzeltilmedi.
20 örneklem üzerindeki 2,5. ve 97,5. yüzdelikler örneklem değişkenlik aralıkları diye raporlanıyor: bir dersin sonucunun, dondurulmuş tek bir havuzdan yapılan tekrarlı seçimler boyunca ne kadar oynadığı. Bunlara gerçek madde katsayıları için %95 güven aralığı demedim; zaten yalnızca 20 tekrarla uç yüzdelikler kaba özetlerden öteye geçmez.
Çalışmanın bulguları
Rahatça aktarabileceğim sonuçlar şunlar; hepsi bu havuzlarda yerel, dar önselli kestiriciden geliyor:
- Mümkün olan 500 kişilik gruplarda, 20 ders ortalaması ayırt edicilik değerinin aralığının medyanı yaklaşık 0,0345'ti.
- Gösterilen en geniş 500 kişilik aralık 1404'teki Beşerî Bilimler ekonomi dersindeydi; ortalama a burada yaklaşık 0,4861 ile 0,6327 arasında değişti.
- 1403'te Matematik alanının matematik dersinde ortalama a, N = 434'te 0,5882'den N = 4.000'de 1,0881'e çıktı; kestirim başına en yüksek a'nın ortalaması da 0,8795'ten 1,4862'ye yükseldi. Aynı değişim boyunca örneklemlerin ortalama ham puanı yaklaşık 15,7832'ye karşı 15,7701'de, ham puan standart sapması da yaklaşık 15,4174'e karşı 15,5043'te kaldı.
- Ayırt edicilik için 175 büyüklük karşıtlığı vardı. 175'inin hepsinde ortalama değişim pozitifti ve düzeltilmiş iki test ailesi de hepsini işaretledi.
- Güçlük için 175 karşıtlık vardı: 172 pozitif ve üç negatif değişim. t testi ailesi 173'ünü, Wilcoxon ailesi 175'ini işaretledi; yani iki karar ayrıştı.
- 52 optimize edici kontrolünde, beş seed boyunca ders ortalaması ayırt ediciliğin standart sapmasının medyanı yaklaşık 0,00340, seed'ler arası aralığın medyanı da yaklaşık 0,00855'ti.
Dönüp dönüp baktığım satır 1403 matematik satırı. Büyük örneklemlerdeki öğrenciler ortalamada aynı puanı aynı yayılımla almıştı, ama kestirilen ortalama ayırt edicilik neredeyse iki katına çıktı. Bu, 3. bölümdeki sabit soru sonucunun örüntüsünü başka bir derste tekrarlıyor; bu kez büyüklük başına tek bir alt küme yerine yirmi iç içe tekrarla.
Testlerin söylemedikleri
Testler, uygulanan kestirici altında dondurulmuş tek bir yanıt havuzundan yapılan tekrarlı seçimlerle ilgili. Gerçek madde parametrelerini ortaya koymazlar, gelecekteki bir öğrenci alım politikasının etkisini öngörmezler, farklı yılların soru kalitesini de sıralamazlar. Veri paylaşılırken ve karşıtlık sayısı bu kadar çokken analiz keşif amaçlı bir teşhistir ve buna özel bir psikometrik geçerleme tasarımının yerini tutmaz. Daha büyük bir a, istatistiksel olarak saptanabilir olsa bile, değişmemiş bir sorunun eğitim açısından daha iyi hâle geldiği anlamına gelmez.
Örnekleme oranları da önemli. 521 kişilik bir havuzdan 500 kişi çekmek neredeyse aynı örneklemler üretir; birkaç binlik bir havuzdan 500 kişi çekmek öyle değildir. Tam sayıma yakın tekrarlar doğal olarak az seçim değişkenliği gösterir ve tam havuz büyüklüğünde sıfır değişkenlik, katsayıların yansız olduğunun ya da bu havuzun dışında geçerli olduğunun kanıtı değildir.
Sabit bir eğitim seed'i belirli bir girdiyi tekrarlanabilir kılar, ama farklı girdi büyüklüklerinde aynı stokastik gidişatı vermez. Beş seed'lik kontrol ders başına sabit tek bir alt kümede (500 kişilik örneklemlerde değil, ilk temel alt kümede) çalıştı ve her örneklemle çaprazlanmadı. Görünüşte bu yayılım yukarıdaki büyüklük değişimlerinin yanında küçük. Yine de varyansını örnekleme varyansından çıkarıp kesin bir ayrıştırma iddia etmek, ölçtüğü şeyi abartmak olur.
Kabul kontrolleri eşlemeleri, tekil öğrenci/içerik çiftlerini, müfredat üyeliğini, yerine koymadan alınmış tam örneklem büyüklüklerini, iç içe yapıyı, seed'leri, sonlu parametreleri, değişmemiş hash'leri, uyumlu sürümleri ve tamamlanan, kısmi, atlanan, başarısız ve bekleyen sayıların açık kaydını kapsadı. Bunlardan geçmek, çalışmayı dondurulmuş girdileri ve kayıtlı sürümleriyle tekrarlanabilir kılar. Tek boyutluluğu, yerel bağımsızlığı, değişmezliği ya da esasa ilişkin geçerliliği göstermez.
6. bölüm sıradaki karşılaştırmaya geçiyor: yerine konan güncel yıl formlarıyla, eşit örneklem büyüklüğünde yıllar arası ders karşılaştırması, bu formlardaki bir veri kapsama hatası, sonuçları grafiğe dökmenin üç yolu ve bunların hiçbirinin neden eşitleme sayılmadığı.
Bu not İngilizce ve Farsça olarak da yayımlandı: İngilizce · Farsça.