همهٔ آزمایشها تا اینجا برای هر حجم نمونه یک زیرمجموعه، یا چند تا، داشتند. اینها نشان دادند ضرایب برآوردگر محلی روی سؤالهای ثابت با N جابهجا میشوند. اما نمیتوانستند بگویند چه مقدار از این جابهجایی به این برمیگردد که تصادفاً کدام دانشآموزان انتخاب شدهاند، یا این الگو در رشتهها و سالهای دیگر هم برقرار است یا نه. برای این کار یک مطالعهٔ نمونهگیری تکراری لازم بود، و بیشتر زحمت صرف کارهای زیرساختیاش شد: نمونهگیری قطعی، برازشهایی که بشود شناسایی و دوباره استفادهشان کرد، چکپوینتهایی که بعد از قطع شدن اجرا سالم بمانند، و فایل خروجیای که واحدهای آماری مختلف را از هم جدا نگه دارد.
درخواست اول از دوازده آزمون حرف میزد. دامنهای که تأیید و پیاده شد نُه آزمون بود: سه رشته (ریاضی، علوم تجربی و علوم انسانی) در ۱۴۰۳، ۱۴۰۴ و فرمهای اصلی ۱۴۰۵ از قسمت ۱.
طراحی
واحد نمونهگیری دانشآموز بود و نمونهگیری برای هر درس مشمول جداگانه انجام شد. استخر هر درس همهٔ کسانی بودند که برای آن درس نمرهٔ معتبر و دستکم یک پاسخ قابل استفاده داشتند، با همان قواعد واجد شرایط بودن و کدگذاری پاسخ که در قسمت ۲ آمد. از هر استخر:
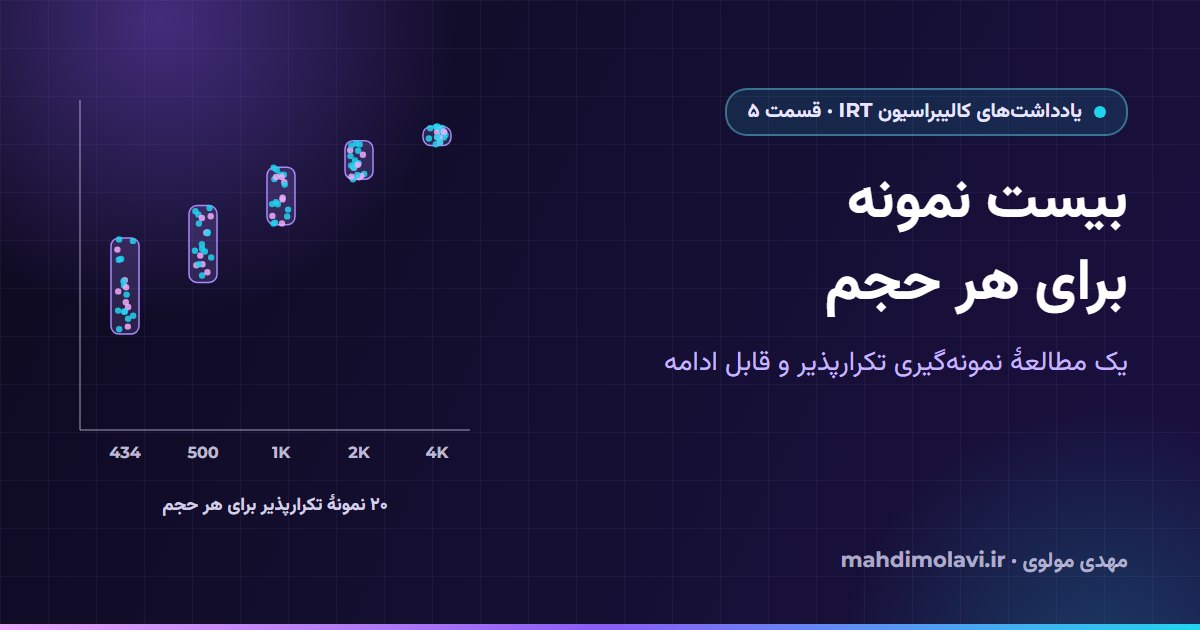
- حجمهای هدف ۴۳۴، ۵۰۰، ۱٬۰۰۰، ۲٬۰۰۰، ۴٬۰۰۰ و ۸٬۰۰۰ بودند و حجمهای تکراری حذف شدند؛
- هر ترکیب شدنیِ حجم و درس ۲۰ تکرار گرفت که هر کدام یک انتخاب بدون جایگذاری بود؛
- درون یک تکرار، هر نمونهٔ بزرگتر پیشوندی از یک جایگشت تصادفی است، پس نمونهٔ ۵۰۰ نفری نمونهٔ ۴۳۴ نفری را در خود دارد و همینطور تا بالا؛
- حجمی که از استخر بزرگتر بود اجرا نشد و بهعنوان حجم ردشده ثبت شد، و هیچوقت با تکرار افراد پر نشد؛
- هر درس یک برازش هم روی کل استخرش داشت که بهعنوان نقطهٔ مرجع به کار رفت؛
- همهٔ برازشهای اصلی با seed آموزشی ۴۲ اجرا شدند، و یک کنترل جداگانه اولین زیرمجموعهٔ پایه را با همان افراد و با seedهای ۴۲ تا ۴۶ دوباره برازش داد.
تودرتو بودن نمونهها مقایسههای حجم را زوجی میکند: تکرار r در N برابر ۴٬۰۰۰ با تکرار r در N برابر ۴۳۴ فقط در افراد اضافهشده فرق دارد. یک دانشآموز میتواند در چند تکرار بیاید، چون هر تکرار جایگشت خودش را میکشد، اما هرگز دو بار در یک نمونه نمیآید.
برازش روی کل استخر یک مرجع است و هیچوقت مقدار واقعی پارامتر به حساب نمیآید. با پیشین باریک قسمت ۳، این برازش فقط برآورد در بزرگترین N موجود است.
برنامهٔ درسی جداگانهٔ درون علوم انسانی جمعیت کوچکی داشت، برای همین دو درسش حجم پایهٔ مشترک خودشان را گرفتند: ۲۲۶ برای عربی و ۲۲۱ برای تاریخ و جغرافیا. شناسهٔ درس عربی آن بین سالها عوض شده بود، پس با یک نگاشت درسهای قابل مقایسه، مقایسه بین سالها ممکن شد و شناسههای اصلی هم دستنخورده ماندند. این برنامهٔ درسی در تمام مدت از علوم انسانیِ استاندارد جدا ماند. روی هم ۵۲ گروه وجود داشت که هر کدام یک درس در یک سال بود: ۴۸ گروه از رشتههای استاندارد و چهار گروه مشمول از برنامهٔ درسی جداگانه. یک ردیف درسی کهنه که هیچ آمار درسی فعالی نداشت، درس اضافه حساب نشد.
دستور نمونهگیری قطعی
نمونهٔ هر آزمون، درس و تکرار باید در هر اجرا یکسان میبود، به هر ترتیبی که کارها اجرا شوند. SeedSequence در NumPy این کار را از یک فهرست ثابت از اعداد صحیح انجام میدهد. یک طرح نمایشی به شکل عمومی (مادهٔ اولیهٔ seed همان مطالعه است؛ انتخاب مولد، تابع هش و dtype از من است):
import hashlib
import numpy as np

def replicate_permutation(pool, exam_id, lesson_key, replicate):
    # pool: anonymized student indices in a fixed, canonical order
    ss = np.random.SeedSequence([STUDY_CONSTANT, exam_id, lesson_key, replicate])
    return np.random.default_rng(ss).permutation(pool)

def nested_samples(permutation, sizes):
    for n in sorted(set(sizes)):
        if n > len(permutation):
            yield n, None                 # recorded as Skipped, never padded
        else:
            yield n, permutation[:n]      # prefix: smaller samples nest in larger ones

def fit_key(lesson, n, selected, training_seed):
    ids = np.unique(selected)             # sorted and unique
    fingerprint = hashlib.sha256(ids.astype("<i8").tobytes()).hexdigest()
    return (lesson, n, fingerprint, training_seed)
ثابت مطالعه شبیه یک تاریخ است، اما فقط یک عدد ثابت است که بین اجراها هیچوقت عوض نمیشود. چون شمارهٔ تکرار بخشی از مادهٔ seed است، تکرار ۷ به این بستگی ندارد که تکرارهای ۱ تا ۶ قبل از آن اجرا شده باشند یا نه. هر دستوری از این دست به این هم نیاز دارد که استخر پیش از جایگشت ترتیب پایداری داشته باشد، وگرنه همان seed افراد دیگری را انتخاب میکند.
نیمهٔ دوم دستور هویت است. بعد از انتخاب، آرایهٔ مرتب و یکتای اندیسهای دانشآموزان انتخابشده (همان اندیسهای ناشناس هر درس از قسمت ۲) به یک اثر انگشت جمعیت هش میشود، و کلید برازش از ترکیب درس، N، این اثر انگشت و seed آموزشی ساخته میشود. دو درخواست با کلید یکسان همان افراد را با همان seed برازش میدهند، پس دومی میتواند نتیجهٔ برازش اولی را دوباره استفاده کند. این استفادهٔ دوباره در محاسبه صرفهجویی میکند. شاهد تازهای اضافه نمیکند، و حسابوکتاب اجراها باید این را نشان دهد.
شمردن صادقانهٔ اجراها
| دستهٔ حسابوکتاب | تعداد |
|---|---|
| اجراهای درخواستیِ طراحیشده، شامل حجمهای پشتیبانینشده | 6,632 |
| درخواستهای اجراپذیرِ موفق | 4,852 |
| برازشهای متمایز ورودی/seed | 4,760 |
| درخواستهایی که برازش یکسانی از ورودی/seed را دوباره استفاده کردند | 92 |
| ترکیبهای پشتیبانینشدهٔ حجم/درس | 89 |
| تکرارهای درخواستی در آن ترکیبهای پشتیبانینشده | 1,780 |
| گروههای نمونهٔ کامل با ۲۰ تکرار | 227 |
| اجراهای ناموفق / معلق نهایی | 0 / 0 |
۴٬۸۵۲ درخواست موفق از ۴٬۵۴۰ رکورد نمونه (۲۲۷ گروه کامل ۲۰ تایی)، ۵۲ رکورد کل استخر و ۲۶۰ رکورد کنترل بهینهساز (۵۲ درس در پنج seed) تشکیل شدهاند. ۸۹ ترکیب پشتیبانینشده ۱٬۷۸۰ تکرار درخواستی را میسازند، و ۴٬۸۵۲ بهعلاوهٔ ۱٬۷۸۰ همان ۶٬۶۳۲ اجرای طراحیشده میشود. از درخواستهای موفق، ۹۲ تا به ورودی و seedی رسیدند که قبلاً برازش شده بود، و این ۴٬۷۶۰ برازش متمایز باقی میگذارد. برازشهای دوبارهاستفادهشده را شاهد تازه و مستقل حساب نکردم.
اجرا در طول کار قطع شد و دوباره ادامه پیدا کرد. بخش نهایی ذخیرهشده ۲٬۱۶۲ برازش ازسرگرفته از چکپوینت و ۲٬۵۹۸ برازش تازه تمامشده گزارش میکند که جمعشان باز ۴٬۷۶۰ است. زمان سپریشدهٔ حدود ۱۲٬۰۴۲ ثانیه مال همین بخش ازسرگرفته است و مدت کل مطالعه از ابتدا تا انتها نیست.
قابل ازسرگیری کردن یک اجرای طولانی
هزاران برازش با ۲٬۰۰۰ epoch روی CPU ساعتها طول میکشد، و این کار وسط راه قطع شد. شروع دوباره از صفر محاسبات تمامشده را دور میریخت، پس اجرا از یک مانیفست منجمد ادامه پیدا میکند: اسنپشات درخواستها، دستور نمونهگیری، و هش فایلهای منبع برآوردگر و اسنپشاتهای خصوصیِ ورودی. هر برازش تمامشده چکپوینت خودش را مینویسد: یک خلاصهٔ کوچک JSON با نسخهها و منشأ داده، بهعلاوهٔ یک آرشیو NumPy که ضرایب سؤال و آرایههای خصوصی توانایی را نگه میدارد. یک رکورد پیشرفت جداگانه شمار صریح موفق، ناموفق و معلق را نگه میدارد، و زمانبند سراغ هر کلید برازشی میرود که هنوز چکپوینت ندارد.
چکپوینتها بهصورت اتمیک نوشته میشوند: اول یک فایل موقت نوشته میشود و بعد با تغییر نام جای فایل هدف را میگیرد. روی ویندوز این تغییر نام ممکن بود با PermissionError شکست بخورد، چون فایل لحظهای قفل بود، با اینکه خود برازش موفق بوده. برای همین تغییر نام دوباره امتحان میشود و برازش تمامشده دور ریخته نمیشود. یک نسخهٔ نمایشی:
import json, os, time
from pathlib import Path

def save_checkpoint(path: Path, summary: dict, attempts: int = 10) -> None:
    tmp = path.with_name(path.name + ".tmp")
    tmp.write_text(json.dumps(summary), encoding="utf-8")
    for attempt in range(attempts):
        try:
            os.replace(tmp, path)          # atomic on the same volume
            return
        except PermissionError:            # file briefly locked; the fit is fine
            time.sleep(0.2 * (attempt + 1))
    raise RuntimeError(f"could not publish checkpoint {path.name}")
جزئیات محیط اجرا هم به همان اندازه مهم بود. متن فارسی، لاگگیری را در پروسههای worker پنهانی که encoding کنسولشان نمیتوانست آن را نمایش دهد خراب میکرد، و آمادهسازی ممکن بود به خاطر چیزی متوقف شود که فقط یک مشکل لاگ بود. اجرای پایتون در حالت UTF-8 (-X utf8) و نوشتن همهٔ فایلها با UTF-8 مشکل را حل کرد.
اجرا با چهار پروسهٔ worker انجام شد که هر کدام یک ترد محاسباتی داشت. wrapper پژوهشی تعداد تردها را صریحاً تنظیم کرد، چون دادن آرگومان cores به تابع آموزش جای این کنترل را نمیگیرد. یک نسخهٔ نمایشی عمومی:
import os
for var in ("OMP_NUM_THREADS", "MKL_NUM_THREADS", "OPENBLAS_NUM_THREADS"):
    os.environ[var] = "1"                  # before importing numpy or torch

import torch
torch.set_num_threads(1)
برازشهای ازسرگرفته باید با برازشهای قبلی قابل مقایسه میبودند، پس اجرا پیش از کنار هم گذاشتن نتیجهها هشهای SHA-256 منابع برآوردگر و نسخههای کتابخانهها را بررسی کرد. محیطی که نگه داشتم Python 3.13، PyTorch 2.7.1 (نسخهٔ CPU)، NumPy 2.2.6، pandas 2.3.1، Pyro 1.9.1 و SciPy 1.16.1 بود. یک اجرای آزمایشی که ورودیهای یکسان را با seed یکسان برازش داد، بیشینهٔ اختلاف پارامترها را صفر یافت. این فقط دربارهٔ همین محیط اجرای پژوهشی صدق میکند؛ هیچوقت ثابت نشد که رفتار seed در سرویس مستقر هم یکسان است.
بررسیهای assert در مرحلهٔ آمادهسازی چند تلاش اول را متوقف کردند، و هر بررسی ردشده را اصلاحی در ورودیها حساب کردم تا یک دیتاست ناقص نتواند خودش را مطالعهٔ تمامشده جا بزند. اجرای دقیقاً تکراری به ورودیهای محلیِ منجمد وابسته است، چون یک استخراج زندهٔ تازه ممکن است با تغییر درخواستها، پاسخها و فرادادهٔ شمول درس فرق کند. اسنپشاتهای خصوصی و چکپوینتها منتشر نمیشوند، چه با نام مستعار باشند چه نه.
یک CSV، چند نوع ردیف
خروجی اصلی یک CSV است با ستون RecordType که واحدهای آماری مختلف را از هم جدا نگه میدارد:
- Sample، Full و OptimizerControl: یک ردیف برای هر اجرا؛
- SizeSummary: آمارهها روی اجراهای تکراریِ یک حجم و یک درس؛
- ItemStability: تغییرپذیری یک سؤال محتوایی در نمونههای مختلف؛
- SizeComparison: تغییرات زوجی بین یک N هدف و N پایه؛
- OptimizerSummary: تغییرات بین seedهای آموزشی روی یک زیرمجموعهٔ ثابت؛
- CrossExamComparison: مقایسههای توصیفی برای یک درس متناظر و یک N؛
- Skipped، با مدیریت صریح موارد ناموفق و معلق، بهعلاوهٔ اسنپشاتهای درخواستها، پیکربندی، منشأ و حسابوکتاب اجرا.
هر ردیف برازش میانگین، میانه، کمینه، بیشینه و انحراف معیار a، b، θ و Lambdaی ثابت را خلاصه میکند، همراه با اطلاعات زمینهای مثل اندازهٔ استخر، N واقعی و درخواستی، تعداد پاسخها، نرخ پاسخ درست و نرخ دیدهشده ولی بیپاسخ، خلاصهٔ نمرهٔ خام نمونه، seedها و زمان سپریشده.
ستونی که بیشترین دقت را لازم دارد انحراف معیار (SD) است، چون معنایش به نوع رکورد بستگی دارد. در یک ردیف SizeSummary که آمارهٔ بینتکراریاش انحراف معیار است، مقدارِ ستون میانگین قدرت تمیز، انحراف معیار ۲۰ میانگین در سطح درس است. پراکندگی مقدارهای a سؤالها درون یک درس نیست.
آمار
برای هر درس و هر N بزرگترِ شدنی، مقایسه روی اشتراک سؤالهایی انجام شد که در همهٔ جفتهای پایه/هدف حضور داشتند. بدون این کار، عوض شدن مجموعهٔ سؤالهای برازششده میتوانست شبیه تغییر ضرایب به نظر برسد. برای هر پارامتر و تکرار r:
delta_r = mean coefficient at target N on the common questions
        - mean coefficient at base N on those same questions
بیست تفاضل از یک آزمون t زوجی و یک آزمون رتبهعلامتدار ویلکاکسون دوطرفه (با zero_method='pratt') گذشتند، بعد از اینکه تفاضلها تا ۱۲ رقم اعشار گرد شدند تا نویز ممیز شناور نتواند یک تساوی دقیق را به اختلافی ریز و غیرصفر تبدیل کند. تفاضلهای تماماً صفر و تفاضلهای ثابتِ غیرصفر جداگانه و صریح مدیریت شدند، و برای هر مقایسه یک بازهٔ ۹۵ درصدی برای میانگین تفاضل زوجی ثبت شد. یک طرح نمایشی از یک مقایسه:
from scipy import stats
import numpy as np

d = np.round(target_means - base_means, 12)      # 20 paired differences
if np.all(d == 0) or np.ptp(d) == 0:
    record_degenerate(d)                         # all-zero or nonzero-constant
else:
    t = stats.ttest_rel(target_means, base_means)
    ci = t.confidence_interval(0.95)             # not multiplicity-adjusted
    w = stats.wilcoxon(d, zero_method="pratt")   # two-sided

# later, per test family, across within-exam size contrasts for a and b:
q_t = stats.false_discovery_control(t_pvalues, method="bh")
q_w = stats.false_discovery_control(w_pvalues, method="bh")
تعدیل بنیامینی–هاکبرگ برای نرخ کشف کاذب جداگانه روی مقدارهای p آزمون t و مقدارهای p ویلکاکسون اعمال شد، روی مقایسههای حجم درون هر آزمون برای a و b، با آستانهٔ q کمتر از ۰٫۰۵. هر جا دو خانواده با هم اختلاف داشتند، آن اختلاف علامت خورد. بازههای تفاضلِ تکتک مقایسهها برای مقایسههای چندگانه تعدیل نشدند.
صدکهای ۲٫۵ و ۹۷٫۵ در ۲۰ نمونه بهعنوان دامنهٔ تغییرپذیری نمونه گزارش شدهاند: اینکه نتیجهٔ یک درس در انتخابهای تکراری از یک استخر منجمد چقدر جابهجا شد. اسم آنها را بازهٔ اطمینان ۹۵ درصدی برای ضرایب واقعی سؤالها نگذاشتم، و با فقط ۲۰ تکرار، صدکهای دنباله در هر حال خلاصههای زمختی هستند.
یافتههای مطالعه
نتیجههایی که با خیال راحت نقلشان میکنم، همه از برآوردگر محلی با پیشین باریک و روی همین استخرها:
- در گروههای ۵۰۰ نفریِ شدنی، میانهٔ دامنهٔ ۲۰ مقدار میانگین قدرت تمیز درس حدود ۰٫۰۳۴۵ بود.
- بزرگترین دامنهٔ گزارششده برای نمونهٔ ۵۰۰ نفری مال درس اقتصادِ علوم انسانی در ۱۴۰۴ بود که میانگین a در آن از حدود ۰٫۴۸۶۱ تا ۰٫۶۳۲۷ تغییر کرد.
- برای درس ریاضیِ رشتهٔ ریاضی در ۱۴۰۳، میانگین a از ۰٫۵۸۸۲ در N برابر ۴۳۴ به ۱٫۰۸۸۱ در N برابر ۴٬۰۰۰ رسید، و میانگین بیشینهٔ a در هر برازش از ۰٫۸۷۹۵ به ۱٫۴۸۶۲. در همین تغییر، میانگین نمرهٔ خام نمونهها حدود ۱۵٫۷۸۳۲ در برابر ۱۵٫۷۷۰۱ ماند، و انحراف معیار نمرهٔ خام حدود ۱۵٫۴۱۷۴ در برابر ۱۵٫۵۰۴۳.
- برای قدرت تمیز ۱۷۵ مقایسهٔ حجم وجود داشت. هر ۱۷۵ مورد تغییر میانگین مثبت داشتند و هر دو خانوادهٔ آزمونِ تعدیلشده همه را علامت زدند.
- برای دشواری هم ۱۷۵ مقایسه وجود داشت: ۱۷۲ تغییر مثبت و سه تغییر منفی. خانوادهٔ آزمون t ۱۷۳ مورد و خانوادهٔ ویلکاکسون ۱۷۵ مورد را علامت زدند، پس دو تصمیم با هم نخواندند.
- در ۵۲ کنترل بهینهساز، میانهٔ انحراف معیار میانگین قدرت تمیز درس در پنج seed حدود ۰٫۰۰۳۴۰ بود، و میانهٔ دامنه بین seedها حدود ۰٫۰۰۸۵۵.
ردیف ریاضی ۱۴۰۳ همانی است که مدام به آن برمیگردم. دانشآموزان نمونههای بزرگتر بهطور میانگین همان نمره را با همان پراکندگی گرفتند، و میانگین برآوردشدهٔ قدرت تمیز تقریباً دو برابر شد. این همان الگوی نتیجهٔ سؤالهای ثابت در قسمت ۳ است، روی درسی دیگر و این بار با بیست تکرار تودرتو بهجای یک زیرمجموعه برای هر حجم.
آنچه آزمونها نمیگویند
این آزمونها دربارهٔ انتخابهای تکراری از یک استخر پاسخ منجمد با برآوردگرِ پیادهشدهاند. پارامترهای واقعی سؤال را ثابت نمیکنند، اثر یک سیاست آیندهٔ جذب شرکتکننده را پیشبینی نمیکنند، و کیفیت سؤالهای سالهای مختلف را رتبهبندی نمیکنند. با دادهٔ مشترک و مقایسههای زیاد، این تحلیل یک بررسی تشخیصی اکتشافی است و جای یک طرح اختصاصی اعتبارسنجی روانسنجی را نمیگیرد. a بزرگتر، حتی اگر از نظر آماری قابل تشخیص باشد، به این معنا نیست که سؤالی که تغییر نکرده از نظر آموزشی بهتر شده است.
کسر نمونهگیری هم مهم است. کشیدن ۵۰۰ نفر از استخری ۵۲۱ نفری نمونههای تقریباً یکسانی میدهد، که با کشیدن ۵۰۰ نفر از چند هزار نفر خیلی فرق دارد. تکرار نمونهگیری وقتی به سرشماری نزدیک است طبیعتاً تغییر کمی در انتخاب نشان میدهد، و صفر بودن تغییر در حجم کل استخر شاهدی بر نااریب بودن ضرایب یا اعتبارشان بیرون از این استخر نیست.
seed آموزشی ثابت یک ورودی مشخص را تکرارپذیر میکند، اما در حجمهای مختلف ورودی مسیرهای تصادفی یکسانی به دست نمیدهد. کنترل پنجseedی روی یک زیرمجموعهٔ ثابت در هر درس اجرا شد (اولین زیرمجموعهٔ پایه، نه نمونههای ۵۰۰ نفری) و با همهٔ نمونهها بهصورت متقاطع اجرا نشد. در نگاه اول، این پراکندگی در کنار تغییرات حجم که بالاتر آمد کوچک است، اما اگر واریانس آن را از واریانس نمونهگیری کم کنیم و ادعای یک تجزیهٔ دقیق بکنیم، بیش از آنچه این کنترل اندازه گرفت ادعا کردهایم.
بررسیهای پذیرش این موارد را پوشش میدادند: نگاشتها، یکتایی جفتهای دانشآموز/محتوا، عضویت در برنامهٔ درسی، حجم دقیق نمونهها بدون جایگذاری، تودرتو بودن، seedها، متناهی بودن پارامترها، تغییر نکردن هشها، سازگاری نسخهها، و شمار صریح موارد کامل، ناقص، ردشده، ناموفق و معلق. گذشتن از این بررسیها مطالعه را با ورودیهای منجمد و نسخههای ثبتشدهاش تکرارپذیر میکند. تکبعدی بودن، استقلال موضعی، ناوردایی یا روایی ماهوی را ثابت نمیکند.
قسمت ۶ سراغ مقایسهای میرود که بعد از این آمد: درسها در سالهای مختلف با حجم نمونهٔ برابر روی فرمهای جایگزین سال جاری، یک باگ پوشش داده در آن فرمها، سه روش برای نمودار کشیدن نتیجهها، و اینکه چرا هیچکدام از اینها همترازسازی به حساب نمیآید.
این یادداشت به انگلیسی هم منتشر شده است: نسخهٔ انگلیسی.