3. bölüm somut bir teşhisle bitmişti. Yerel kestirici hem ayırt ediciliğe hem güçlüğe standart sapması 0,1 olan normal bir önsel koyuyor. Sabit 30 soruluk bir kümede kestirimleri, öğrenci eklendikçe düzenli olarak yükseldi. Yalnızca ayırt edicilik önselini genişletmek ise, 523 kişilik ve hiç değişmeyen tek bir yanıt kümesinde en yüksek a değerini yaklaşık 0,934'ten yaklaşık 2,637'ye taşıdı. Bunu gördükten sonra sıradaki adım belli: farklı bir kestirici denemek ve örneklem büyüklüğüne olan bağımlılığın kaybolup kaybolmadığına bakmak.
Elimin altında iki aday vardı. Yerel kütüphanede madde önsellerini veriden öğrenen hiyerarşik bir dal zaten bulunuyor. Bağımsız ve açık kaynaklı bir Python kütüphanesi olan GIRTH ise aynı 2PL tepki fonksiyonunu marjinal en çok olabilirlik (MML) ile kestiriyor. İkisini de denedim. Her biri sorunun bir kısmını yanıtladı ve yeni bir soru açtı. Şimdiye kadar toplanan kanıtlara bakınca ikisi de üretimdeki kestiricinin yerine olduğu gibi takılabilecek bir şey değil.
Hiyerarşik dal hem modeli hem guide'ı değiştiriyor
Pyro'da model, verinin nasıl üretildiğini anlatan hikâyedir (önseller artı olabilirlik). Guide (varyasyonel yaklaşım) ise stokastik varyasyonel çıkarım (SVI) sırasında sonsala yaklaşan varyasyonel ailedir. Pyro SVI öğreticisi bu ayrımı iyi anlatıyor. Yerel 2PL sınıfında bir model_hierarchical ve ona eşlik eden bir guide_hierarchical var; hiyerarşik seçeneği açınca ikisi birden değişiyor. Bunun üzerinde duruyorum, çünkü deneyi yalnızca guide değişikliği diye anlatmak kolay ve bu anlatım yanlış olur. Önsel de değişiyor, guide da ona uyacak şekilde değişiyor.
Sabit dal madde önsellerini N(0, 0.1) üzerinde tutarken hiyerarşik dal geniş konum ve ölçek hiperparametreleri öğreniyor. Bu, sıfıra doğru çekimi gevşetiyor ama gizil ölçeğin oynamasına da izin veriyor. 2PL modelinde olabilirlik yalnızca a(θ − b) çarpımını görür. θ, a ve b'nin işaretlerini birlikte çevirirseniz tahmin edilen olasılıkların hiçbiri değişmez. θ ile b'yi pozitif bir sabitle çarpıp a'yı aynı sabite bölerseniz gözlenebilir hiçbir şey yine değişmez. Kurulumdaki bir şeyin ölçeğin yönünü ve birimini sabitlemesi gerekir ve hiperparametreler öğrenildiğinde bu sabitleme zayıflar.
Küçük örneklemli bir hiyerarşik çalıştırmada yön ters çıktı. Kestirilen yetenekler öğrencilerin ampirik başarısının tersine gidiyordu ve ayırt edicilikler de onlarla birlikte ters döndü. Ham çıktıyı olduğu gibi okuyan biri, soruların birdenbire bozulduğu sonucuna varır. Oysa sorular hiç değişmemişti. Sorun kestirimdeki tanımlanabilirlik ve yön sorunuydu.
Bu yüzden herhangi bir hiyerarşik çalıştırmayı sabit önselli bir çalıştırmayla karşılaştırmadan önce yönü ampirik başarıyla tutarlı hâle getirdim, sonra katsayıları kestirilen yeteneğin bir standart sapması başına ifade ettim:
theta_standardized = (theta - mean(theta)) / SD(theta)
a_standardized     = a * SD(theta)
b_standardized     = (b - mean(theta)) / SD(theta)
Önce yön düzeltmesi, sonra yeniden ölçekleme yapılır. İkisi birlikte modellenen her yanıt olasılığını yerinde bırakır; tek bir kestirim içinde güvenle uygulanabilmelerinin nedeni de bu. Bir sınavın ölçeğini başka bir sınavın ölçeğine bağlamazlar. 6. bölüm bu farka geri dönüyor, çünkü yılları karşılaştırmanın asıl sorunu tam olarak bu.
Tek bir kontrollü karşılaştırma
Deney ortamı 3. bölümdeki kontrollü düzenekti: aynı 30 arşiv matematik sorusu, bir kez 434 kişilik bir alt kümede, bir kez de kullanılabilir yanıtı olan 9.099 öğrencinin tamamında kestirildi.
| Yöntem | Ortalama a, standartlaştırılmış birim, N = 434 | Ortalama a, standartlaştırılmış birim, N = 9.099 |
|---|---|---|
| Sabit, dar önselli dal | 0.5874 | 1.1375 |
| Hiyerarşik dal | 1.4894 | 1.2896 |
Bunlar standartlaştırılmış birimler, yani 3. bölümdeki tablonun ham ortalamalarıyla yan yana okunmamalı. Bu tablonun içinde sabit önselli ortalama küçük alt kümeden tam havuza yaklaşık %94 yükseldi, hiyerarşik ortalama ise yaklaşık %13 düştü. Bu teşhiste hiyerarşik daldaki büyüklük etkisi çok daha küçüktü.
Sonucun söylediği bu kadar. Daha küçük bir etki de bir etkidir, tek bir soru kümesinden ve tek bir alt kümeden geliyor ve tam veriyle yapılan hiyerarşik çalıştırmada yön düzeltmesinden sonra bile bir negatif ayırt edicilik kaldı. Daha önceki hiyerarşik denemelerde de negatif maddeler ve kendine özgü ölçek sorunları görülmüştü. Dalın etiketini keşif amaçlı diye bıraktım. Üretim adayı olabilmesi için açık tanımlanabilirlik kısıtları, pozitif ayırt ediciliği modellemenin uygun bir yolu, uyum kontrolleri, parametre geri kazanım deneyleri ve farklı seed'lerde kararlılık gerekirdi. Bunların hiçbiri bu çalışmanın parçası değildi.
GIRTH: aynı 2PL, bu kez marjinal en çok olabilirlikle
İkinci aday GIRTH 0.8.0 ve onun twopl_mml rutiniydi. Madde tepki fonksiyonu yine 2PL. Değişen şey kestirim yöntemi: yerel varyasyonel Bayesçi kestirimin yerine marjinal en çok olabilirlik, olabilirliği varsayılan bir yetenek dağılımı üzerinden integre eder ve madde parametrelerine göre maksimize eder. Yani bu karşılaştırma madde modelini koruyup kestiriciyi değiştiriyor. Bu, parametreleri yeniden adlandırmaktan ya da eski koddaki bir sabiti ayarlamaktan çok daha büyük bir değişiklik.
Yanıtları yeniden çektim ve kestirimi şu yapılandırmayla çalıştırdım:
- şekli yeniden kestirilmeyen, sabit bir referans yetenek dağılımı N(0, 1);
- [−6; 6] aralığında 61 kuadratür noktası;
- en fazla 200 iterasyon, arama tablosu (lookup table) yaklaşımı olmadan;
- bu kütüphane sürümünün madde sınırları: ayırt edicilik [0,2; 5], güçlük [−6; 6] aralığında;
- görülmeyen yanıtlar açıkça eksik veri diye verildi ve gözlenen yanlış cevaplardan ayrı tutuldu; bu, 2. bölümde anlatılan kodlamaya uyuyor;
- kullanılabilir yanıtı olmayan, ya da yanıtlarının tümü doğru veya tümü yanlış olan sorulara serbest bir kestirim verilmedi, bunlar kestirilemez diye işaretlendi.
Örnek biçimiyle çağrı kısa. Asıl iş matrisi hazırlamakta ve çıktıyı dikkatle okumakta.
from girth import twopl_mml

# Illustrative sketch; the exact option keys live in the pinned study scripts.
# responses: items x students, unseen responses tagged as missing (never as 0)
# study_options: fixed N(0, 1) ability distribution, 61 quadrature points
#   on [-6, 6], at most 200 iterations, no lookup-table approximation
estimates = twopl_mml(responses, options=study_options)
# read discrimination and difficulty from the result, then flag any value
# that sits on a bound and any nonestimable question
Bu altı sınavlık çalışmadaki uygun 34 ana ders grubunun hepsi GIRTH'in iç yakınsama koşuluna ulaştı. Bu gruplarda dersler ve sınavlar boyunca toplam 885 madde satırı vardı ve bunlar 825 ayrı içerik maddesini kapsıyordu. Hiçbir nihai kestirim ayırt ediciliğin üst sınırında durmuyordu. Biri a'nın alt sınırında, 18'i de bir güçlük sınırındaydı. Bunların her birini işaretledim, çünkü sınırdaki bir değer optimize edicinin bir limite takılıp durduğu yeri gösterir; kısıtsız bir kestirim değildir.
En yüksek değerler daha büyük
Aşağıda, 1. bölümdeki altı sınavın her birinin matematik dersi için yerel kodla yeniden yapılan kestirimin ve GIRTH'in en yüksek a değerleri var. İki sütun da bu çalışmanın veri çekimi üzerinde yeniden yapılmış kestirimler. Üretimde saklanan katsayıların kopyaları değiller, 3. bölümdeki tek alt kümelik kontrol de değiller.
| Sınav | Kullanılabilir matematik öğrencisi | Yerel kodla yeni en yüksek a | GIRTH en yüksek a |
|---|---|---|---|
| Matematik alanı, özgün 1405 formu | 443 | 0.87 | 1.70 |
| Deneysel Bilimler, özgün 1405 formu | 523 | 0.97 | 3.31 |
| Beşerî Bilimler, özgün 1405 formu | 1,169 | 1.27 | 2.18 |
| Matematik alanı, 1403 arşivi | 6,343 | 1.53 | 1.85 |
| Deneysel Bilimler, 1403 arşivi | 9,099 | 1.74 | 2.24 |
| Beşerî Bilimler, 1403 arşivi | 8,650 | 1.72 | 2.35 |
Kullanılabilir sayılar yine resmî katılımdan farklı (örneğin güncel Matematik alanı sınavında 434 katılımcıya karşılık 443 kullanılabilir matematik öğrencisi var); bunun nedenini 2. bölüm açıklamıştı. GIRTH'in en yüksek değeri her satırda daha büyük. Fark en çok küçük güncel sınavlarda açılıyor; bunların üçünden ikisinde yerel kodun en yüksek değeri 1'in altında kalıyor. En dar olduğu yer ise büyük arşiv sınavları.
En yüksek değerlerin büyük çıkması tek başına doğruluk hakkında hiçbir şey kanıtlamaz, çünkü eğimleri şişiren bir kestirici de aynı sonucu verirdi. Daha çok güvendiğim kontrol, kestirimin hiç görmediği yanıtları tahmin etmekti.
Ayrılmış öğrencilerde tahmin
Altı matematik dersinin her birinde kestirimden önce öğrencilerin %20'sini ayırdım. Ayrılmış bir öğrencinin bir maddeye verdiği yanıtı puanlarken o öğrencinin yeteneği hedef yanıt dışarıda bırakılarak çıkarıldı; böylece tahmin edilen cevabın kendi tahminine sızması azaldı. Puan koşullu log kaybı ve düşük olan daha iyi.
| Sınav | Ayrılmış öğrenci | Yerel kod koşullu log kaybı | GIRTH koşullu log kaybı |
|---|---|---|---|
| Matematik alanı, özgün 1405 formu | 89 | 0.4782 | 0.4156 |
| Deneysel Bilimler, özgün 1405 formu | 105 | 0.3375 | 0.2766 |
| Beşerî Bilimler, özgün 1405 formu | 234 | 0.3286 | 0.2854 |
| Matematik alanı, 1403 arşivi | 1,269 | 0.4023 | 0.3988 |
| Deneysel Bilimler, 1403 arşivi | 1,820 | 0.2361 | 0.2322 |
| Beşerî Bilimler, 1403 arşivi | 1,730 | 0.2369 | 0.2320 |
GIRTH altı dersin hepsinde daha düşük kayıp verdi. Fark üç küçük güncel sınavda belirgindi, arşiv sınavlarında küçüktü. İki uyarı gerekiyor. Log kaybındaki yüzde azalma, sınıflandırma doğruluğunda aynı yüzde kadar kazanç anlamına gelmez; bu yüzden onu öyle aktarmaktan kaçınıyorum. Ayrıca bu, ders başına tek bir sabit rastgele bölmeydi. Tekrarlanan çapraz doğrulama olmadan farkın bir bölmeden ötekine ne kadar değişeceğini söyleyemem.
Üç kontrol daha
Birincisi kuadratürdü. Kuadratür noktası sayısını 121'e, iterasyon sınırını 400'e çıkarmak, altı matematik dersinde ayırt ediciliği en fazla 0,0005'ten az değiştirdi. Demek ki sonuçları ızgara üretmiyordu.
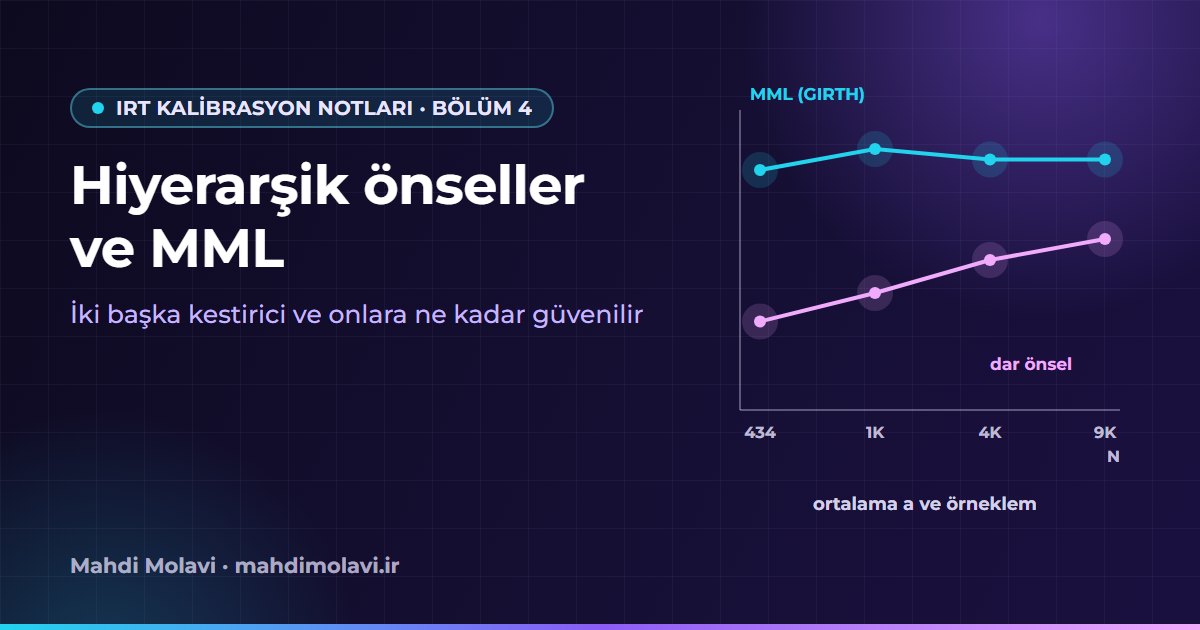
İkincisi büyüklük kararlılığıydı ve 3. bölümde kullanılan aynı sabit arşiv matematik soruları üzerinde yapıldı. N = 434'te alınan üç GIRTH örnekleminin ortalama a'sı yaklaşık 1,51 ile 1,76 arasındaydı. Aralık N = 1.000'de yaklaşık 1,70-1,78, N = 4.000'de yaklaşık 1,64-1,69 idi; 9.099 öğrencinin tamamıyla yapılan kestirimin ortalaması ise yaklaşık 1,67'ydi. Küçük örneklemler yine dalgalandı, en çok da en yüksek a değerleri. Ama ortalamada, yerel kodun bu sorularda gösterdiği alttan üste düzenli tırmanış görülmedi. Büyüklük başına birkaç örneklem az bir sayı, o yüzden bu aralıkları kaba kabul ediyorum.
Üçüncüsü bir bootstrap'ti. Üç güncel sınavın 90 matematik sorusu için öğrenciler üzerinden 100 bootstrap yeniden örneklemi aldım. Güncel Deneysel Bilimler sınavındaki yüksek a'lı maddenin a için yaklaşık aralığı 2,43-4,93'tü ve 100 yeniden örneklemin üçü 5'teki üst sınıra dayandı. Aralık geniş ve sınıra dayanan örneklemler, üst ucunun kısmen kütüphanenin limitini yansıttığını gösteriyor.
Seriyi dürüst tutan bir ayrım daha var. 3. bölümdeki simülasyonda yüksek ayırt ediciliği geri kazanan küçük MML karşılaştırıcısı ile buradaki GIRTH değerlendirmesi, farklı aşamalardan gelen ayrı uygulamalar. Simülasyon sonucu sentetik veri üzerindeki özel karşılaştırıcıya, bu bölümdeki gerçek veri sonuçları ise GIRTH'e ait.
İki alternatifin durumu
Hiyerarşik dal, tanımlanabilirlik sorunu çözülmemiş, keşif amaçlı bir alternatif. GIRTH ileri çalışma için umut verici doğrulama kanıtları sunuyor, ama buna üretime geçiş demem. Sınır davranışı, model yanlış belirlemesi, madde değişmezliği, tekrarlanan bölmeler ve bir kalibrasyonu uzun vadede sürdürmenin getirdiği iş hâlâ açık. En yüksek değerler tablosu da ayrılmış öğrenci tablosu da aynı yanıtlar üzerinde yerel koda göre ölçüyor ve bu işe yarıyor. Hiçbiri gerçek değerlere göre ölçmüyor; gerçek sınav soruları için o değerler kimsenin elinde yok.
Bana kalırsa MML sonuçları bu incelemedeki en cesaret verici sayılar, abartılması en kolay olanlar da onlar. Aynı yanıtlar üzerinde farklı bir kestirici, altı matematik dersinde ve her birinde tek bir bölmeyle, ayrılmış cevapları daha iyi tahmin etti. Bu, onun daha yüksek katsayılarını doğru yapmaz ve hangi soruların iyi olduğunu kimseye söylemez.
Şimdiye kadarki her karşılaştırma büyüklük başına tek bir alt küme, en fazla da birkaç alt küme kullandı. 5. bölüm bunların yerine dokuz sınavda büyüklük başına yirmi iç içe örneklem kullanan çalışmayı ve o çalıştırmayı tekrarlanabilir ve yeniden başlatılabilir kılmak için gereken mühendisliği anlatıyor.
Bu not İngilizce ve Farsça olarak da yayımlandı: İngilizce · Farsça.