قسمت ۳ با یک تشخیص مشخص تمام شد. برآوردگر محلی روی قدرت تمیز و دشواری، هر دو، یک توزیع پیشین نرمال با انحراف معیار ۰٫۱ میگذارد. روی مجموعهٔ ثابتی از ۳۰ سؤال، برآوردهایش با اضافه شدن دانشآموزان پیوسته بالا رفت. و وقتی فقط پیشینِ قدرت تمیز را باز کردم، روی یک مجموعهٔ پاسخ بدون تغییر از ۵۲۳ نفر، بیشینهٔ a از حدود ۰٫۹۳۴ به حدود ۲٫۶۳۷ رسید. بعد از دیدن این، قدم بعدی امتحان کردن یک برآوردگر دیگر است تا ببینیم وابستگی به حجم نمونه از بین میرود یا نه.
دو گزینه دم دست بود. کتابخانهٔ محلی خودش یک شاخهٔ سلسلهمراتبی دارد که پیشینهای سؤال را از داده یاد میگیرد. GIRTH، یک کتابخانهٔ متنباز و مستقل پایتون، همان تابع پاسخ 2PL را با درستنمایی بیشینهٔ حاشیهای (MML) برازش میدهد. هر دو را امتحان کردم. هر کدام به بخشی از سؤال جواب داد و سؤال تازهای باز کرد، و با شواهدی که تا اینجا جمع شده، هیچکدام را نمیشود بیدردسر جای برآوردگر عملیاتی گذاشت.
شاخهٔ سلسلهمراتبی هم model را عوض میکند و هم guide را
در Pyro، model داستان مولد است (پیشینها بهعلاوهٔ درستنمایی) و guide (توزیع تقریبی) خانوادهٔ تغییراتیای است که در استنباط تغییراتی تصادفی (SVI) توزیع پسین را تقریب میزند. آموزش SVI در Pyro این تفکیک را خوب توضیح میدهد. کلاس 2PL محلی یک model_hierarchical و یک guide_hierarchical متناظر با آن دارد، و انتخاب گزینهٔ سلسلهمراتبی هر دو را عوض میکند. این را صریح میگویم چون راحت میشود این آزمایش را فقط تغییر guide توصیف کرد، و این توصیف غلط است. پیشین هم عوض میشود و guide متناسب با آن تغییر میکند.
جایی که شاخهٔ ثابت پیشینهای سؤال را روی N(0, 0.1) نگه میدارد، شاخهٔ سلسلهمراتبی ابرپارامترهای مکان و مقیاس را با دامنهٔ گسترده یاد میگیرد. این کار کشش به سمت صفر را شل میکند و در عین حال به مقیاس پنهان هم اجازهٔ حرکت میدهد. در مدل 2PL، درستنمایی فقط حاصلضرب a(θ − b) را میبیند. اگر علامت θ و a و b را با هم برعکس کنید، همهٔ احتمالهای پیشبینیشده همان میماند. اگر θ و b را در یک ثابت مثبت ضرب و a را بر همان ثابت تقسیم کنید، باز هیچ چیز مشاهدهپذیری عوض نمیشود. چیزی در تنظیمات باید جهت و واحد مقیاس را ثابت کند، و با ابرپارامترهای یادگرفتهشده این چیز ضعیفتر است.
در یکی از اجراهای سلسلهمراتبی با نمونهٔ کوچک، جهت برعکس درآمد. تواناییهای برازششده برخلاف عملکرد تجربی دانشآموزان بود و قدرتهای تمیز هم همراه آنها برعکس شدند. خروجی خام را اگر سادهلوحانه بخوانید، میگوید سؤالها ناگهان معیوب شدهاند. سؤالها هیچ تغییری نکرده بودند. این یک مشکل شناساییپذیری و جهت مقیاس در برازش بود.
پس پیش از مقایسهٔ هر اجرای سلسلهمراتبی با یک اجرای پیشین ثابت، جهت مقیاس را با عملکرد تجربی همسو کردم و بعد ضرایب را بر حسب انحراف معیار توانایی برآوردشده بیان کردم:
theta_standardized = (theta - mean(theta)) / SD(theta)
a_standardized     = a * SD(theta)
b_standardized     = (b - mean(theta)) / SD(theta)
اول اصلاح جهت میآید و بعد تغییر مقیاس. این دو با هم همهٔ احتمالهای پاسخِ مدلشده را سر جایشان نگه میدارند، و برای همین اعمالشان درون یک برازش بیخطر است. مقیاس یک آزمون را به مقیاس آزمون دیگری وصل نمیکنند. قسمت ۶ به این تفاوت برمیگردد، چون مشکل اصلی مقایسهٔ سالها همین است.
یک مقایسهٔ کنترلشده
بستر آزمایش همان وضعیت کنترلشدهٔ قسمت ۳ بود: همان ۳۰ سؤال ریاضی آرشیوی، که یک بار روی زیرمجموعهای ۴۳۴ نفری و یک بار روی همهٔ ۹٬۰۹۹ دانشآموزِ دارای پاسخ قابل استفاده برازش شد.
| روش | میانگین a، واحد استانداردشده، N = 434 | میانگین a، واحد استانداردشده، N = 9,099 |
|---|---|---|
| شاخهٔ ثابت با پیشین باریک | 0.5874 | 1.1375 |
| شاخهٔ سلسلهمراتبی | 1.4894 | 1.2896 |
اینها واحدهای استانداردشدهاند، پس آنها را با میانگینهای خام جدول قسمت ۳ مقایسه نکنید. درون همین جدول، میانگین شاخهٔ پیشین ثابت از زیرمجموعهٔ کوچک تا کل استخر حدود ۹۴ درصد بالا رفت، در حالی که میانگین سلسلهمراتبی حدود ۱۳ درصد پایین آمد. در این آزمون تشخیصی، اثر حجم نمونه در شاخهٔ سلسلهمراتبی خیلی کوچکتر بود.
نتیجه فقط تا همینجا اعتبار دارد. اثر کوچکتر هنوز اثر است، از یک مجموعهٔ سؤال و یک زیرمجموعه میآید، و اجرای سلسلهمراتبی روی کل داده حتی بعد از اصلاح جهت یک قدرت تمیز منفی را نگه داشت. آزمایشهای سلسلهمراتبی قبلی هم سؤالهای منفی و مشکلات مقیاس خودشان را نشان داده بودند. این شاخه را با برچسب «اکتشافی» کنار گذاشتم. پیش از آنکه نامزد استفادهٔ عملیاتی شود، به قیدهای صریح شناساییپذیری، راه مناسبی برای مدل کردن قدرت تمیز مثبت، بررسی برازش، آزمایشهای بازیابی پارامتر و پایداری در برابر عوض شدن seed نیاز دارد. هیچکدام از اینها جزو این کار نبود.
GIRTH: همان 2PL، با برآورد درستنمایی بیشینهٔ حاشیهای
گزینهٔ دوم GIRTH نسخهٔ 0.8.0 با تابع twopl_mml بود. تابع پاسخ سؤال همان 2PL میماند. چیزی که عوض میشود روش برآورد است: بهجای برازش بیزی تغییراتیِ محلی، درستنمایی بیشینهٔ حاشیهای درستنمایی را روی یک توزیع توانایی فرضی انتگرال میگیرد و آن را نسبت به پارامترهای سؤال بیشینه میکند. پس این مقایسه برآوردگر را عوض میکند و مدل سؤال را نگه میدارد، و این تغییری خیلی بزرگتر از عوض کردن نام پارامترها یا دست بردن در یک ثابت در کد قدیمی است.
آن را روی یک استخراج تازه از پاسخها و با این پیکربندی اجرا کردم:
- یک توزیع توانایی مرجع ثابت N(0, 1) که شکلش دوباره برآورد نشد؛
- ۶۱ نقطهٔ کوادراتور روی [−6, 6]؛
- حداکثر ۲۰۰ گام بهینهسازی (iteration)، بدون تقریب جدول جستوجو؛
- حدود سؤال در این نسخهٔ کتابخانه: قدرت تمیز در [0.2, 5] و دشواری در [−6, 6]؛
- پاسخهای دیدهنشده بهصورت صریح با برچسب گمشده داده شدند و از پاسخهای غلطِ مشاهدهشده جدا ماندند، مطابق کدگذاریای که در قسمت ۲ توضیح دادم؛
- سؤالهایی که هیچ پاسخ قابل استفادهای نداشتند، یا همهٔ پاسخهایشان درست یا همه غلط بود، بهجای گرفتن یک برآورد آزاد، برآوردناپذیر شناخته شدند.
در شکل نمایشی، فراخوانی کوتاه است. کار اصلی آماده کردن ماتریس و خواندن دقیق خروجی است.
from girth import twopl_mml

# Illustrative sketch; the exact option keys live in the pinned study scripts.
# responses: items x students, unseen responses tagged as missing (never as 0)
# study_options: fixed N(0, 1) ability distribution, 61 quadrature points
#   on [-6, 6], at most 200 iterations, no lookup-table approximation
estimates = twopl_mml(responses, options=study_options)
# read discrimination and difficulty from the result, then flag any value
# that sits on a bound and any nonestimable question
هر ۳۴ گروه درس اصلیِ مشمول در این مطالعهٔ ششآزمونی به شرط همگرایی داخلی GIRTH رسیدند. این گروهها روی هم ۸۸۵ ردیف سؤال در درسها و آزمونهای مختلف داشتند که ۸۲۵ سؤال محتوایی متمایز را پوشش میداد. هیچ برآورد نهاییای روی کران بالای قدرت تمیز ننشست. یک برآورد روی کران پایین a نشست و ۱۸ برآورد روی یکی از کرانهای دشواری. همه را علامت زدم، چون مقداری که روی کران نشسته جایی را نشان میدهد که یک حد جلوی بهینهساز را گرفته، و برآورد بدون قید به حساب نمیآید.
بیشینههای بزرگتر
اینها بیشینههای تازهٔ کد محلی و GIRTH برای درس ریاضی هر یک از شش آزمون قسمت ۱ است. هر دو ستون برازش دوباره روی دادههای استخراجشدهٔ همین مطالعهاند. کپی ضرایب عملیاتیِ ذخیرهشده نیستند، و با کنترل تکزیرمجموعهای قسمت ۳ هم یکی نیستند.
| آزمون | دانشآموزان ریاضیِ قابل استفاده | بیشینهٔ a در برازش تازهٔ کد محلی | بیشینهٔ a در GIRTH |
|---|---|---|---|
| رشتهٔ ریاضی، فرم اصلی ۱۴۰۵ | 443 | 0.87 | 1.70 |
| علوم تجربی، فرم اصلی ۱۴۰۵ | 523 | 0.97 | 3.31 |
| علوم انسانی، فرم اصلی ۱۴۰۵ | 1,169 | 1.27 | 2.18 |
| رشتهٔ ریاضی، آرشیو ۱۴۰۳ | 6,343 | 1.53 | 1.85 |
| علوم تجربی، آرشیو ۱۴۰۳ | 9,099 | 1.74 | 2.24 |
| علوم انسانی، آرشیو ۱۴۰۳ | 8,650 | 1.72 | 2.35 |
همانطور که قسمت ۲ توضیح داد، تعداد قابل استفاده باز هم با حاضران رسمی فرق دارد (مثلاً در آزمون جاری رشتهٔ ریاضی، ۴۴۳ دانشآموز ریاضیِ قابل استفاده در برابر ۴۳۴ حاضر رسمی). بیشینهٔ GIRTH در همهٔ ردیفها بالاتر است. فاصله در آزمونهای کوچکِ جاری از همه بیشتر است، جایی که بیشینهٔ کد محلی در دو آزمون از سه آزمون زیر ۱ میماند، و در آزمونهای بزرگ آرشیوی از همه کمتر.
بیشینهٔ بزرگتر بهتنهایی چیزی دربارهٔ دقت ثابت نمیکند، چون برآوردگری با شیبهای بادکرده هم همین را تولید میکند. بررسیای که بیشتر به آن اعتماد داشتم پیشبینی پاسخهایی بود که برازش هرگز ندیده بود.
پیشبینی برای دانشآموزان کنارگذاشته
برای هر یک از شش درس ریاضی، پیش از برازش ۲۰ درصد دانشآموزان را کنار گذاشتم. برای امتیاز دادن به پاسخ یک دانشآموز کنارگذاشته به یک سؤال، توانایی او بدون همان پاسخ هدف استنباط شد، و این کار نشت پاسخی را که پیشبینی میشد به پیشبینی خودش کم میکرد. معیار امتیاز لگلاس (log loss) شرطی است و هرچه کمتر باشد بهتر است.
| آزمون | دانشآموزان کنارگذاشته | لگلاس شرطی کد محلی | لگلاس شرطی GIRTH |
|---|---|---|---|
| رشتهٔ ریاضی، فرم اصلی ۱۴۰۵ | 89 | 0.4782 | 0.4156 |
| علوم تجربی، فرم اصلی ۱۴۰۵ | 105 | 0.3375 | 0.2766 |
| علوم انسانی، فرم اصلی ۱۴۰۵ | 234 | 0.3286 | 0.2854 |
| رشتهٔ ریاضی، آرشیو ۱۴۰۳ | 1,269 | 0.4023 | 0.3988 |
| علوم تجربی، آرشیو ۱۴۰۳ | 1,820 | 0.2361 | 0.2322 |
| علوم انسانی، آرشیو ۱۴۰۳ | 1,730 | 0.2369 | 0.2320 |
لگلاس GIRTH در هر شش درس کمتر بود. تفاوت در سه آزمون کوچکِ جاری روشن بود و در آزمونهای آرشیوی کم. دو احتیاط لازم است. کاهش درصدی لگلاس به معنای بهبود به همان درصد در دقت طبقهبندی نیست، برای همین آن را اینطور نقل نمیکنم. و این فقط یک تقسیم تصادفی ثابت برای هر درس بود. بدون اعتبارسنجی متقابل تکراری نمیتوانم بگویم این فاصله از یک تقسیم به تقسیم دیگر چقدر تغییر میکند.
سه بررسی دیگر
اولی کوادراتور بود. بالا بردن تعداد نقاط کوادراتور به ۱۲۱ و سقف گامها به ۴۰۰، قدرت تمیز را در شش درس ریاضی حداکثر کمتر از ۰٫۰۰۰۵ تغییر داد، پس نتیجهها ساختهٔ شبکهٔ کوادراتور نبودند.
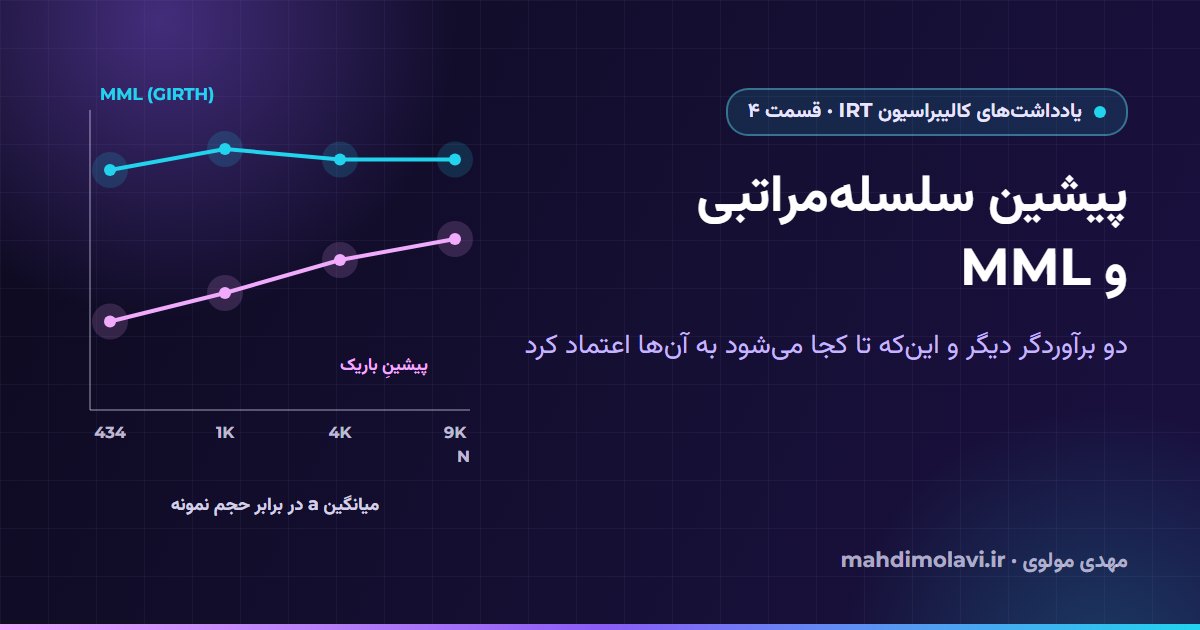
دومی پایداری در برابر حجم نمونه بود، روی همان سؤالهای ثابت ریاضیِ آرشیوی که در قسمت ۳ به کار رفت. سه نمونهٔ GIRTH با N برابر ۴۳۴ میانگین a بین حدود ۱٫۵۱ و ۱٫۷۶ داشتند. با N برابر ۱٬۰۰۰ دامنه حدود ۱٫۷۰ تا ۱٫۷۸ بود، با ۴٬۰۰۰ حدود ۱٫۶۴ تا ۱٫۶۹، و برازش کامل روی ۹٬۰۹۹ دانشآموز میانگینی حدود ۱٫۶۷ داشت. نمونههای کوچک هنوز نوسان داشتند و بیشینهٔ a بیش از همه، اما میانگین آن صعود پیوسته از پایین به بالا را نشان نداد که کد محلی روی همین سؤالها نشان داده بود. چند نمونه برای هر حجم عدد کمی است، برای همین این دامنهها را تقریبی میدانم.
سومی بوتاسترپ بود. برای ۹۰ سؤال ریاضیِ سه آزمون جاری ۱۰۰ بوتاسترپ روی دانشآموزان اجرا کردم. سؤالی که در آزمون جاری علوم تجربی a بالایی داشت بازهٔ تقریبی ۲٫۴۳ تا ۴٫۹۳ برای a پیدا کرد، و سه بازنمونه از ۱۰۰ به کران بالای ۵ خوردند. بازه پهن است، و برخورد با کران یعنی انتهای بالایی آن تا حدی حد کتابخانه را نشان میدهد.
یک تمایز دیگر هم این مجموعه را صادق نگه میدارد. مقایسهگر کوچک MML که در شبیهسازی قسمت ۳ قدرت تمیز بالا را بازیابی کرد و ارزیابی GIRTH در اینجا دو پیادهسازی جدا از دو مرحلهٔ جدا هستند. نتیجهٔ شبیهسازی مال مقایسهگر سفارشی روی دادهٔ مصنوعی است و نتیجههای دادهٔ واقعی در این قسمت مال GIRTH.
دو جایگزین الان کجا هستند
شاخهٔ سلسلهمراتبی یک جایگزین اکتشافی با یک مشکل حلنشدهٔ شناساییپذیری است. GIRTH شواهد اعتبارسنجی امیدوارکنندهای برای کار بیشتر میدهد و من اسمش را مهاجرت عملیاتی نمیگذارم. رفتار در کرانها، خطای تصریح مدل، ناوردایی سؤال، تقسیمهای تکراری و کار بلندمدت نگهداری یک کالیبراسیون همه باز ماندهاند. جدول بیشینهها و جدول دانشآموزان کنارگذاشته هر دو در برابر کد محلی و روی همان پاسخها سنجیده شدهاند، که مفید است. هیچکدام در برابر مقدار واقعی سنجیده نشدهاند، چون برای سؤالهای واقعی آزمون کسی آن را در دست ندارد.
برداشت خودم این است که نتیجههای MML امیدوارکنندهترین عددهای این بررسیاند و در عین حال راحتتر از همه میشود در آنها اغراق کرد. روی همان پاسخها، یک برآوردگر دیگر پاسخهای کنارگذاشته را در شش درس ریاضی، هر کدام با یک تقسیم، بهتر پیشبینی کرد. این نتیجه ضرایب بالاترش را درست نمیکند و به هیچکس نمیگوید کدام سؤالها خوباند.
همهٔ مقایسهها تا اینجا برای هر حجم یک زیرمجموعه، یا حداکثر چند تا، داشتند. قسمت ۵ مطالعهای را توصیف میکند که بهجای آنها بیست نمونهٔ تودرتو برای هر حجم در نُه آزمون گذاشت، و کار مهندسیای را که لازم بود تا آن اجرا تکرارپذیر و قابل ازسرگیری باشد.
این یادداشت به انگلیسی هم منتشر شده است: نسخهٔ انگلیسی.