Popülasyon tanımlandıktan sonra sıradaki şüpheli kestiriciydi. Gömülü py-irt kopyasının model, eğitim ve yapılandırma dosyalarını açtım ve ana çalışmanın kullandığı her ayarı not ettim. Çoğu beklenecek değerlerdi. İstisna, madde parametreleri üzerindeki önsellerdi; ait oldukları modun adı da vague (belirsiz) idi.
Ayarlar
Yerel kaynak koddan ve araştırma sarmalayıcısından (wrapper) okunan, ana çalışmada kullanılan değerler şunlar:
| Ayar | Ana çalışmadaki değer |
|---|---|
| Model | Gömülü kopyadaki TwoParamLog, bir 2PL |
| Önsel modu | vague |
| Yetenek önseli | Normal, ortalama 0, standart sapma 1 |
| Güçlük önseli | Normal, ortalama 0, standart sapma 0,1 |
| Ayırt edicilik önseli | Normal, ortalama 0, standart sapma 0,1 |
| Çıkarım | Stokastik varyasyonel çıkarım, Trace_ELBO |
| Optimize edici | Üstel öğrenme oranı azalımlı Adam |
| Başlangıç öğrenme oranı | 0.1 |
| Azalım çarpanı | Eğitim adımı başına 0,9999 |
| Eğitim uzunluğu | 2.000 epok |
| Dışa aktarım | best_params, gözlenen en düşük eğitim kaybından |
| Ana eğitim seed'i | 42, araştırma sarmalayıcısı açıkça ayarladı |
| Yürütme | CPU; dört süreç, süreç başına bir hesaplama iş parçacığı |
| Lambda çıktısı | Sabit 0,25 |
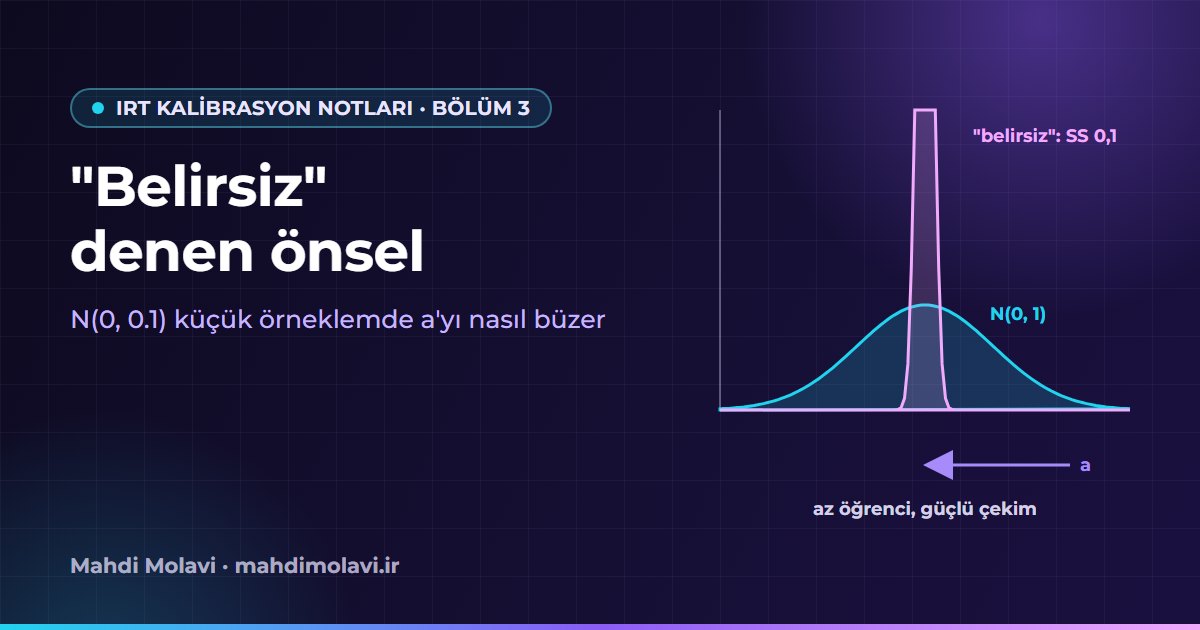
Yetenek önseli N(0, 1) standart bir tercih. İlginç olan madde önselleri. Onlardaki 0,1 bir standart sapma, yani varyans 0,01. Standart sapması 0,1 olan bir normal dağılım, kütlesinin yaklaşık %95'ini −0,2 ile 0,2 arasına koyar. 1 civarı ve üstündeki değerlerin olağan olduğu bir ayırt edicilik parametresi için bu, yapılandırma ona ne ad verirse versin, güçlü biçimde yoğunlaşmış bir önseldir.
Önselin bedeli
Sabitler bir kenara bırakılırsa bu ayırt edicilik önselinin negatif log-yoğunluğu şudur:
a^2 / (2 * 0.1^2) = 50 * a^2
Aynı ifade güçlük için de geçerli. a = 1 olduğunda terim 50, a = 2 olduğunda 200'dür. Gözlenen her yanıt, verinin desteklediği eğim hangisiyse o yöne çeken bir olabilirlik terimi ekler. Bir sorunun az yanıtı olduğunda önselin sıfıra doğru çekişi bu kanıta göre daha ağır basar. Yanıt çok olduğunda olabilirlik sıfırdan daha uzak değerleri destekleyebilir.
Bu ifadeyi büzülmeyi açıklamak için kullanıyorum. Dışa aktarılan katsayı onunla hesaplanamaz. Kestirim varyasyonel: Önsel terimi, olabilirlikle ve guide'ın, yani optimize edicinin ayarladığı varyasyonel yaklaşım dağılımının entropisiyle birlikte beklenen bir amaç fonksiyonunun içinde durur. Bu kavramla daha önce karşılaşmadıysanız Pyro SVI öğreticisi model, guide ve ELBO arasındaki ayrımı iyi anlatıyor.
Guide'ın birkaç ayrıntısını akılda tutmakta fayda var, çünkü yanlış anlatılmaları kolay:
- Yetenek konumu sıfırdan, ölçeği birden başlar.
- Güçlük konumu sıfırdan, guide ölçeği 10'dan başlar.
- Ayırt edicilik konumu birden başlar ve pozitif olmaya zorlanır; guide ölçeği 1e-6 değerinden başlar.
Pozitiflik kısıtı guide'ın konumu üzerindedir. Ayırt edicilik üzerindeki üretici önsel yine sıradan bir Normal dağılım; ona lognormal ya da kesilmiş Normal önsel demek başka bir modeli anlatmak olur.
Bir de dışa aktarım var. best_params, çalıştırmanın gözlediği en düşük eğitim kaybındaki parametre kümesidir. Stokastik bir işlemden çıkan bir nokta kestirimidir. Yakınsamayı kanıtlamaz ve sonsal bir belirsizlik aralığı taşımaz. Tekrarlanabilirlik de açık bir denetim gerektiriyordu: Araştırma sarmalayıcısı seed'i ve iş parçacığı sayılarını kendisi ayarladı, çünkü yalnızca bir cores argümanı geçmek bu denetimin yerini tutmaz. Üretim servisinin örtük seed davranışının ya da tam çalışma ortamının araştırma ortamıyla aynı olduğunu tespit etmedim.
Aynı sorular, farklı N
Önseller üzerine tartışmak kolay. Beni ikna eden deney soruları ve kaynak yanıtları sabit tuttu, yalnızca öğrenci sayısını değiştirdi. 1403 Deneysel Bilimler arşiv sınavının 30 matematik sorusunu aldım; o çekimde 9.099 öğrencinin kullanılabilir yanıtı vardı. Aynı dondurulmuş kaynaktan farklı büyüklükte alt kümeler çektim. Bu değerler sonradan yapılan yeni kontrollü çalıştırmadan geliyor, daha önceki keşif amaçlı kestirimlerden değil:
| N | Doğru yanıt oranı | Ortalama a | En yüksek a | Ortalama b | Kişi başına doğru yanıt oranının standart sapması |
|---|---|---|---|---|---|
| 434 | 9.073% | 0.7665 | 0.9043 | 0.2767 | 0.12395 |
| 1,000 | 9.037% | 0.9953 | 1.1387 | 0.5168 | 0.12329 |
| 4,000 | 9.074% | 1.3594 | 1.5826 | 1.1233 | 0.12004 |
| 9,099 | 8.753% | 1.4986 | 1.7853 | 1.5166 | 0.11790 |
Her satırda sorular aynı. Doğru yanıt oranı %9 civarında kalıyor ve öğrencilerin gözlenen doğru yanıt oranlarının yayılımı N ile büyümüyor, hatta biraz daralıyor. Buna karşın ortalama a, 434 ile 9.099 öğrenci arasında kabaca iki katına çıkıyor ve en yüksek a yaklaşık 0,90'dan yaklaşık 1,79'a yükseliyor.
Bence bu, kestirici ile örneklem büyüklüğü arasındaki bir etkileşim ve birbiriyle ilgisiz sınavların en yüksek değerlerini karşılaştırmaktan çok daha güçlü bir kanıt. Yine de sınırları gerçek. Bu erken tablo, daha küçük her büyüklük için seçilmiş tek bir alt küme kullandı; dolayısıyla bir ders için bir yön ve kabaca bir büyüklük gösteriyor. Etkinin her derste ya da her popülasyondaki büyüklüğünü vermiyor. 5. bölüm deneyi dokuz sınav üzerinde, her büyüklük için yirmi örneklemle tekrarlıyor.
Tek bir önseli genişletmek
Örüntüyü dar önsel belirliyorsa, veri değişmeden onu gevşetmek kestirimleri oynatmalı. Güncel Deneysel Bilimler sınavının 523 kişilik matematik yanıt kümesini aldım ve bellekte yalnızca ayırt edicilik önselinin standart sapmasını 0,1'den 0,5'e genişlettim. Kaynak dosyalara dokunulmadı. Yeni varsayılan kestirimin en yüksek a değeri yaklaşık 0,934'tü. Duyarlılık kestiriminde en yüksek değer yaklaşık 2,637, ortalama a ise yaklaşık 1,962 çıktı.
Tek bir ayar için bu büyük bir oynama ve kestirimin önsele güçlü biçimde bağlı olduğunu gösteriyor. 0,5'in doğru önsel olduğunu, büyük değerlerin gerçek değerler olduğunu ya da üretimin hemen geçiş yapması gerektiğini göstermiyor. Daha önceki keşif amaçlı raporlarda bunlara yakın ama farklı değerler var, örneğin 523 kişilik bir arşiv alt kümesi için farklı en yüksek değerler. Onlar ayrı çekilişler ve yeniden yapılmış kestirimlerdi; tek tutarlı örnek olarak bu adı konmuş yeni kontrolü kullanıyorum.
434 öğrenci yüksek ayırt ediciliği taşıyabilir mi?
Gerçek soruların asıl parametre değerlerini bilmiyoruz, bu yüzden gerçek veri tek başına "bu soruların ayırt ediciliği düşük" ile "bu kestirici bu büyüklükte düşük ayırt edicilik döndürüyor" arasında ayrım yapamaz. Bir simülasyon yapabilir. Her biri 434 öğrenci ve 30 sorudan oluşan üç bağımsız ikili yanıt matrisi ürettim:
theta ~ Normal(0, 1)
true discrimination values: 2.0 to 3.5, mean 2.75
true difficulty values: -1.5 to +1.5
Y ~ Bernoulli(sigmoid(a * (theta - b)))
Bunlar sentetik matrisler; arkalarında yazılmış eğitsel sorular yok. Her matrisin parametrelerini hem güncel kodla hem de marjinal en çok olabilirlik (MML) kullanan küçük bir referans kestiriciyle kestirdim. Referans kestiriciye gerçek yetenekler verilmedi.
| Simülasyon | Gerçek ortalama a | Güncel kodun ortalama a değeri | Referans MML ortalama a | Güncel kodun a RMSE değeri | Referans MML a RMSE |
|---|---|---|---|---|---|
| 1 | 2.750 | 0.676 | 2.593 | 2.116 | 0.371 |
| 2 | 2.750 | 0.678 | 2.664 | 2.115 | 0.386 |
| 3 | 2.750 | 0.677 | 2.838 | 2.112 | 0.307 |
Referans kestirici, bu kontrol için kurduğum küçük bir araştırma karşılaştırıcısıydı. N(0, 1) yetenek dağılımı üzerinden Gauss-Hermite kuadratürüyle integral alıyor, log(a) ve b'yi L-BFGS-B ile optimize ediyordu. Tam teşekküllü bir test programının altyapısı olma iddiası yok. İlk veri kümesinde kuadratür noktalarını 121'den 181'e çıkarmak en yüksek a değerini yaklaşık 0,00017 değiştirdi; yani sonuçlarını ızgara belirlemiyordu. 4. bölümdeki GIRTH değerlendirmesinden de ayrı bir gerçeklemedir.
Güncel kod, gerçek ortalama a değeri 2,75 olacak şekilde üretilmiş veride üç çalıştırmanın üçünde de yaklaşık 0,68 ortalama a döndürdü ve hatası karşılaştırıcınınkinin beş katından fazlaydı. Tek bir soru bunu somutlaştırıyor. İlk simülasyondaki sentetik 29. sorunun gerçek a değeri 2,4138'di. Güncel kod 0,7014, MML karşılaştırıcısı 2,4601 kestirdi. Karşılaştırıcının öğrenciler üzerinden bootstrap'i yaklaşık %95'lik [2,0507; 3,1238] aralığını verdi ve 200 bootstrap kestiriminin hepsi yakınsadı.
Bunun desteklediği şey şu: N = 434, ayırt ediciliği birin altına zorlayan bir tavan koymaz. Bilinen bir model ve üretilmiş veriyle, elverişli koşullarda yüksek ayırt edicilik bu büyüklükte geri kazanılabilir. Desteklemediği şey ise gerçek üretim sorularının gerçek a değerinin 2,75 civarında olduğu ya da 434 öğrencinin her soru için yeterli kesinliği garanti ettiğidir.
"200 öğrenci yeterlidir" kuralı soruyu neden cevaplamadı
1. bölümdeki pratik kural bu noktada yeniden gündeme geldi, çünkü ilk bakışta 434 öğrenci onu rahatça geçiyor. Hiçbir örneklem büyüklüğü eşiği her model ve yanıt örüntüsü için isabetli katsayıları garanti etmez. Önemli olan N çoğu zaman soru başına kullanılabilir yanıt sayısıdır ve 2. bölümün gösterdiği gibi bu sayı kayıtlardan ya da resmî katılımdan farklı olabilir. Kesinlik modele, kestiriciye, önsele, sorunun güçlüğüne ve ayırt ediciliğine, yetenek aralığının ne kadar iyi kapsandığına, eksik verilere ve boş bırakılan yanıtlar için izlenen politikaya, bir de kararın ne kadar isabetli olması gerektiğine bağlıdır.
Yayımlanmış kılavuzlar var. ETS'nin IRT'ye giriş metni yaklaşık örneklem büyüklüklerini, kılavuz bir slogana dönüştüğünde kaybolmaya yatkın çekinceleriyle birlikte tartışıyor. Bu boru hattı için aynı sorularla yapılan büyüklük deneyi ve simülasyon bana herhangi bir genel eşikten daha çok şey söyledi. Yerel kodla, sabit sorularda 434 öğrenci 0,7665 ortalama a verdi; 9.099 kişilik tam havuzda bu değer 1,4986 idi.
Güçlük de oynadı. O kontrollü sabit soru tablosunda ortalama b, 434 ile 9.099 öğrenci arasında yaklaşık 0,277'den 1,517'ye çıktı. Soru metinleri daha çok kişi çözdükçe zorlaşmadı; dolayısıyla bu kayma kestirimden kaynaklanıyor ve bu boru hattından çıkan b değerlerini farklı büyüklükteki sınavlar arasında karşılaştıracak herkes için bir uyarı niteliğinde.
Açıklama şimdi nerede duruyor
Artık daha dar bir iddiayı bir ölçüde güvenle dile getirebilirim. Sabit sorularda, yerel dar önselli kestiricinin katsayıları N ile güçlü biçimde değişti; önsel duyarlılık kontrolü ve simülasyon da önsel ve kestirim etkilerine işaret ediyor. Bu, bu gerçekleme için bir açıklamayı destekliyor. Üretim tablolarındaki her farkı tek başına önselin açıkladığını göstermiyor ve her Bayesçi kestiricinin böyle davranacağı anlamına da gelmiyor. Daha çok öğrencinin bir soruyu daha ayırt edici yaptığı anlamına ise hiç gelmiyor.
Akla gelen bir sonraki soru, farklı bir kestiricinin daha iyi davranıp davranmayacağıydı. 4. bölüm iki tanesini deniyor: aynı kütüphane içinde kendi yön sorunlarını da getiren hiyerarşik bir önsel ve GIRTH ile marjinal en çok olabilirlik.
Bu not İngilizce ve Farsça olarak da yayımlandı: İngilizce · Farsça.