بعد از تعریف جمعیت، مظنون بعدی برآوردگر بود. فایلهای مدل، آموزش و پیکربندیِ نسخهٔ داخلی py-irt را باز کردم و همهٔ تنظیماتی را که مطالعهٔ اصلی به کار میبرد یادداشت کردم. بیشترشان همانی بودند که انتظار میرود. استثنا پیشینهای پارامترهای سؤال بود، و حالتی که به آن تعلق داشتند vague (مبهم) نام داشت.
تنظیمات
اینها مقدارهاییاند که از کد منبع محلی و wrapper پژوهشی خوانده شدهاند، به همان شکلی که در مطالعهٔ اصلی به کار رفتند:
| تنظیم | مقدار در مطالعهٔ اصلی |
|---|---|
| مدل | TwoParamLog داخلی، یک 2PL |
| حالت پیشین | vague |
| پیشین توانایی | نرمال، میانگین 0، انحراف معیار 1 |
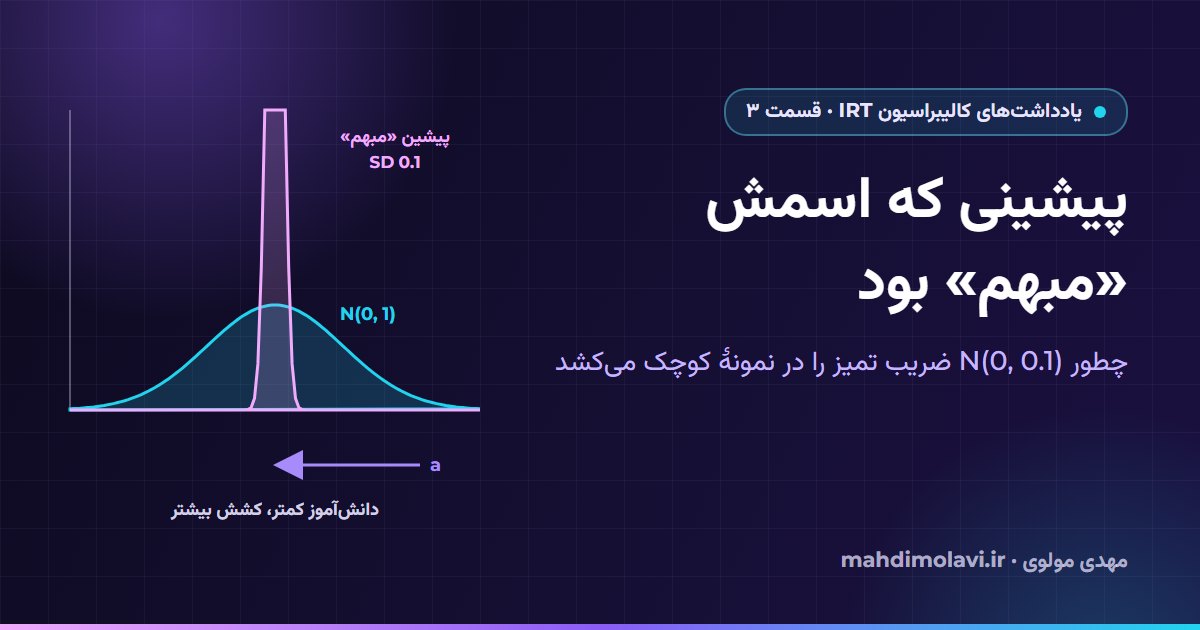
| پیشین دشواری | نرمال، میانگین 0، انحراف معیار 0.1 |
| پیشین قدرت تمیز | نرمال، میانگین 0، انحراف معیار 0.1 |
| استنباط | استنباط تغییراتی تصادفی، Trace_ELBO |
| بهینهساز | Adam با کاهش نمایی نرخ یادگیری |
| نرخ یادگیری اولیه | 0.1 |
| ضریب کاهش | 0.9999 در هر گام آموزشی |
| طول آموزش | 2,000 epoch |
| خروجی نهایی | best_params، از کمترین زیان آموزشیِ مشاهدهشده |
| seed اصلی آموزش | 42، که wrapper پژوهشی آن را صریحاً تنظیم میکرد |
| اجرا | CPU؛ چهار پروسه، یک ترد محاسباتی برای هر پروسه |
| خروجی Lambda | ثابت 0.25 |
پیشین توانایی، N(0, 1)، انتخابی استاندارد است. ردیفهای جالب پیشینهای سؤالاند. عدد ۰٫۱ در آنها انحراف معیار است، پس واریانس ۰٫۰۱ است. توزیع نرمال با انحراف معیار ۰٫۱ حدود ۹۵٪ جرمش را بین −۰٫۲ و ۰٫۲ میگذارد. برای پارامتر قدرت تمیز، که مقدارهای حدود ۱ و بیشتر در آن عادی است، این پیشینی بهشدت متمرکز است، فارغ از اینکه پیکربندی چه اسمی رویش گذاشته باشد.
هزینهٔ پیشین
اگر از ثابتها صرفنظر کنیم، منفی لگاریتم چگالی این پیشین قدرت تمیز برابر است با
a^2 / (2 * 0.1^2) = 50 * a^2
و همین عبارت برای دشواری هم صدق میکند. وقتی a برابر ۱ است این جمله ۵۰ میشود و وقتی a برابر ۲ است، ۲۰۰. هر پاسخ مشاهدهشده یک جملهٔ درستنمایی اضافه میکند که به سمت شیبی میکشد که داده پشتیبانیاش میکند. وقتی سؤالی پاسخهای کمی دارد، کشش پیشین به سمت صفر در مقایسه با این شواهد وزن بیشتری پیدا میکند. با پاسخهای زیاد، درستنمایی میتواند از مقدارهای دورتر از صفر پشتیبانی کند.
از این عبارت برای توضیح انقباض استفاده میکنم. با آن نمیشود ضریب صادرشده را حساب کرد. برازش تغییراتی است: جملهٔ پیشین همراه با درستنمایی و آنتروپی guide، یعنی توزیع تقریبیای که بهینهساز تنظیمش میکند، درون یک تابع هدفِ مبتنی بر امید ریاضی قرار دارد. اگر با تقسیم کار بین مدل، guide و ELBO آشنا نیستید، آموزش SVI در Pyro آن را خوب توضیح میدهد.
چند جزئیات از guide را بهتر است در ذهن داشت، چون بهراحتی اشتباه توصیف میشوند:
- پارامتر مکانِ توانایی از صفر شروع میشود و مقیاسش از یک.
- پارامتر مکانِ دشواری از صفر شروع میشود و مقیاس guide آن از ۱۰.
- پارامتر مکانِ قدرت تمیز از یک شروع میشود و مقیدش کردهاند که مثبت بماند؛ مقیاس guide آن از 1e-6 شروع میشود.
قید مثبت بودن روی پارامتر مکانِ guide است. پیشین مولد روی قدرت تمیز هنوز یک نرمال معمولی است، پس اگر آن را پیشین لگنرمال یا نرمال بریده بنامیم، مدل دیگری را توصیف کردهایم.
بعد نوبت خروجی نهایی است. best_params مجموعه پارامترها در کمترین زیان آموزشیای است که اجرا مشاهده کرده. این یک برآورد نقطهای از یک فرایند تصادفی است. همگرایی را ثابت نمیکند و هیچ بازهٔ عدم قطعیت پسینی هم با خودش ندارد. تکرارپذیری هم کنترل صریح لازم داشت: wrapper پژوهشی seed و تعداد تردها را خودش تنظیم میکرد، چون صرفاً پاس دادن آرگومانی برای تعداد هستهها جای این کنترل را نمیگیرد. ثابت نکردم که رفتار ضمنی سرویس عملیاتی در مورد seed یا محیط اجرای دقیق آن با محیط اجرای پژوهشی یکسان بوده است.
همان سؤالها، N متفاوت
بحث دربارهٔ پیشینها ارزان است. آزمایشی که قانعم کرد سؤالها و پاسخهای منبع را ثابت نگه داشت و فقط تعداد دانشآموزان را تغییر داد. ۳۰ سؤال ریاضی آزمون آرشیو علوم تجربی ۱۴۰۳ را برداشتم، که در آن استخراج ۹٬۰۹۹ دانشآموز پاسخ قابل استفاده داشتند، و از همان منبع منجمد زیرمجموعههایی با اندازههای مختلف بیرون کشیدم. این مقدارها از اجرای کنترلشدهٔ تازهای میآیند که بعدها انجام شد، نه از برازشهای اکتشافی اولیه:
| N | نرخ پاسخ درست | میانگین a | بیشینهٔ a | میانگین b | انحراف معیار نسبت پاسخ درستِ هر فرد |
|---|---|---|---|---|---|
| 434 | 9.073% | 0.7665 | 0.9043 | 0.2767 | 0.12395 |
| 1,000 | 9.037% | 0.9953 | 1.1387 | 0.5168 | 0.12329 |
| 4,000 | 9.074% | 1.3594 | 1.5826 | 1.1233 | 0.12004 |
| 9,099 | 8.753% | 1.4986 | 1.7853 | 1.5166 | 0.11790 |
سؤالها در همهٔ ردیفها یکیاند. نرخ پاسخ درست نزدیک ۹٪ میماند، و پراکندگی نسبتهای پاسخ درستِ مشاهدهشدهٔ دانشآموزان با بزرگ شدن N بیشتر نمیشود؛ کمی هم کم میشود. با این حال میانگین a بین ۴۳۴ و ۹٬۰۹۹ دانشآموز تقریباً دو برابر میشود، و بیشینهٔ a از حدود ۰٫۹۰ به حدود ۱٫۷۹ میرسد.
تفسیر من این است که این یک برهمکنش بین برآوردگر و حجم نمونه است، و شاهدی است بسیار قویتر از مقایسهٔ بیشینهها بین آزمونهای نامرتبط. البته محدودیتها واقعیاند. این جدولِ اولیه برای هر حجم کوچکتر فقط یک زیرمجموعهٔ انتخابشده داشت، پس جهت و اندازهٔ تقریبی اثر را برای یک درس نشان میدهد. اندازهٔ اثر را در هر درس یا جمعیتی به دست نمیدهد. قسمت ۵ این آزمایش را با بیست نمونه در هر حجم روی نُه آزمون تکرار میکند.
باز کردن یک پیشین
اگر پیشین باریک عامل این الگوست، شل کردنش روی دادهٔ بدون تغییر باید برآوردها را جابهجا کند. مجموعهٔ پاسخ ریاضیِ ۵۲۳ نفریِ آزمون جاری علوم تجربی را برداشتم و، در حافظه، فقط انحراف معیار پیشین قدرت تمیز را از ۰٫۱ به ۰٫۵ بردم. فایلهای منبع ویرایش نشدند. برازش پیشفرض تازه بیشینهٔ a حدود ۰٫۹۳۴ داشت. برازش حساسیت به بیشینهٔ حدود ۲٫۶۳۷ و میانگین a حدود ۱٫۹۶۲ رسید.
این جابهجایی بزرگی است که فقط از یک تنظیم آمده، و شاهدی است بر اینکه برآورد بهشدت به پیشین وابسته است. نشان نمیدهد که ۰٫۵ پیشین درست است، که مقدارهای بزرگتر مقدارهای واقعیاند، یا که محیط عملیاتی باید فوراً تغییر کند. گزارشهای اکتشافی قبلی مقدارهای نزدیکی دارند که با اینها فرق دارند، مثلاً بیشینههای متفاوت برای یک زیرمجموعهٔ ۵۲۳ نفری از آرشیو. آنها نمونهگیریها و برازشهای جداگانهای بودند، و من همین کنترل تازه و مشخص را بهعنوان تنها مثال منسجم نگه میدارم.
آیا ۴۳۴ دانشآموز میتوانند پشتوانهٔ قدرت تمیز بالا باشند؟
پارامترهای واقعی سؤالهای واقعی ناشناختهاند، پس دادهٔ واقعی بهتنهایی نمیتواند «این سؤالها قدرت تمیز پایینی دارند» را از «این برآوردگر در این حجم قدرت تمیز پایین برمیگرداند» جدا کند. شبیهسازی میتواند. سه ماتریس پاسخ دودویی مستقل تولید کردم، هر کدام با ۴۳۴ دانشآموز و ۳۰ سؤال:
theta ~ Normal(0, 1)
true discrimination values: 2.0 to 3.5, mean 2.75
true difficulty values: -1.5 to +1.5
Y ~ Bernoulli(sigmoid(a * (theta - b)))
اینها ماتریسهای مصنوعیاند، نه سؤالهای آموزشیِ طراحیشده. هر کدام را با کد فعلی و با یک برآوردگر مرجع کوچک به روش درستنمایی بیشینهٔ حاشیهای (MML) برازش دادم. تواناییهای واقعی به برآوردگر مرجع داده نشد.
| شبیهسازی | میانگین واقعی a | میانگین a در کد فعلی | میانگین a در MML مرجع | RMSE برای a در کد فعلی | RMSE برای a در MML مرجع |
|---|---|---|---|---|---|
| 1 | 2.750 | 0.676 | 2.593 | 2.116 | 0.371 |
| 2 | 2.750 | 0.678 | 2.664 | 2.115 | 0.386 |
| 3 | 2.750 | 0.677 | 2.838 | 2.112 | 0.307 |
برآوردگر مرجع یک مقایسهگر پژوهشی کوچک بود که برای همین بررسی ساخته شد. روی توزیع توانایی N(0, 1) با کوادراتور گاوس-هرمیت انتگرال میگرفت و log(a) و b را با L-BFGS-B بهینه میکرد. ادعا ندارد که سازوکار کامل یک برنامهٔ سنجش حرفهای را دارد. افزایش نقاط کوادراتور آن از ۱۲۱ به ۱۸۱ روی دیتاست اول، بیشینهٔ a را حدود ۰٫۰۰۰۱۷ تغییر داد، پس شبکهٔ نقاط عامل نتایجش نبود. این پیادهسازی از ارزیابی GIRTH در قسمت ۴ هم جداست.
کد فعلی روی دادهای که با میانگین ۲٫۷۵ تولید شده بود، در هر سه اجرا میانگین a حدود ۰٫۶۸ برگرداند، و خطایش بیش از پنج برابر خطای مقایسهگر بود. یک سؤال این را ملموس میکند. سؤال مصنوعی ۲۹ در شبیهسازی اول a واقعی ۲٫۴۱۳۸ داشت. کد فعلی آن را ۰٫۷۰۱۴ برآورد کرد و مقایسهگر MML آن را ۲٫۴۶۰۱. بوتاسترپ مقایسهگر روی دانشآموزان یک بازهٔ تقریبی ۹۵ درصدی از ۲٫۰۵۰۷ تا ۳٫۱۲۳۸ داد، و هر ۲۰۰ برازش بوتاسترپ همگرا شدند.
آنچه این نتیجه پشتیبانی میکند: N برابر ۴۳۴ سقفی تحمیل نمیکند که قدرت تمیز را ناچار زیر یک نگه دارد. در شرایط مساعد، با مدل معلوم و دادهٔ تولیدشده، قدرت تمیز بالا را میشود در همین حجم بازیابی کرد. آنچه پشتیبانی نمیکند: اینکه سؤالهای واقعی محیط عملیاتی a واقعی نزدیک ۲٫۷۵ دارند، یا اینکه ۴۳۴ دانشآموز دقت کافی را برای هر سؤالی تضمین میکند.
چرا «۲۰۰ دانشآموز کافی است» جواب سؤال را نداد
قاعدهٔ سرانگشتی قسمت ۱ اینجا دوباره پیدایش شد، چون در ظاهر ۴۳۴ دانشآموز از آن عبور میکند. هیچ آستانهٔ حجم نمونهای دقت ضرایب را برای هر مدل و هر الگوی پاسخی تضمین نمیکند. آن N که اهمیت دارد اغلب تعداد پاسخهای قابل استفاده برای هر سؤال است، که ممکن است با تعداد ثبتنامیها یا حاضران رسمی فرق کند، همانطور که قسمت ۲ نشان داد. دقت به اینها بستگی دارد: مدل، برآوردگر، پیشین، دشواری و قدرت تمیز سؤال، اینکه دامنهٔ توانایی چقدر خوب پوشش داده شده، دادههای گمشده و سیاست برخورد با پاسخهای جاافتاده، و اینکه تصمیم چقدر دقت لازم دارد.
راهنمای منتشرشده وجود دارد. مقدمهٔ ETS بر IRT دربارهٔ حجمهای نمونهٔ تقریبی بحث میکند، با قیدهایی که وقتی راهنما به شعار تبدیل میشود معمولاً گم میشوند. برای این خط پردازش، آزمایش حجم روی سؤالهای ثابت و شبیهسازی بیشتر از هر آستانهٔ عمومی به من چیز یاد دادند. با کد محلی، ۴۳۴ دانشآموز روی سؤالهای ثابت میانگین a برابر ۰٫۷۶۶۵ داد، در برابر ۱٫۴۹۸۶ برای کل استخر ۹٬۰۹۹ نفری.
دشواری هم جابهجا شد. در همان جدول کنترلشدهٔ سؤالهای ثابت، میانگین b بین ۴۳۴ و ۹٬۰۹۹ دانشآموز از حدود ۰٫۲۷۷ به ۱٫۵۱۷ رسید. متن سؤالها با بیشتر شدن شرکتکنندگان سختتر نشد، پس این رانش به برآورد مربوط است، و هشداری است برای هر کسی که مقدارهای b آزمونهایی با حجمهای متفاوت را از این خط پردازش با هم مقایسه میکند.
توضیح تا اینجا به کجا رسید
حالا میتوانم ادعای محدودتری را با اطمینان نسبی بیان کنم. روی سؤالهای ثابت، ضرایب برآوردگر محلی با پیشین باریک بهشدت با N تغییر کردند، و بررسی حساسیت به پیشین و شبیهسازی هر دو به اثرهای پیشین و برآورد اشاره میکنند. این از یک توضیح برای همین پیادهسازی پشتیبانی میکند. نشان نمیدهد که پیشین بهتنهایی همهٔ تفاوتهای جدولهای عملیاتی را توضیح میدهد، و نتیجه نمیدهد که هر برآوردگر بیزی همین رفتار را داشته باشد. و قطعاً به این معنا نیست که دانشآموزان بیشتر قدرت تمیز یک سؤال را بالا میبرند.
سؤال بدیهی بعدی این بود که آیا برآوردگر دیگری رفتار بهتری دارد. قسمت ۴ دو برآوردگر را امتحان میکند: یک پیشین سلسلهمراتبی درون همان کتابخانه، که مشکلات جهت مقیاس خودش را به همراه آورد، و درستنمایی بیشینهٔ حاشیهای با GIRTH.
این یادداشت به انگلیسی هم منتشر شده است: نسخهٔ انگلیسی.