بنچمارکها مفیدند، اما مرتب و تمیزند. دادهٔ واقعی شلوغتر است: نمونهها کمترند، نویز بیشتر است و داده مدام از راه میرسد. این قسمت آخر مجموعه به دو بخش از پایاننامهام میپردازد که با همین واقعیت سروکار دارند. اول، شناسایی اختلال شناختی خفیف اولیه، یکی از مراحل هشدار زودهنگام آلزایمر، با تصویربرداری مغز. دوم، بهروز نگه داشتن تجزیهٔ تانسوری وقتی دادهٔ تازه جریان دارد، بدون اینکه هر بار از صفر شروع کنیم.
یک تانسور برای هر مغز
دادهها از ADNI گرفته شدهاند؛ ابتکار تصویربرداری عصبی بیماری آلزایمر، یک برنامهٔ پژوهشی بلندمدت و عمومی که دادههای تصویربرداری مغز را در اختیار پژوهشگران میگذارد. نقطهٔ شروع ۱۹۶ اسکن fMRI در حالت استراحت بود. نُه اسکن خراب بود و اسکنهایی که حرکت سر در آنها زیاد بود کنار گذاشته شدند. طبقهبندی روی دو گروه انجام شد: ۴۴ فرد با اختلال شناختی خفیف در مرحلهٔ اولیه (eMCI) و ۳۸ فرد سالم؛ در مجموع ۸۲ آزمودنی.
این جفت عمداً انتخاب شد. شناسایی آلزایمرِ پیشرفته نسبتاً ساده است. شناسایی مرحلهٔ اولیه خیلی سختتر است، چون مغز در این مرحله هنوز شباهت زیادی به مغز سالم دارد؛ و اگر هدف تشخیص زودهنگام بیماری باشد، مهمترین تفکیک هم همین است.
هر اسکن یک حجم سهبعدی از مغز (۶۴×۶۴×۴۸ وکسل) است که ۱۴۰ بار ثبت شده. پیشپردازش طبق روال معمول با SPM12 و DPARSFA انجام شد: حذف ده حجم اول تا سیگنال پایدار شود، اصلاح زمانبندی برشها و حرکت سر، و نرمالسازی همهٔ مغزها روی یک الگوی مشترک. بعد اطلس AAL مغز را به ۱۱۶ ناحیه تقسیم میکند. مطابق روال رایج در مطالعههای اتصالپذیری مغز در آلزایمر، ۲۶ ناحیهٔ مخچه را کنار گذاشتم و ۹۰ ناحیه باقی ماند.
نتیجه برای هر نفر یک ماتریس کوچک است: ۱۳۰ نقطهٔ زمانی در ۹۰ ناحیهٔ مغزی. هر ماتریس یک اسلایس جانبی از تانسور میشود، دقیقاً مثل تصویرها در قسمت چهارم، و طبقهبندی با همان روش باقیماندهٔ کلاسی (رویکرد دوم) از آن قسمت انجام میشود.
یک ترفند کوچک: کمک گرفتن از خود نمونهٔ آزمایشی
با این تعداد کم آزمودنی، پایهٔ هر کلاس از دادهٔ خیلی کمی ساخته میشود. پایاننامه برای بهرهگیری بیشتر از همین داده، ایدهٔ سادهای به کار میبرد: قبل از طبقهبندی یک اسکن جدیدِ بیبرچسب، آن را موقتاً به همهٔ کلاسها اضافه میکنیم و پایهٔ هر کلاس را دوباره حساب میکنیم. اگر اسکن واقعاً متعلق به کلاسی باشد، با ساختار آن کلاس جور درمیآید و پایهاش را تقویت میکند. اگر نباشد، سهم چندانی ندارد. هیچ فرض قبلیای دربارهٔ برچسب هم لازم نیست.
نتایج
ارزیابی به روش «یکی بیرون» (leave-one-out) انجام شد: هر بار یک نفر بهعنوان نمونهٔ آزمایشی کنار گذاشته میشود و مدل با بقیه ساخته میشود. دقتها برای تفکیک eMCI از افراد سالم در جدول زیر آمده است. ردیفهای tc-SVD و t-SVD بهترین دقت در میان kهای مختلف روی همین ارزیابیاند؛ سه ردیف دیگر روشهای شناختهشدهای هستند که مقالهٔ اصلی هرکدام کنارش آمده است:
| Method | Accuracy |
|---|---|
| tc-SVD (k = 44) | 86.5% |
| SICE + KPCA (Zhang et al., 2015) | 73.2% |
| t-SVD (k = 13) | 70.7% |
| HON (Chen et al., 2016) | 70.7% |
| SLR (Wee et al., 2012) | 65.9% |
این بزرگترین فاصلهٔ دو روش تانسوری در کل پایاننامه بود: ۱۵٫۸ واحد درصد بالاتر از t-SVD مبتنی بر FFT. اما یک قید دارد. هر دو عدد بهترین مقدار در میان kها هستند و روی همان نتایج «یکی بیرون» انتخاب شدهاند، و دقت tc-SVD به k بسیار حساس بود (قله فقط در یک مقدار k است). برای همین این نتیجه را نشانهای امیدوارکننده میدانم، نه برتری قطعی. پایاننامه دقیقاً نشان نمیدهد که چرا مرز آینهای روی این داده کمک کرد.
یک یادآوری هم لازم است، چون پای دادهٔ پزشکی در میان است. این یک مطالعهٔ کوچک است (۸۲ آزمودنی) و اینها نتایج پژوهشی روی یک مجموعهدادهاند، نه ابزار تشخیص. چیزی که نشان میدهند این است که رویکرد حافظ ساختار برای این نوع داده ارزش بررسی بیشتر دارد.
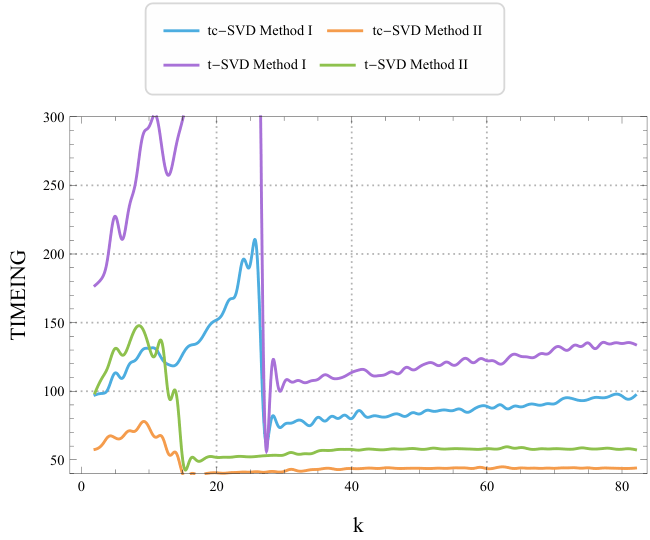
زمان اجرا روی دادهٔ fMRI برای kهای مختلف. منحنیهای tc-SVD پایینتر از نسخههای t-SVD میمانند و رویکرد دوم (باقیماندهٔ کلاسی) ارزانترین است.
وقتی داده مدام از راه میرسد
مشکل عملی دیگر این است که کلانداده بهندرت ثابت میماند. نمونههای تازه میرسند و محاسبهٔ دوبارهٔ کل تجزیه در هر بار، هدر دادن منابع است. تازه هر بار پایه هم جابهجا میشود و ویژگیهایی که دیروز حساب شدهاند دیگر با ویژگیهای امروز همخوانی ندارند.
برای ماتریسها یک راهحل شناختهشده وجود دارد: SVD افزایشی برند (۲۰۰۲). با داشتن یک SVD موجود و یک بلوک ستون جدید C:
- C را روی پایهٔ فعلی تصویر میکنیم: L = UTC؛
- باقیمانده، H = C − UL، را میگیریم و یک پایهٔ متعامد یکه J برایش پیدا میکنیم؛
- SVD یک ماتریس کوچک را حساب میکنیم که از مقادیر تکین قبلی، L و JTH ساخته شده؛
- پایههای قبلی را با نتیجه میچرخانیم تا U، S و V جدید به دست بیاید.
تنها SVD این بهروزرسانی، SVD همین ماتریس کوچک است و هزینهاش فقط به رتبه و اندازهٔ بلوک جدید بستگی دارد. تصویر کردن روی پایههای قبلی و چرخاندن آنها هم زمانی خطی بر حسب طولشان میگیرد که خیلی کمتر از محاسبهٔ دوبارهٔ کل تجزیه است.
در پایاننامه همین روش را به tc-SVD بردم. چون DCT مسئلهٔ تانسوری را به چند مسئلهٔ ماتریسی مستقل تبدیل میکند، میشود اسلایسهای تازه را تبدیل کرد، بهروزرسانی افزایشی را روی هر اسلایس روبهرو اجرا کرد و بعد به فضای اصلی برگشت. همین مراحل را به شکل کاملاً تانسوری هم نوشتهام، با ضرب tc بهجای ضرب معمولی.
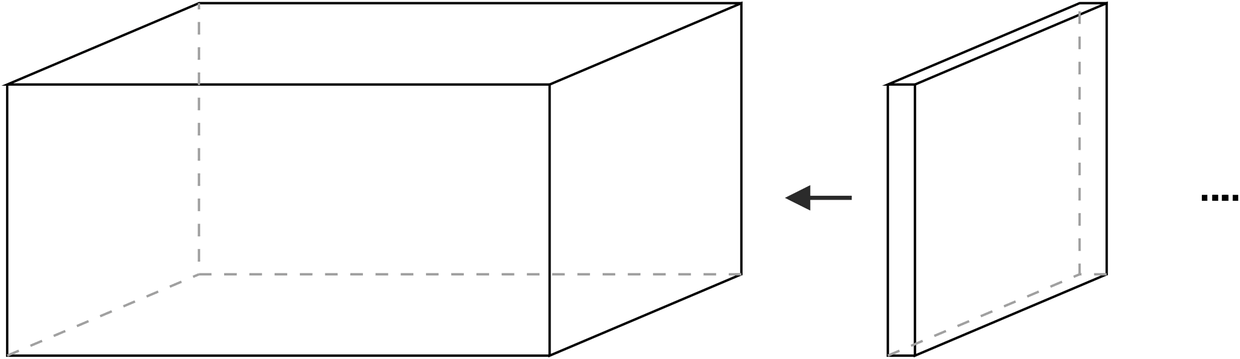
دادهٔ جریانی: اسلایسهای تازه به تانسور میپیوندند و بهجای محاسبهٔ دوباره، تجزیه بهروز میشود.
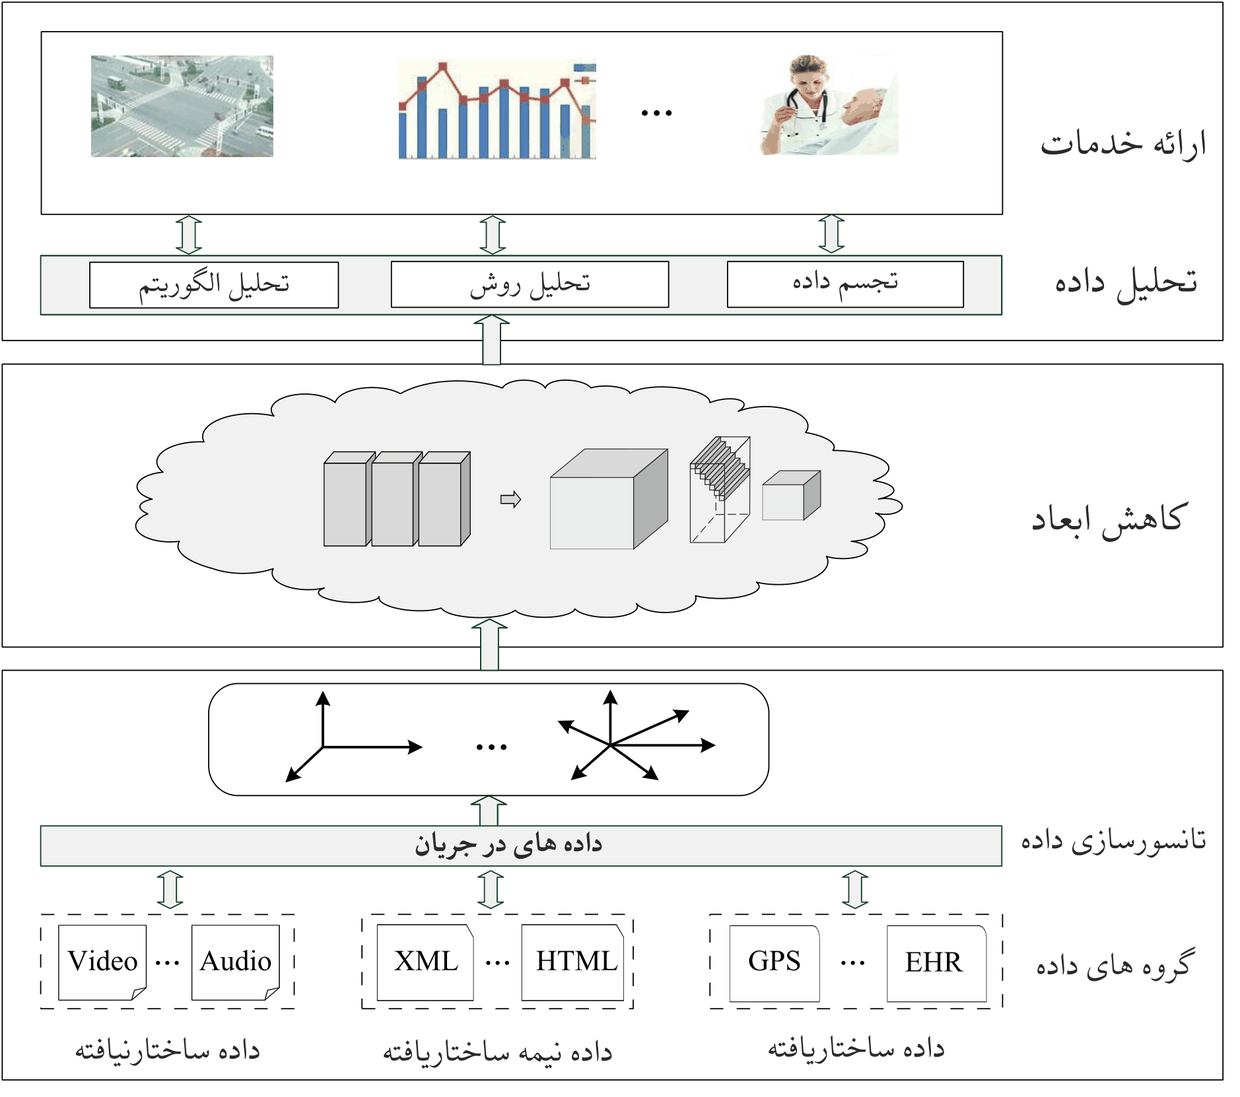
چارچوب کلی پایاننامه: از گروههای مختلف داده و تانسورسازی، تا کاهش ابعاد، تحلیل و ارائهٔ خدمات.
نگاهی به عقب
اگر همه را کنار هم بگذاریم، پایاننامه یک خط لولهٔ کوچک را توصیف میکند. داده را بهجای صاف کردن، به شکل تانسور نمایش بده. با ضربی تجزیهاش کن که شرط مرزیاش با داده جور باشد. بهجای کل داده فقط یک فضای ویژگی کاهشیافته نگه دار. روی همان فضا یاد بگیر و با رسیدن دادهٔ تازه بهروزش کن. مسیرهای بازی که آخر پایاننامه نوشتم هنوز برایم جذاباند: نسخههای برخط و چندلایهٔ این روشها، و بردن همین ایده به تجزیههای دیگری مثل NMF.
این روزها بیشتر وقتم صرف ساختن سیستمهای بکاند میشود تا نوشتن مقاله. اما عادتی که در این پژوهش پیدا کردم هنوز به کارم میآید: به شکل دادهات احترام بگذار، و چیزی را که میشود بهروز کرد از نو حساب نکن.
این قسمت پایانی مجموعهای است بر اساس پایاننامهٔ کارشناسی ارشد من، «یادگیری کلانداده با نمایش تانسوری»، به راهنمایی دکتر منصور رزقی در دانشگاه تربیت مدرس. دادههای fMRI از ابتکار تصویربرداری عصبی بیماری آلزایمر (ADNI) تهیه شدهاند.
این یادداشت به انگلیسی هم منتشر شده است: نسخهٔ انگلیسی.