Benchmark'lar faydalıdır ama derli topludur. Gerçek veri daha dağınıktır: örnek daha az, gürültü daha fazladır ve veri gelmeye devam eder. Serinin bu son notu, tezimin bu durumla ilgilenen iki kısmını ele alıyor. Birincisi, Alzheimer hastalığının erken bir uyarı evresi olan erken evre hafif bilişsel bozukluğu beyin taramalarında tespit etmek. İkincisi, yeni veri akmaya devam ederken bir tensör ayrışımını her seferinde baştan başlamadan güncel tutmak.
Her beyin için bir tensör
Veriler, beyin görüntüleme verilerini araştırmacılarla paylaşan, uzun soluklu ve kamuya açık bir araştırma programı olan ADNI'den (Alzheimer's Disease Neuroimaging Initiative) geldi. Başlangıç noktası 196 dinlenme durumu fMRI taramasıydı. Bunların dokuzu bozuktu ve baş hareketi fazla olan taramalar çıkarıldı. Sınıflandırmada iki grup kullanılıyor: erken evre hafif bilişsel bozukluğu (eMCI) olan 44 kişi ve 38 sağlıklı kontrol, toplamda 82 katılımcı.
Bu ikili bilerek seçildi. Tam gelişmiş Alzheimer hastalığını saptamak görece kolaydır. Erken evreyi saptamak çok daha zordur, çünkü o noktada beyin hâlâ sağlıklı bir beyne çok benzer; üstelik hastalığı erken yakalamak istiyorsanız asıl gereken ayrım da budur.
Her tarama, beynin 140 kez kaydedilmiş 3B bir hacmidir (64×64×48 voksel). Ön işleme, SPM12 ve DPARSFA ile olağan iş akışını izledi: sinyal oturana kadar ilk on hacmi atmak, dilim zamanlamasını ve baş hareketini düzeltmek ve her beyni ortak bir şablona normalize etmek. Ardından AAL atlası beyni 116 bölgeye ayırır. Alzheimer bağlantısallık çalışmalarındaki yaygın uygulamayı izleyerek 26 beyincik (serebellar) bölgesini dışarıda bıraktım; geriye 90 bölge kalıyor.
Sonuçta her kişi için küçük bir matris elde ediliyor: 130 zaman noktası çarpı 90 beyin bölgesi. Her matris, tıpkı dördüncü bölümdeki görüntüler gibi bir tensörün yanal dilimi oluyor ve sınıflandırmada o nottaki sınıf başına artık yöntemi (yaklaşım II) kullanılıyor.
Küçük bir numara: test örneği de yardım etsin
Bu kadar az katılımcıyla her sınıf tabanı çok az veriden oluşturuluyor. Tez, veriden daha fazlasını çıkarmak için basit bir fikir kullanıyor: yeni ve etiketsiz bir taramayı sınıflandırmadan önce onu geçici olarak her sınıfa ekleyip her sınıfın tabanını yeniden hesaplamak. Tarama gerçekten bir sınıfa aitse o sınıfın yapısına uyar ve tabanını güçlendirir. Ait değilse pek bir şey katmaz. Etiket hakkında önceden herhangi bir varsayım gerekmez.
Sonuçlar
Değerlendirme birini dışarıda bırakma (leave-one-out) yöntemiyle yapıldı: her katılımcı sırayla test örneği olarak ayrılıyor ve model geri kalan herkesle kuruluyor. Tablo, eMCI ile sağlıklı kontrollerin ayrımındaki doğrulukları gösteriyor. tc-SVD ve t-SVD satırları, bu değerlendirmede k üzerinden elde edilen en iyi doğruluktur; diğer üç satır literatürde yerleşik yöntemlerdir ve özgün makaleleriyle birlikte adlandırılmıştır:
| Yöntem | Doğruluk |
|---|---|
| tc-SVD (k = 44) | %86,5 |
| SICE + KPCA (Zhang vd., 2015) | %73,2 |
| t-SVD (k = 13) | %70,7 |
| HON (Chen vd., 2016) | %70,7 |
| SLR (Wee vd., 2012) | %65,9 |
Bu, tüm tezde iki tensör yöntemi arasındaki en büyük farktı: FFT tabanlı t-SVD'nin 15,8 puan üzerinde. Ancak bunun bir çekincesi var. Her iki değer de aynı birini dışarıda bırakma sonuçları üzerinden seçilmiş, k üzerindeki en iyi değerlerdir ve tc-SVD doğruluğu k'ye çok duyarlıydı (zirve tek bir değerde oluşuyor); bu yüzden bunu kesinleşmiş bir fark olarak değil, umut verici bir işaret olarak okuyorum. Tez, ayna sınırının bu veride neden işe yaradığını netleştirmiyor.
Tıbbi veri söz konusu olduğu için bir uyarı. Bu küçük bir çalışmadır (82 katılımcı) ve bunlar tek bir veri seti üzerinde elde edilmiş araştırma sonuçlarıdır, bir tanı aracı değildir. Yine de yapıyı koruyan yaklaşımın bu tür veriler için daha fazla incelenmeye değer olduğunu düşündürüyorlar.
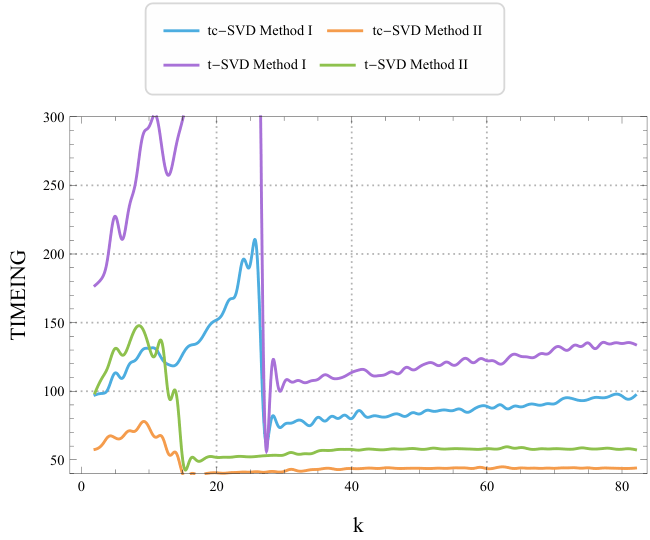
Farklı k değerleri için fMRI verisinde çalışma süresi. tc-SVD eğrileri t-SVD karşılıklarının altında kalıyor ve yaklaşım II (sınıf başına artıklar) en ucuzu.
Veri gelmeye devam ettiğinde
Diğer pratik sorun, büyük verinin nadiren yerinde durmasıdır. Yeni örnekler gelir ve her seferinde tam bir ayrışımı yeniden hesaplamak israftır. Üstelik bu, tabanı her seferinde kaydırır; dolayısıyla dün hesaplanan özellikler bugünküyle artık örtüşmez.
Matrisler için iyi bilinen bir çözüm var: Brand'in artımlı SVD'si (2002). Mevcut bir SVD ve yeni bir C sütun bloğu verildiğinde:
- C'yi mevcut tabana izdüşürürsünüz, L = UTC;
- geriye kalanı, H = C − UL, alır ve onun için ortonormal bir J tabanı bulursunuz;
- eski tekil değerlerden, L'den ve JTH'den oluşturulan küçük bir matrisin SVD'sini hesaplarsınız;
- yeni U, S ve V'yi elde etmek için eski tabanları bu sonuçla döndürürsünüz.
Güncellemedeki tek SVD bu küçük matrisinkidir; dolayısıyla maliyeti yalnızca ranka ve yeni bloğun boyutuna bağlıdır. Mevcut tabanlara izdüşürmek ve onları döndürmek, uzunluklarına göre doğrusal zaman alır; bu da tüm ayrışımı yeniden hesaplamaktan çok daha ucuzdur.
Tezde bunu tc-SVD'ye taşıdım. DCT tensör problemini birbirinden bağımsız matris problemlerine dönüştürdüğü için yeni dilimleri dönüştürebilir, artımlı güncellemeyi her ön dilimde çalıştırabilir ve sonucu geri dönüştürebilirsiniz. Aynı adımları, sıradan çarpma yerine tc-çarpımını kullanarak tamamen tensör biçiminde de yazdım.
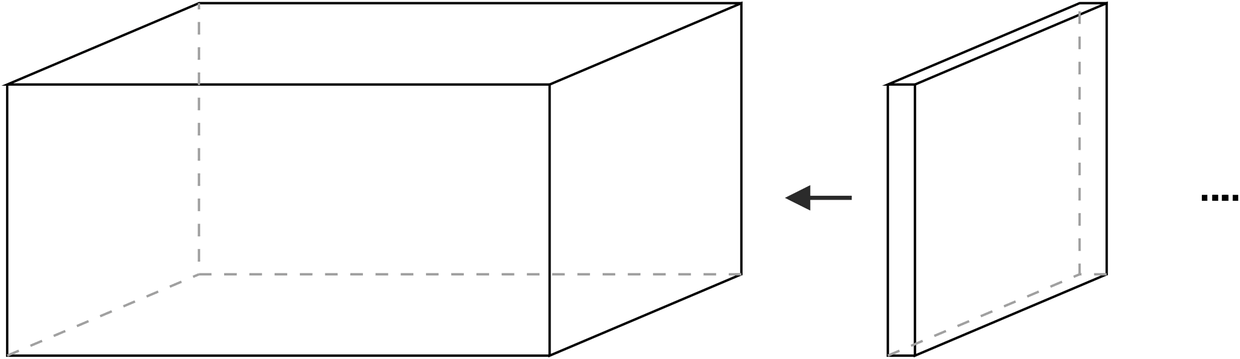
Akan veri: yeni dilimler tensöre katılıyor ve ayrışım yeniden hesaplanmak yerine güncelleniyor.
Geriye bakınca
Toparlarsak, tez küçük bir iş akışı tanımlıyor. Veriyi düzleştirmek yerine bir tensör olarak temsil edin. Onu, sınırı veriye uygun düşen bir çarpımla ayrıştırın. Verinin tamamını değil, yalnızca küçültülmüş bir özellik uzayını tutun. Öğrenmeyi bu uzayda yapın ve yeni veri geldikçe onu güncelleyin. Tezin sonunda sıraladığım açık yönler beni hâlâ ilgilendiriyor: bu yöntemlerin çevrim içi ve çok katmanlı sürümleri ve aynı fikrin NMF gibi diğer ayrışımlara uygulanması.
Bugünlerde zamanımın çoğu makale yazmaya değil, backend sistemleri geliştirmeye gidiyor. Yine de bu araştırmada edindiğim alışkanlık işe yaramaya devam ediyor: verinizin şekline saygı gösterin ve güncelleyebileceğiniz şeyi yeniden hesaplamaktan kaçının.
Bu yazı, Tarbiat Modares Üniversitesinde Dr. Mansoor Rezghi danışmanlığında hazırladığım “Tensör Temsiliyle Büyük Veri Öğrenimi” başlıklı yüksek lisans tezime dayanan serinin son bölümüdür. fMRI verileri Alzheimer's Disease Neuroimaging Initiative'den (ADNI) alınmıştır.
Bu not İngilizce ve Farsça olarak da yayımlandı: İngilizce · Farsça.