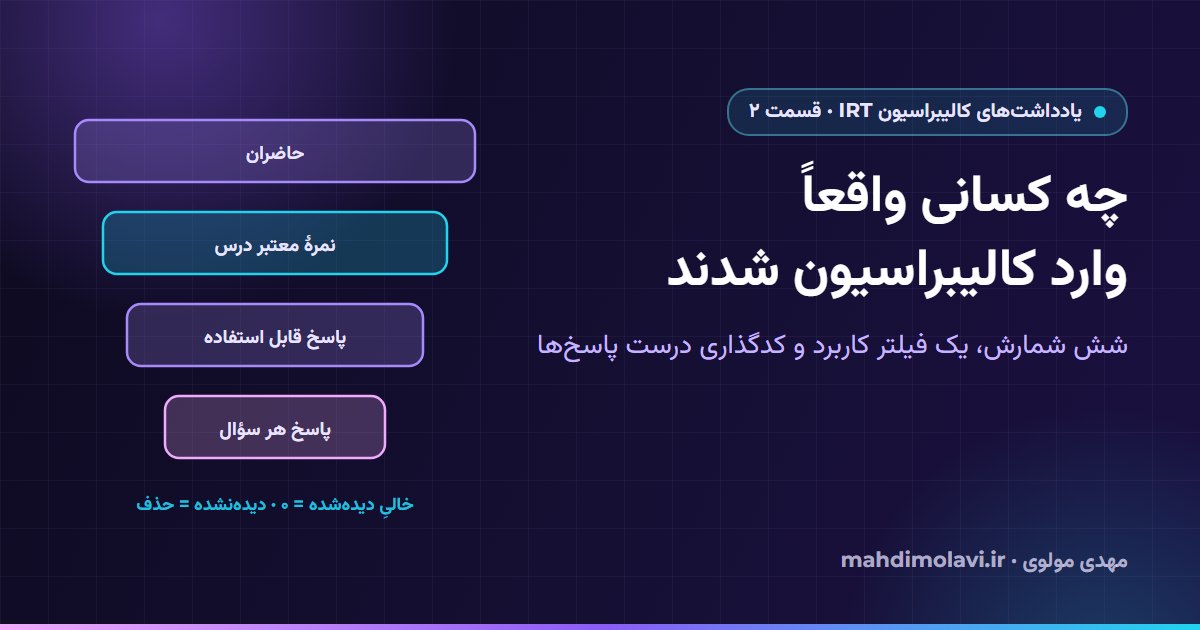
آزمون جاری علوم تجربی و درس ریاضی آن را در نظر بگیرید. در اولین بررسیِ ششآزمونی، چهار شمارش از دانشآموزان برای آن داشتم: ۵۲۱، ۵۳۰، ۵۲۲ و ۵۲۳. همهشان درست بودند. هر کدام چیز متفاوتی را میشمرد، و مقایسهٔ قسمت ۱ که بر پایهٔ حاضران رسمی بود، به عددی تکیه داشت که برآوردگر هیچوقت آن را ندید.
این قسمت دربارهٔ جمعیت است: کدام دانشآموزان و کدام پاسخها وارد کالیبراسیون شدند، و هر پاسخ اجازه داشت چه معنایی داشته باشد. بیشترش مهندسی داده است و IRT در آن نیست. با این حال همین بخش معنای ضرایب را شکل داد.
شش شمارش، همه مشروع
برای یک آزمون و یک درس، دستکم شش کمیت را میشود «تعداد دانشآموزان» نامید:
- حاضران رسمی آزمون.
- دانشآموزانی که رکورد عمومی آمار دانشآموز دارند.
- دانشآموزانی که برای همان درس نمرهٔ معتبر دارند.
- دانشآموزانی که دستکم یک پاسخ قابل استفاده در آن درس دارند.
- دانشآموزانی که یک کالیبراسیون قبلی برایشان توانایی ذخیره کرده است.
- تعداد مؤثر پاسخهای مشاهدهشده به یک سؤال مشخص.
برای آن آزمون علوم تجربی، چهار عددی که داشتم اینها بودند: ۵۲۱ حاضر رسمی، ۵۳۰ رکورد عمومی آمار دانشآموز، ۵۲۲ دانشآموز در خروجی IRT ریاضی که قبلاً ذخیره شده بود، و ۵۲۳ دانشآموز در یک استخراج تازه از پاسخهای قابل استفادهٔ ریاضی. هیچکدام را نمیشود جای دیگری گذاشت. حاضران از یک جدول خلاصه در سطح آزمون آمده بودند و عددهای درس از یک خلاصه در سطح درس، هر دو برای درخواست تحلیل فعالِ مربوط. این تجمیعها برای گزارشدهی مفیدند، ولی باز هم اجازه ندادم جای بررسی واجد شرایط بودن در سطح تکتک پاسخها را بگیرند.
آخرین شمارش فهرست برای برآوردگر از همه مهمتر است. ضریب یک سؤال از روی دانشآموزانی برازش داده میشود که آن سؤال به آنها نشان داده شده، و قسمت ۳ وقتی به قاعدهٔ «۲۰۰ دانشآموز کافی است» میپردازد به این نکته برمیگردد. حاضران رسمی فقط عددی است که پیدا کردنش از همه آسانتر است.
حتی یک تعریف واحد هم ممکن است بین اسنپشاتها جابهجا شود. یک اسنپشات اولیه ۱٬۱۳۲ حاضر در علوم انسانی گزارش کرد و بررسی بعدی ۱٬۱۳۴. مطالعهٔ نهایی نُهآزمونی مقدار بعدی را منجمد کرد. من این را مسئلهٔ نسخه و منشأ داده میدانم، و بهجای مخلوط کردن عددها، ثبت کردم که هر عدد از کدام اسنپشات آمده است.
درخواستها و هویت
در این پلتفرم هر ردیف پاسخ در انبار دادهٔ تحلیلی به یک درخواست تحلیل تعلق دارد. مسیر انتخاب پژوهشی جدولها را به این ترتیب join میکرد (اینجا هر جدول با نقشش توصیف شده است):
per-question response fact rows
    -> analysis request (active requests only)
    -> assessment question
    -> question
    -> content item id
فقط درخواستهای تحلیلِ کاملشده را پذیرفتم. هویت درخواست همراه هر استخراج ثبت شد و بعداً دوباره بررسی شد، تا هر اجرای مجدد بتواند تأیید کند که همان تحلیل را میخواند و سراغ تحلیل جدیدتری نرفته است. این شبیه کار دفترداری است و واقعاً هم همین است. همین دفترداری بود که بعدها به من اجازه داد بگویم هر عدد از کدام پاسخها آمده است.
کدام درسها شامل میشدند
وجود یک ردیف پاسخ ثابت نمیکرد که درس شامل آن دانشآموز میشود. برای شمردن یک دانشآموز در یک درس، شرط گذاشتم که در آمار درس، برای همان درخواست، همان دانشآموز و همان درسِ مشمول، نمرهٔ خامِ غیرتهی وجود داشته باشد.
علوم انسانی دلیلش را نشان میدهد. کنار درسهای استاندارد علوم انسانی، یک برنامهٔ درسی جداگانه با موضوعهای خودش هم وجود دارد. در یکی از استخراجهای قبلیِ آرشیو، درس تاریخ و جغرافیای این برنامه پیش از فیلتر شمول درس ۸٬۱۴۸ کاربر با ردیف دیدهشده داشت و بعد از آن ۳۲۸. درس عربیاش از ۸٬۳۳۵ به ۲۷۵ رسید. برای هزاران دانشآموزی که بیرون از آن دوره بودند ردیف پاسخ وجود داشت. وقتی این ورودی نامناسب برازش داده شد، برآوردهای افراطی قدرت تمیز تولید کرد، و این برآوردها در نتایج اصلاحشدهٔ برآوردگر مستقل قسمت ۴ باقی نماندند.
نمرهٔ خام در این خط پردازش یک کار داشت: تعیین شمول درس، بهعلاوهٔ مقداری گزارشدهی. هیچوقت مشاهدهٔ IRT نبود. مشاهدههایی که برازش داده شدند وضعیتهای دودویی پاسخ بودند که در بخش بعد توضیح میدهم. این را میگویم چون ستونی به اسم نمرهٔ خام کنار دادههای پاسخ، آدم را وسوسه میکند آن را ورودی مدل کند، و آنوقت با مدل دیگری سروکار داریم.
صفر یعنی چه
جدول فکت پاسخها برای هر دانشآموز و سؤال یک وضعیت پاسخ ذخیره میکند. برخورد پژوهش با این وضعیتها این بود:
| پاسخ منبع | برخورد در پژوهش |
|---|---|
| وضعیت ۱ | پاسخ درستِ مشاهدهشده، Y = 1 |
| وضعیت ۲، ۳ یا ۴ | پاسخ مشاهدهشدهٔ غیرصحیح، Y = 0 |
| وضعیت ۴: دیدهشده ولی بیپاسخ | بهعنوان صفر وارد میشود |
| وضعیت ۵: دیدهنشده | از درستنمایی کنار گذاشته میشود |
| بدون رکورد پاسخ | چیزی ساخته نمیشود و بهعنوان صفرِ مشاهدهشده هم پر نمیشود |
معمولاً این را با عبارت «فقط سؤالهایی که دانشآموز جواب داده» خلاصه میکنند، و این خلاصه غلط است. سؤالهای دیدهشده ولی بیپاسخ بهصورت صفر در داده میمانند: دانشآموز سؤال را دیده و پاسخ درستی نداده است. سؤالهای دیدهنشده کنار گذاشته میشوند، چون سؤالی که دانشآموز هرگز ندیده هیچ شاهدی دربارهٔ توانایی او به دست نمیدهد. و جایی که رکوردی نیست، چیزی اضافه نمیشود. خط پردازشی که هر خانهٔ خالی را صفر کند، نبودن داده را شکست حساب میکند، و دشواری و قدرت تمیزِ برازششده این انتخاب را بیهیچ نشانهٔ آشکاری در خودشان جذب میکنند.
یک دانشآموز فرضی اندازهٔ این انتخاب را نشان میدهد. فرض کنید فرمی ۳۰ سؤال دارد و ۲۰ تا از آنها به دانشآموز نشان داده میشود؛ ۸ تا را درست جواب میدهد، ۸ تا را غلط و ۴ تا را خالی میگذارد. با کدگذاری پژوهش، این دانشآموز ۲۰ مشاهده به درستنمایی اضافه میکند، ۸ تا یک و ۱۲ تا صفر، و ۱۰ سؤال دیدهنشده سهمی ندارند. اگر سؤالهای دیدهنشده را غلط کدگذاری کنید، همین دانشآموز ۳۰ مشاهده با ۲۲ صفر اضافه میکند. توانایی برآوردشدهاش پایین میآید، و هر کدام از آن ۱۰ سؤال حالا طوری به نظر میرسد که انگار دانشآموزی از پسش برنیامده است. این را در کل یک گروه ضرب کنید تا پارامترهای سؤال هم همراهش جابهجا شوند.
این قواعد مربوط به استخراج پژوهشیاند. همانطور که در قسمت ۱ دیدیم، مسیر مبتنی بر اجرا پاسخها را از پاسخبرگها بازسازی میکرد و میتوانست برای سؤالهای شناختهشده ردیف خالیِ صریح بسازد. فرض نکردم که خالیهای آن مسیر با این جدول همخوانی دارند.
تابع کمکیای که بهجای شما تصمیم میگیرد
کتابخانهٔ داخلی دیتاستش را از ردیفهای پاسخ با یک تابع کمکی میسازد که هر وضعیتی غیر از ۱ را به صفر تبدیل میکند. اگر ردیفهای دیدهنشده را به آن بدهید، به پاسخ غلط تبدیل میشوند. همین تابع جفتهای تکراریِ دانشآموز و سؤال را هم حذف میکند. اگر دو نسخه از یک جفت با هم اختلاف داشته باشند، یکی بیصدا باقی میماند، و اینکه کدام بماند به جزئیات داخلی تابع بستگی دارد.
هر دو رفتار برای یک کتابخانه پیشفرضهای معقولیاند و برای خط پردازشی که پیش از آن تصمیمهای خودش را نگرفته، پیشفرضهای خطرناکی. به همین دلیل ترتیب کار در جابهای پژوهشی ثابت بود: پاسخهای دیدهنشده پیش از صدا زدن تابع کمکی فیلتر میشدند، و بررسی تکراریها هم پیش از صدا زدن آن انجام میشد تا حذف تکراریها هیچوقت تصادفی اتفاق نیفتد. طرحی از این ترتیب، با نام ستونهای ساختگی:
# The library helper maps every status except 1 to 0,
# and keeps one row per (student, item) without telling you which.
rows = rows[rows["status"] != 5]            # unseen: not an observation

dupes = rows.duplicated(["student", "item"], keep=False)
if dupes.any():
    raise ValueError("duplicate student/item pairs; resolve them before fitting")

rows["y"] = (rows["status"] == 1).astype(int)   # 2, 3, 4 (incl. seen blank) -> 0
قسمت ۶ نسخهٔ طولانیتر این ماجرا را تعریف میکند. وقتی فرمهای سال جاری جایگزین شدند، نسخههای تکراری پاسخها به تعداد زیاد پیدا شدند و قاعده سختگیرانهتر شد: نسخههای سازگار را میشد بعد از یک نگاشت متعارف در هم ادغام کرد، و نسخههای متناقض اجرا را متوقف میکردند.
حریم خصوصی و اسنپشاتها
همهٔ این کار روی پاسخهای واقعی دانشآموزان انجام شد، پس چند قاعده در تمام مدت رعایت میشد. پیش از نگه داشتن هر اسنپشات ورودی پژوهشی، شناسههای دانشآموزان با اندیسهای ناشناسی جایگزین شدند که برای هر درس جداگانه تخصیص داده میشد. گزارشهای CSV خروجی شناسهٔ واقعی دانشآموزان را نداشتند. بستههای عمومی نتایج شامل ردیفهای پاسخ و بردارهای توانایی تکتک افراد نبودند. تواناییهای شبیهسازی قسمت ۳ مقدارهای تولیدشده بودند و هیچ ربطی به رکوردهای دانشآموزان نداشتند.
همهٔ کوئریها فقطخواندنی بودند. تابعهای نوشتنِ برنامهٔ منبع را خواندم تا بفهمم چه میکنند، و خط پردازش پژوهشی هیچوقت آنها را صدا نزد. کوئریها با READ UNCOMMITTED اجرا شدند تا رقابت با سیستم زنده کمتر شود. این سطح جداسازی قفل اشتراکی نمیگیرد و به همین دلیل به پایگاه دادهٔ پرمشغله فشار کمی میآورد. معنایش این هم هست که یک استخراج طولانی ممکن است ردیفهای کامیتنشده و ردیفهایی از لحظههای مختلف را بخواند، پس نتیجه اسنپشاتی از گذشته نیست که در سطح تراکنش سازگار باشد.
به همین دلیل ورودیهای منجمد اهمیت داشتند. هر استخراج همراه با هویت درخواستهایش و یک هش بهصورت محلی ذخیره شد، و هر اجرای مجددِ دقیق بهجای کوئری دوباره، فایل منجمد را میخواند. یک استخراج زندهٔ تازه بهطور مشروع ممکن است با استخراج قدیمیتر فرق کند، چون درخواستها، پاسخها و فرادادهٔ شمول درس در طول زمان تغییر میکنند. ضرایب ذخیرهشده در محیط عملیاتی همیشه اطلاعات کافی دربارهٔ منشأ درخواست با خود نداشتند تا بشود ورودی دقیقشان را بازسازی کرد، پس آنها را از برازشهای تازه جدا نگه میدارم و برای هر اختلاف بین این دو علتی از خودم نمیسازم.
این کار چه چیزی را تغییر داد
کار روی جمعیت یک دسته از ضرایب را مستقیم تغییر داد: برآوردهای افراطی آن برنامهٔ درسی جداگانه. اثر بزرگترش این بود که «N» را از یک عدد تنها به تعریفی تبدیل کرد که میتوانستم بنویسمش: درخواست تحلیل کاملشده و فعال، درسِ مشمول با نمرهٔ معتبر، دستکم یک پاسخ قابل استفاده، دیدهشدههای بیپاسخ بهصورت صفر، دیدهنشدهها کنار گذاشته، و تکراریها حلشده پیش از آنکه کتابخانه ببیندشان. با این تعریف، مقایسهٔ دو آزمون دستکم دو چیز از یک جنس را مقایسه میکند. بدون آن، جدول حاضران در قسمت ۱ نمیتوانست چیزی دربارهٔ سؤالها به من بگوید.
وقتی جمعیت مشخص شد، سراغ خود برآوردگر رفتم. قسمت ۳ به پیشین آن میپردازد، که کد اسمش را «vague» گذاشته است، و به اینکه وقتی فقط تعداد دانشآموزان تغییر میکند چه بر سر همان سی سؤال میآید.
این یادداشت به انگلیسی هم منتشر شده است: نسخهٔ انگلیسی.