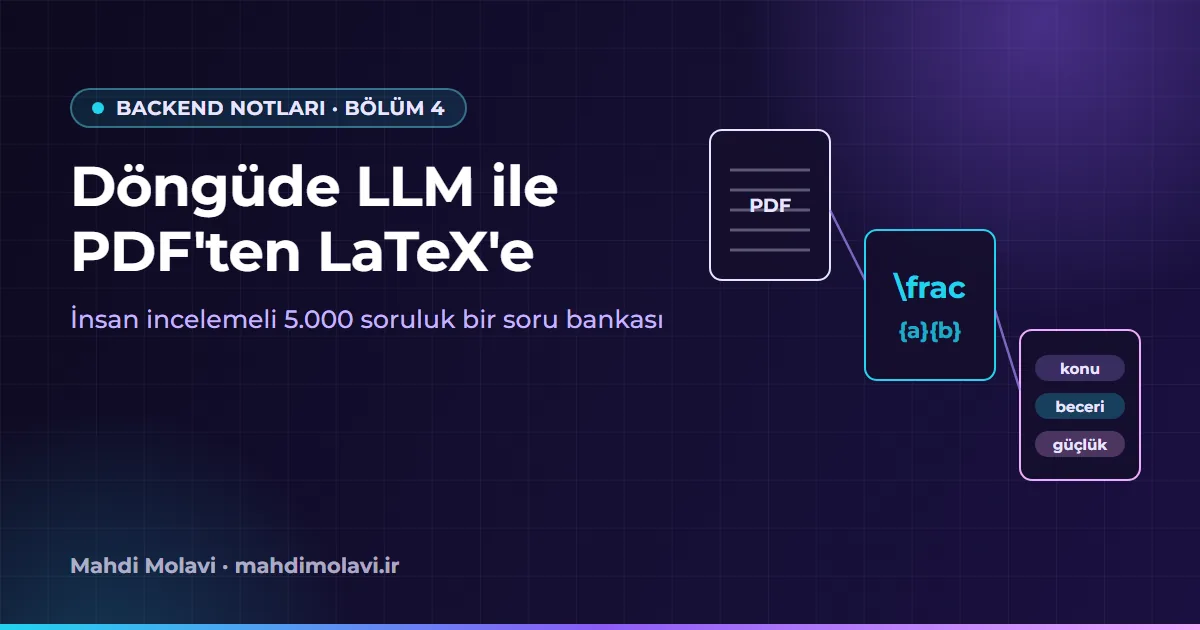
Sınav PDF'leri baskı için hazırlanır. Bir sayfa öğrenciye derli toplu görünür, ama bir program içinse sayfa, bir sorunun nerede bitip sonrakinin nerede başladığından habersiz bir yığın glif, satır parçası ve görselden ibarettir. Bir soru bankası ise her soruyu bir kayıt olarak ister: soru kökü, seçenekler, cevap, şekiller ve konu, beceri, zorluk gibi meta veriler. Sorular ancak böylece aranabilir, testlerde bir araya getirilebilir ve ileride kalibre edilebilir.
2024'te Noraco ile yaptığım uzaktan bir sözleşme kapsamında, yazılı sınavları yapılandırılmış ve veritabanına girmeye hazır sorulara dönüştüren bir pipeline'ı otomatikleştirdim; toplamda 5.000'den fazla soru. Pipeline PDF'leri LaTeX'e dönüştürüyor, konu, beceri ve zorluk meta verilerini üretmek için OpenRouter üzerinden LLM API'lerini kullanıyordu; sonunda da LaTeX doğrulama, kalite kontrol (QA) ve yayın için FastAPI servisleri ile bir React inceleme konsolu vardı. Bu not, böyle bir pipeline'ın nasıl kurulduğunu, etiketleme adımına nasıl yaklaştığımı ve insan incelemesi adımının neden isteğe bağlı olmadığını anlatıyor.
Aşamalar
- İçe alma. Orijinal dosyayı saklayın, mükerrer dosyaları yakalamak için hash'ini alın ve nereden geldiğini kaydedin: hangi sınav, hangi yıl, hangi sayfa.
- Çıkarma. Her sayfadan metni ve matematiği çıkarın; her sayfayı her durumda bir görüntü olarak da oluşturun, çünkü inceleyicilerin buna ihtiyacı olacak.
- Segmentasyon. Sayfaları sorulara ayırın ve her soruya ait olanı ona bağlayın: şekiller, ortak okuma parçaları, cevap seçenekleri.
- Dönüştürme. Her soruyu, üzerinde anlaşılmış küçük bir paket ve makro kümesiyle LaTeX'e çevirin.
- Doğrulama. Her soruyu tek başına derleyin ve sonucu kaydedin.
- Etiketleme. Bir LLM'den, kontrollü bir sözlükle sınırlı kalacak şekilde konu, beceri ve zorluk isteyin.
- İnceleme ve yayın. Bir kişi soruyu kaynakla karşılaştırır; onaylar, düzenler ya da reddeder.
Her aşama çıktısını ve durumunu, soru ve aşama sürümüyle anahtarlanmış olarak veritabanına yazar. Etiketlemedeki bir hata çıkarmanın yeniden yapılmasına yol açmaz; bir aşamanın mantığı iyileştiğinde de yalnızca o aşamayı, etkilediği sorular üzerinde yeniden çalıştırabilirsiniz. Binlerce soru söz konusu olduğunda bu özellik, herhangi bir adımın hızından daha önemlidir.
Hatalar çıkarma aşamasında başlar
PDF'ler iki türlüdür. Doğrudan dijital ortamda üretilmiş dosyaların bir metin katmanı vardır ve PyMuPDF gibi kütüphaneler metni size verir. Sorun matematiktedir: kesirler ayrı satırlar olarak çıkar, üst simgeler taban çizgisine iner, sembol fontları yanlış karakterlere eşlenir. Taranmış dosyaların ise hiç metin katmanı yoktur ve OCR gerekir; ideali, matematiği tanıyan ve doğrudan LaTeX üreten bir modeldir.
İki yol da körü körüne güvenilecek kadar sağlam değil. Vazgeçmeyeceğim kural şu: çıkarılan her sorunun yanında, pipeline'ın sonuna kadar, orijinal sayfa bölgesinin kırpılmış bir görüntüsünü tutmak. Böylece bir betiğin ya da bir kişinin sonradan verdiği her karar, sınavda gerçekte ne basıldığıyla karşılaştırılabilir.
Derleyerek doğrulama
Bir LaTeX parçası için en ucuz ve yine de işe yarayan test, onu derlemektir. Soruyu minimal bir belgeye sarın, derleyiciyi bir zaman aşımıyla çalıştırın ve log'daki hata satırlarını saklayın:
import subprocess
import tempfile
from pathlib import Path

TEMPLATE = r"""\documentclass{article}
\usepackage{amsmath,amssymb}
\begin{document}
%s
\end{document}
"""

def compile_item(body: str, timeout_s: int = 20) -> tuple[bool, str]:
    """Compile one item in isolation; return (ok, first error lines)."""
    with tempfile.TemporaryDirectory() as tmp:
        Path(tmp, "item.tex").write_text(TEMPLATE % body, encoding="utf-8")
        try:
            subprocess.run(
                ["pdflatex", "-interaction=nonstopmode", "-halt-on-error", "-no-shell-escape", "item.tex"],
                cwd=tmp, capture_output=True, timeout=timeout_s, check=False,
            )
        except subprocess.TimeoutExpired:
            return False, "timeout"
        log_path = Path(tmp, "item.log")
        log = log_path.read_text(encoding="utf-8", errors="replace") if log_path.exists() else ""
        errors = [line for line in log.splitlines() if line.startswith("!")]
        return Path(tmp, "item.pdf").exists() and not errors, "\n".join(errors[:5])
Bu yöntem eşleşmeyen süslü parantezleri, bilinmeyen makroları, eksik matematik sınırlayıcılarını ve üzerinde anlaşılan kümenin dışındaki paketleri yakalar. Anlamı yakalamaz. Düşmüş bir eksi işareti, yanlış terime bağlanmış bir üs ya da yerleri değişmiş iki seçenek kusursuzca derlenir. Başarılı bir derleme size yalnızca sorunun bozuk olmadığını söyler.
Girdiyi güvenilmez kabul edin. -no-shell-escape belgenin komut çalıştırmasını engeller, ancak LaTeX makinedeki dosyaları yine de okuyabilir. Bu yüzden derleme adımının yeri, ağ erişimi olmayan, sıkı biçimde kısıtlanmış bir container'dır; kontrolden çıkan bir makro bir worker'ı sonsuza kadar meşgul edemesin diye de bir zaman aşımı gerekir. Sorularınızda Latin dışı yazı sistemleri varsa XeLaTeX veya LuaLaTeX daha iyi bir motordur.
LLM ile etiketleme: önce şema
Etiketler ancak sabit bir sözlükten geliyorsa işe yarar. Serbest metinle "bu hangi konu?" diye sorulan bir model, her birkaç yüz soruda bir yeni bir etiket uydurur ve yalnızca bir kez geçen bir etiket arama ya da test oluşturma için değersizdir. Bu yüzden taksonomi veritabanında durur; prompt da çıktı şeması da ondan üretilir.
OpenRouter OpenAI uyumlu bir API sunar; bu yüzden standart openai Python istemcisi farklı bir base URL ile çalışır. Destekleyen modellerde, JSON şemasıyla verilen response_format çıktıyı kısıtlar. OpenRouter'ın dokümantasyonu bu kısıtın uygulanmasının sağlayıcıya göre değiştiğini açıkça belirtir, bu yüzden çıktı kodda bir kez daha doğrulanır. Bir JSON şeması skill alanının bir string listesindeki değerlerden biri olduğunu söyleyebilir; becerinin seçilen konuya ait olması gerektiği kuralını ise Pydantic ile uygulamak daha kolaydır:
import json
import os
from typing import Literal

from openai import OpenAI
from pydantic import BaseModel, Field, ValidationError, model_validator

client = OpenAI(base_url="https://openrouter.ai/api/v1", api_key=os.environ["OPENROUTER_API_KEY"])

TAXONOMY = {                      # loaded from the database in the real service
    "algebra": ["linear-equations", "quadratics", "inequalities"],
    "geometry": ["triangles", "circles", "coordinate-geometry"],
}

SYSTEM_PROMPT = (
    "You classify exam questions. Choose topic and skill only from this taxonomy:\n"
    + json.dumps(TAXONOMY, indent=2)
    + "\nDifficulty is your estimate for the target students: easy, medium or hard."
    " If no skill fits well, choose the closest one and set needs_review to true."
    " Keep the rationale to two sentences."
)

SCHEMA = {
    "type": "object",
    "properties": {
        "topic": {"type": "string", "enum": sorted(TAXONOMY)},
        "skill": {"type": "string", "enum": sorted({s for v in TAXONOMY.values() for s in v})},
        "difficulty": {"type": "string", "enum": ["easy", "medium", "hard"]},
        "needs_review": {"type": "boolean"},
        "rationale": {"type": "string"},
    },
    "required": ["topic", "skill", "difficulty", "needs_review", "rationale"],
    "additionalProperties": False,
}

class ItemTags(BaseModel):
    topic: str
    skill: str
    difficulty: Literal["easy", "medium", "hard"]
    needs_review: bool
    rationale: str = Field(max_length=500)

    @model_validator(mode="after")
    def skill_belongs_to_topic(self):
        if self.skill not in TAXONOMY.get(self.topic, []):
            raise ValueError(f"skill '{self.skill}' is not under topic '{self.topic}'")
        return self

def tag_item(item_latex: str, model: str) -> ItemTags | None:
    messages = [{"role": "system", "content": SYSTEM_PROMPT},
                {"role": "user", "content": item_latex}]
    for _ in range(2):                                   # one retry, showing the model its error
        resp = client.chat.completions.create(
            model=model,
            temperature=0,
            messages=messages,
            response_format={"type": "json_schema",
                             "json_schema": {"name": "item_tags", "strict": True, "schema": SCHEMA}},
        )
        raw = resp.choices[0].message.content or ""
        try:
            return ItemTags.model_validate_json(raw)
        except ValidationError as err:
            messages += [{"role": "assistant", "content": raw},
                         {"role": "user", "content": f"Invalid output: {err}. Answer again with valid JSON."}]
    return None                                          # goes to the review queue untagged
Bazı tasarım tercihleri bilinçli. Model, her sorunun taksonomiye uyuyormuş gibi davranmaya zorlanmak yerine açık bir çıkış yolu alır: needs_review. Modelin kendi bildirdiği belirsizlik iyi kalibre edilmiş değildir; bu yüzden bu bayrak inceleme kuyruğuna soru ekleyebilir ama oradan asla soru çıkaramaz. Gerekçe kısadır ve inceleyiciye etiketlerin yanında gösterilir. Temperature 0 çeşitliliği azaltır ama çıktıyı deterministik yapmaz; bu yüzden her sonuç model kimliği, prompt sürümü ve ham yanıtla birlikte saklanır. Model ya da prompt değiştiğinde, geçiş yapmadan önce daha önce incelenmiş sabit bir soru kümesini yeniden çalıştırın ve sonuçları karşılaştırın.
Modellerin yanıldığı yerler
Bunların hiçbiri sıra dışı değil; hepsi modelin neyi görüp neyi göremediğinden kaynaklanıyor.
- Zorluk. Bir modelin "zor" dediği, sizin öğrencileriniz için "zor" olan değildir. Gerçek zorluk yanıt verisinden gelir: uyarlamalı test notundaki b parametresi. Bir LLM tahmini, ilk testleri oluşturmak için makul bir önsel (prior) ve inceleyiciler için kullanışlı bir sıralama anahtarıdır; yanıtlar oluşur oluşmaz yerini kalibrasyona bırakmalıdır.
- Komşu kategoriler. İkinci dereceden bir denklem üzerinden çözülen bir eşitsizlik iki beceriden herhangi birinin altına girebilir. İki öğretmenin bir soru hakkında anlaşamayacağı yerde model de o soru konusunda tutarsız olacaktır. Taksonomiyi net tanımlar ve örneklerle düzeltmek, prompt'u yeniden yazmaktan daha çok işe yarar.
- Eksik bağlam. Bir şekle, ortak bir okuma parçasına ya da "3. soruya verdiğiniz cevaba" atıf yapan bir soru tek başına etiketlenemez, hatta kullanılamaz. Bu, etiketleme adımında ortaya çıkan bir segmentasyon sorunudur.
- Makul görünen ama yanlış dönüşüm. Modeller doğru görünen LaTeX üretmekte iyidir. OCR ya da model gösterimi sessizce "düzelttiğinde" sonuç derlenir ve rahat okunur; bunu yalnızca kaynakla karşılaştırma yakalar.
İnceleme konsolu
Son aşamanın bir insan olmasının ve konsolun gerçek bir mühendislik emeğini hak etmesinin nedeni bu. İyi bir inceleme ekranı dört şeye dayanır: bir yanda orijinal sayfanın kırpılmış görüntüsü, diğer yanda render edilmiş LaTeX, derleme durumunu gösteren bir LaTeX düzenleyicisi ve modelin gerekçesiyle birlikte önerilen etiketler. Eylemler onaylamak, düzenlemek ya da reddetmektir.
Ekranın arkasında birkaç kural bankayı güvenilir tutar:
- Her sorunun çıkarıldı, doğrulandı, etiketlendi, incelemede, onaylandı ve yayımlandı gibi açık bir durumu vardır ve API yalnızca geçerli geçişlere izin verir.
- Bir düzenleme doğrulamayı yeniden tetikler; onay için başarılı bir derleme gerekir.
- Yayımlama, sorunun inceleyicinin adını taşıyan yeni bir sürümünü yazar; böylece bankanın bir denetim izi olur.
- Kuyruk sıralıdır: önce derlenemeyen ve
needs_reviewişaretli sorular, ardından modelin emin olduğu sorulardan rastgele bir örneklem. Sistematik hataları, yani bir modelin tam bir kararlılıkla yaptığı türden hataları, emin olunan soruları örnekleyerek bulursunuz. - Derleme ve LLM çağrısı gibi yavaş işler isteğin içinde değil, arka plan worker'larında çalışır; böylece yeni bir batch işlenirken konsol hızlı kalır.
Bu pipeline'da LLM, inceleyicinin işini meta veri yazmaktan onu kontrol etmeye kaydırır; kontrol gerçekten yapıldığı sürece bu daha hızlı ve daha az yorucudur. Elinizde, döngüde bir modelle yapılandırılmış veriye dönüşmesi gereken bir belge yığını varsa, bu üstlendiğim türden bir iş. Bir sonraki not kişisel: tensör araştırmasından backend mühendisliğine geçişin bana öğrettikleri.
Bu not İngilizce ve Farsça olarak da yayımlandı: İngilizce · Farsça.