

ترافیک بیشتر سایتها از ساعت پیروی میکند؛ ترافیک سامانههای آزمون از تقویم. چند هفته همهچیز آرام است، بعد درست در ساعتی که روی کارت ورود به جلسه چاپ شده، دهها هزار دانشآموز در یک دقیقه یک آزمون را باز میکنند. میانگین بار ماهانه دربارهٔ آن یک دقیقه چیزی نمیگوید، و آن یک دقیقه تنها چیزی است که همه به خاطر میسپارند.
در «گزینه دو» یک ساختار با دسترسپذیری بالا بر پایهٔ Redis Sentinel طراحی و راهاندازی کردم که در اوج آزمونها ۴۵٬۰۰۰ تا ۷۰٬۰۰۰ کاربر همزمان را تحمل میکرد. این یادداشت دربارهٔ منطق چنین ساختاری است: Sentinel چه کاری میکند، کجا Redis Cluster انتخاب بهتری است، کلاینت .NET را چطور باید تنظیم کرد، و عادتهایی در کش و تست که از خود معماری مهمترند.
شکل مسئله
دو ویژگی سامانهٔ آزمون را از بقیه جدا میکند. اول اینکه اوج ترافیک همزمان است؛ همه با هم میآیند، چون آزمون ساعت شروع دارد. دوم اینکه اوج قابل پیشبینی است؛ تاریخش را از هفتهها قبل میدانید، پس میشود کش را از قبل گرم کرد، تست بار اجرا کرد و استقرارهای پرریسک را متوقف کرد.
همین همزمانی است که به کش ضربه میزند. در دقیقهٔ اول همه چند چیز ثابت را میخواهند: تعریف آزمون، بخشهایش، مجموعهٔ سؤالها و قواعد زمانبندی. اگر این کلیدها سرد باشند یا همزمان منقضی شوند، همهٔ درخواستها یکجا به SQL Server سرازیر میشوند. اگر هم نود اصلی Redis درست در همین بازه از کار بیفتد، یک رپلیکا باید ظرف چند ثانیه جایش را بگیرد، بیآنکه کسی رشتهٔ اتصال را دستی عوض کند.
Sentinel چه میکند و چه نمیکند
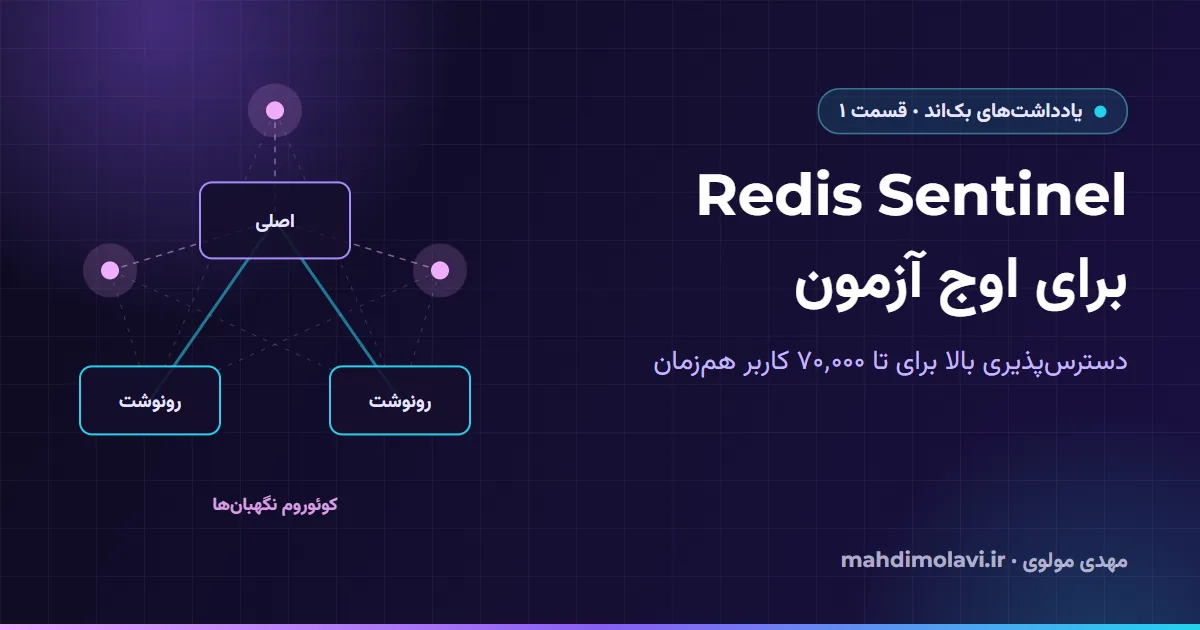
Redis Sentinel فرایندی جداست که کنار سرورهای Redis اجرا میشود. یک استقرار معمولی یک نود اصلی دارد، یک یا چند رپلیکا، و دستکم سه Sentinel روی ماشینهای مستقل. از کارهای Sentinel، این چهار کار اینجا مهماند:
- پایش. هر Sentinel مدام نود اصلی و رپلیکاها را پینگ میکند. اگر نود اصلی بیشتر از
down-after-millisecondsجواب ندهد، آن Sentinel از دید خودش آن را از کار افتاده علامت میزند. - توافق. وقتی به تعداد حد نصابی که تنظیم کردهاید Sentinel با هم موافق باشند، نود اصلی بهطور قطعی از کار افتاده شناخته میشود.
- فیلاوور خودکار. Sentinelها از بین خودشان یک رهبر انتخاب میکنند؛ رهبر مناسبترین رپلیکا را به نود اصلی ارتقا میدهد و بقیهٔ رپلیکاها را به آن وصل میکند. این انتخاب به رأی اکثریت کل Sentinelها نیاز دارد و برای همین حداقلِ عملی سه Sentinel است.
- کشف سرویس. کلاینتها آدرس نود اصلی را در کد نمینویسند؛ از Sentinelها میپرسند نود اصلیِ فلان سرویس کیست و با تغییر جواب، دنبالش میروند.
کاری که Sentinel نمیکند، ماندگار کردن داده است. تکثیر در Redis ناهمزمان است؛ یعنی نوشتنی که نود اصلی قبلی تأییدش کرده ممکن است هیچوقت به رپلیکایی که ارتقا پیدا میکند نرسد، و مستندات Redis هم صریحاً همین را میگوید. برای کش این قابل قبول است، به شرطی که هر چیزی در Redis از منبع اصلی داده قابل بازسازی باشد. اگر از دست رفتن یک نوشتن واقعاً گران تمام میشود، جای آن نوشتن اول در SQL Server است.
Sentinel یا Cluster؟
Redis Cluster مسئلهٔ دیگری را حل میکند. فضای کلیدها را با ۱۶٬۳۸۴ اسلات هش بین چند نود اصلی تقسیم میکند و هر کدام رپلیکاهای خودش را دارد؛ پس حافظه و ظرفیت نوشتنی بیش از توان یک ماشین در اختیار دارید. هزینهاش چند محدودیت است: دستورهای چندکلیدی، تراکنشها و اسکریپتهای Lua فقط وقتی کار میکنند که همهٔ کلیدها در یک اسلات باشند، پس طراحی کلیدها حول hash tag میچرخد، مثل {exam:42}:sections. فقط دیتابیس شمارهٔ صفر وجود دارد و جابهجایی اسلاتها هم عملیاتی میشود که تیم باید بر آن مسلط باشد.
قاعدهٔ سرانگشتی من: اگر دادهٔ پرکاربرد راحت در حافظهٔ یک ماشین جا میشود و یک نود اصلی از پس نرخ دستورها برمیآید، Sentinel سادهتر و کمخطرتر است. کش سامانههای آزمون معمولاً همین شکل را دارد: دادهٔ داغ محتوای تعداد محدودی آزمون است که خیلیها همزمان میخوانندش و بار بیشتر خواندنی است تا نوشتنی. وقتی سراغ Cluster بروید که اندازهگیری نشان دهد یک نود اصلی واقعاً سقف کار است. خواندن از رپلیکا با CommandFlags.PreferReplica هم یک راه میانه است، برای دادهای که کمی کهنه بودنش ضرری ندارد.
تنظیم StackExchange.Redis برای Sentinel
در StackExchange.Redis بهجای سرورهای Redis آدرس Sentinelها را میدهید و نام سرویس را مطابق sentinel.conf تعیین میکنید. مقداردهی ServiceName کلاینت را به حالت Sentinel میبرد: نود اصلی فعلی را از Sentinelها میپرسد، به آن وصل میشود و اگر فیلاوور رخ دهد، خودش اتصال را به نود جدید منتقل میکند.
using StackExchange.Redis;

var options = new ConfigurationOptions
{
    ServiceName = "exam-cache",      // matches "sentinel monitor exam-cache ..." in sentinel.conf
    AbortOnConnectFail = false,      // keep retrying in the background instead of failing startup
    ConnectTimeout = 5000,
    SyncTimeout = 2000,
};
options.EndPoints.Add("sentinel-1", 26379);
options.EndPoints.Add("sentinel-2", 26379);
options.EndPoints.Add("sentinel-3", 26379);

var redis = ConnectionMultiplexer.Connect(options);
redis.ConnectionFailed += (_, e) =>
    Log.Warning("Redis connection failed: {EndPoint} {FailureType}", e.EndPoint, e.FailureType);
redis.ConnectionRestored += (_, e) =>
    Log.Information("Redis connection restored: {EndPoint}", e.EndPoint);

builder.Services.AddSingleton<IConnectionMultiplexer>(redis);
ConnectionMultiplexer برای این ساخته شده که یک بار ایجاد شود و همه از آن استفاده کنند، پس Singleton است؛ ساختن یک نمونه برای هر درخواست راه کلاسیک تمام کردن سوکتهاست. AbortOnConnectFail = false نمیگذارد قطعی Redis هنگام بالا آمدن، کل سرویس را زمین بزند (در کلاینت فعلی نسخهٔ 3.x؛ در نسخهٔ 2.x با Sentinel، اگر هیچ Sentinelی جواب ندهد، اولین اتصال باز هم ممکن است استثنا بدهد). ثبت رویدادهای اتصال در لاگ (در کار من با Serilog) بعداً که بخواهید بفهمید حین فیلاوور چه گذشت، یک خط زمانی دستتان میدهد. احراز هویت و TLS هم روی همین شیء تنظیم میشوند و مقدارشان از پیکربندی خوانده میشود.
بعد فیلاوور را عمداً امتحان کنید. وسط یک تست بار در محیط staging نود اصلی را متوقف کنید و چند ثانیهٔ بعد را تماشا کنید. بعضی درخواستها حین جابهجایی خطا میگیرند. کدی که از کش میخواند باید خطای Redis را مثل نبودن داده در کش (miss) حساب کند، نه اینکه خطای ۵۰۰ برگرداند؛ اما هر miss یعنی یک کوئری به پایگاهداده، درست وقتی که پایگاهداده بیش از همیشه به محافظت نیاز دارد.
الگوی cache-aside بدون هجوم همزمان
الگوی رایج cache-aside است: از Redis بخوان، اگر نبود از پایگاهداده بار کن و با یک TTL در کش بنویس. نقطهٔ ضعفش لحظهٔ miss است: وقتی کلیدی پرطرفدار منقضی میشود، همهٔ درخواستها با هم سراغ پایگاهداده میروند؛ همان cache stampede. سه دفاع کنار هم خوب جواب میدهند:
- قفل. فقط یک فراخواننده کلید را از نو میسازد و بقیه کمی صبر میکنند و نتیجه را میخوانند.
- تازهسازی زودهنگام. کلیدهای داغ کمی قبل از انقضا، با یک کار پسزمینه یا بهصورت احتمالی هنگام خواندن، تازه میشوند تا هیچوقت سرد نشوند.
- نوسان تصادفی (jitter). به هر TTL مقدار تصادفی کوچکی اضافه میشود تا کلیدهایی که با هم نوشته شدهاند با هم منقضی نشوند.
این نسخهٔ جمعوجور دفاع اول و سوم است:
public sealed class CacheAside(IConnectionMultiplexer redis)
{
    private readonly IDatabase _db = redis.GetDatabase();

    public async Task<T> GetOrLoadAsync<T>(
        string key, TimeSpan ttl, Func<CancellationToken, Task<T>> load, CancellationToken ct)
    {
        var cached = await _db.StringGetAsync(key);
        if (cached.HasValue)
            return JsonSerializer.Deserialize<T>(cached.ToString())!;

        var lockKey = $"lock:{key}";
        var token = Guid.NewGuid().ToString("N");

        if (await _db.LockTakeAsync(lockKey, token, TimeSpan.FromSeconds(10)))
        {
            try
            {
                cached = await _db.StringGetAsync(key);      // another caller may have filled it
                if (cached.HasValue)
                    return JsonSerializer.Deserialize<T>(cached.ToString())!;

                var value = await load(ct);
                await _db.StringSetAsync(key, JsonSerializer.Serialize(value), WithJitter(ttl));
                return value;
            }
            finally
            {
                await _db.LockReleaseAsync(lockKey, token);
            }
        }

        for (var i = 0; i < 20; i++)                          // someone else is loading: wait for it
        {
            await Task.Delay(50, ct);
            cached = await _db.StringGetAsync(key);
            if (cached.HasValue)
                return JsonSerializer.Deserialize<T>(cached.ToString())!;
        }
        return await load(ct);                                // stop waiting and load directly
    }

    private static TimeSpan WithJitter(TimeSpan ttl) =>
        ttl + TimeSpan.FromMilliseconds(Random.Shared.Next(0, (int)(ttl.TotalMilliseconds * 0.1)));
}
این قفل فقط بار را کم میکند؛ اگر جایی کار نکند، دو فراخواننده یک داده را بار میکنند و چیزی خراب نمیشود، و وقتی کار کند، هزار کوئری یکسان یکی میشود. اگر وابستگی تازه برایتان مشکلی ندارد، HybridCache (بستهٔ Microsoft.Extensions.Caching.Hybrid که همراه .NET 9 معرفی شد و نسخهٔ پایدارش از مارس ۲۰۲۵ در دسترس است؛ روی .NET 8 هم کار میکند) جلوی هجوم همزمان را در سطح هر پروسه میگیرد و یک لایهٔ حافظهٔ محلی هم جلوی Redis میگذارد.
برای داغترین کلیدها ترجیح میدهم اصلاً به انقضا تکیه نکنم. اگر آزمونی فردا صبح شروع میشود، یک کار پسزمینه همین امشب تعریف و سؤالهایش را در Redis مینشاند و با هر انتشار دوباره تازهشان میکند. انقضا فقط وقتی اهمیت پیدا میکند که این کار پسزمینه شکست بخورد.
TTL و چیزهایی که نباید کش کرد
TTL یعنی اعلام اینکه حاضرید چقدر و تا کی اشتباه باشید. محتوایی که فقط با انتشار عوض میشود، مثل تعریف آزمون و متن سؤالها، میتواند TTL طولانی داشته باشد، به شرط اینکه موقع انتشار صریحاً باطل شود. آمار و رتبهبندیهایی که دورهای دوباره محاسبه میشوند باید همپای همان دورهٔ محاسبه منقضی شوند. دادهٔ مرجع کوچک میتواند عمر طولانی داشته باشد، ترجیحاً با یک کش درونپروسهای جلوی Redis، چون رفتوبرگشت شبکه هر چقدر هم سریع باشد، هزینه دارد.
بعضی چیزها را هم یا کش نمیکنم یا هیچوقت تنها نسخهشان را در کش نگه نمیدارم:
- پاسخهای ثبتشده، نمرهها و هر چیز مالی. یک فیلاوور میتواند آخرین نوشتنها را از بین ببرد. سند اصلی پایگاهداده است و کش فقط یک رونوشت.
- تصمیمهای وابسته به زمان. باز بودن پنجرهٔ آزمون یا زمان باقیماندهٔ یک دانشآموز باید از ساعت سرور و وضعیت ماندگار بیاید.
- دادهای که کم تکرار میشود. مقداری که هر کاربر یک بار میخواند فقط حافظه میخورد و نرخ اصابت را پایین میآورد.
- مقدارهای حجیم. Redis دستورها را یکییکی اجرا میکند، پس یک مقدار بزرگ بقیهٔ کلاینتها را منتظر میگذارد و پهنای باند را درست وقتی میخورد که چیزی از آن باقی نمانده.
اوج را از قبل تمرین کنید
اوجی که قابل پیشبینی است قابل تمرین هم هست. در «گزینه دو» با تستهای بار Locust گلوگاهها را پیش از رسیدن اوج آزمونها پیدا میکردم. سناریوهای Locust کد سادهٔ پایتوناند، نوشتن و بازبینیشان آسان است و میتوانند همان الگوی «همه با هم میرسند» را بسازند که برای آزمونها مهم است. یک سناریوی حداقلی روی API محیط staging:
import random
from locust import HttpUser, task, between

class ExamTaker(HttpUser):
    wait_time = between(5, 20)          # students read before they answer

    def on_start(self):
        resp = self.client.post("/api/exams/demo/sessions", name="start session")
        self.session_id = resp.json()["sessionId"]

    @task(1)
    def exam_info(self):
        self.client.get("/api/exams/demo", name="exam info")

    @task(5)
    def next_question(self):
        self.client.get(f"/api/sessions/{self.session_id}/next", name="next question")

    @task(5)
    def answer(self):
        self.client.post(f"/api/sessions/{self.session_id}/answers",
                         json={"choice": random.randint(1, 4)}, name="submit answer")
locust -f exam_day.py --headless --host https://staging.example.com \
       -u 5000 -r 500 --run-time 20m --csv exam_day
اندپوینتها و عددها نمونهاند؛ عدد واقعی را از تعداد ثبتنامیهای همان آزمون دربیاورید، و وقتی یک ماشین بار کافی تولید نمیکند، Locust را توزیعشده با --master و --worker اجرا کنید. نرخ اضافه شدن کاربرها به اندازهٔ تعدادشان مهم است، چون لحظهٔ خطرناک شیب بالا رفتن بار است؛ وقتی کشها هنوز سردند و connection poolها تازه دارند بزرگ میشوند. به صدکها نگاه کنید، نه میانگین، و حین تست Redis و SQL Server را هم بپایید. میانگین همان درخواستهای کندی را پنهان میکند که دانشآموز را به رفرش صفحه وامیدارند، و هر رفرش بار بیشتری است.
SQL Server هنوز در مسیر داغ است
Redis بار خواندن را از دوش SQL Server برمیدارد، ولی نوشتنها و missها همچنان به آنجا میرسند و درست بعد از فیلاوور، پایگاهداده مدتی کل بار خواندن را تنها به دوش میکشد. در «گزینه دو» کنار کار روی Redis، کوئریهای SQL Server، مسیرهای کش و APIهای پرترافیک را هم بهینه کردم. روش تقریباً همیشه یکی است: کوئریهای پشت اندپوینتهای داغ را پیدا کنید (Query Store راحتترین نقطهٔ شروع است)، برای هر کدام ایندکسی بسازید که کاملاً پوششش دهد، و کارهایی را که درخواست به آنها نیازی ندارد حذف کنید.
در EF Core خواندنهای داغ را بهجای بار کردن کل موجودیت، مستقیم به DTOهای کوچک نگاشت کنید (projection) و هر جا موجودیت را فقط برای خواندن بار میکنید، AsNoTracking بگذارید. برای کوئریهایی که در هر درخواست اجرا میشوند، کوئری کامپایلشده کمک میکند:
private static readonly Func<ExamDbContext, int, Task<ExamSummary?>> GetExamSummary =
    EF.CompileAsyncQuery((ExamDbContext db, int examId) =>
        db.Exams
          .Where(e => e.Id == examId)
          .Select(e => new ExamSummary(e.Id, e.Title, e.StartsAtUtc, e.DurationMinutes))
          .FirstOrDefault());
EF Core خودش ترجمهٔ کوئریها را کش میکند، ولی برای پیدا کردن نسخهٔ کششده باز هم در هر فراخوانی درخت عبارت را بررسی میکند؛ کوئری کامپایلشده همین مرحله را حذف میکند. صرفهجویی هر درخواست کم است، اما روی اندپوینتی که همه در یک دقیقه صدایش میزنند، روی هم جمع میشود. قبل و بعد از تغییر اندازه بگیرید؛ اگر پروفایلر هیچوقت آمادهسازی کوئری را پرهزینه نشان نداده، کد را ساده نگه دارید.
اگر سامانهٔ شما هم چنین اوج تقویمی دارد و نگاه دومی از بیرون لازم دارد، این از جنس کارهای بکاند و بهینهسازی کارایی است که انجام میدهم. یادداشت بعدی سراغ آزمونهای تطبیقی میرود، جایی که سرور هر سؤال بعدی را خودش انتخاب میکند.
این یادداشت به انگلیسی هم منتشر شده است: نسخهٔ انگلیسی.